MCP 完全指南:原理、远程调用链路与自建服务接入 Agent
大模型会“思考”和生成文本,却不知道你公司今天新增了哪个项目,也不能凭空替你创建工单。MCP 做的事,是用一套标准协议把这些外部数据和动作安全地接到 Agent 身边。
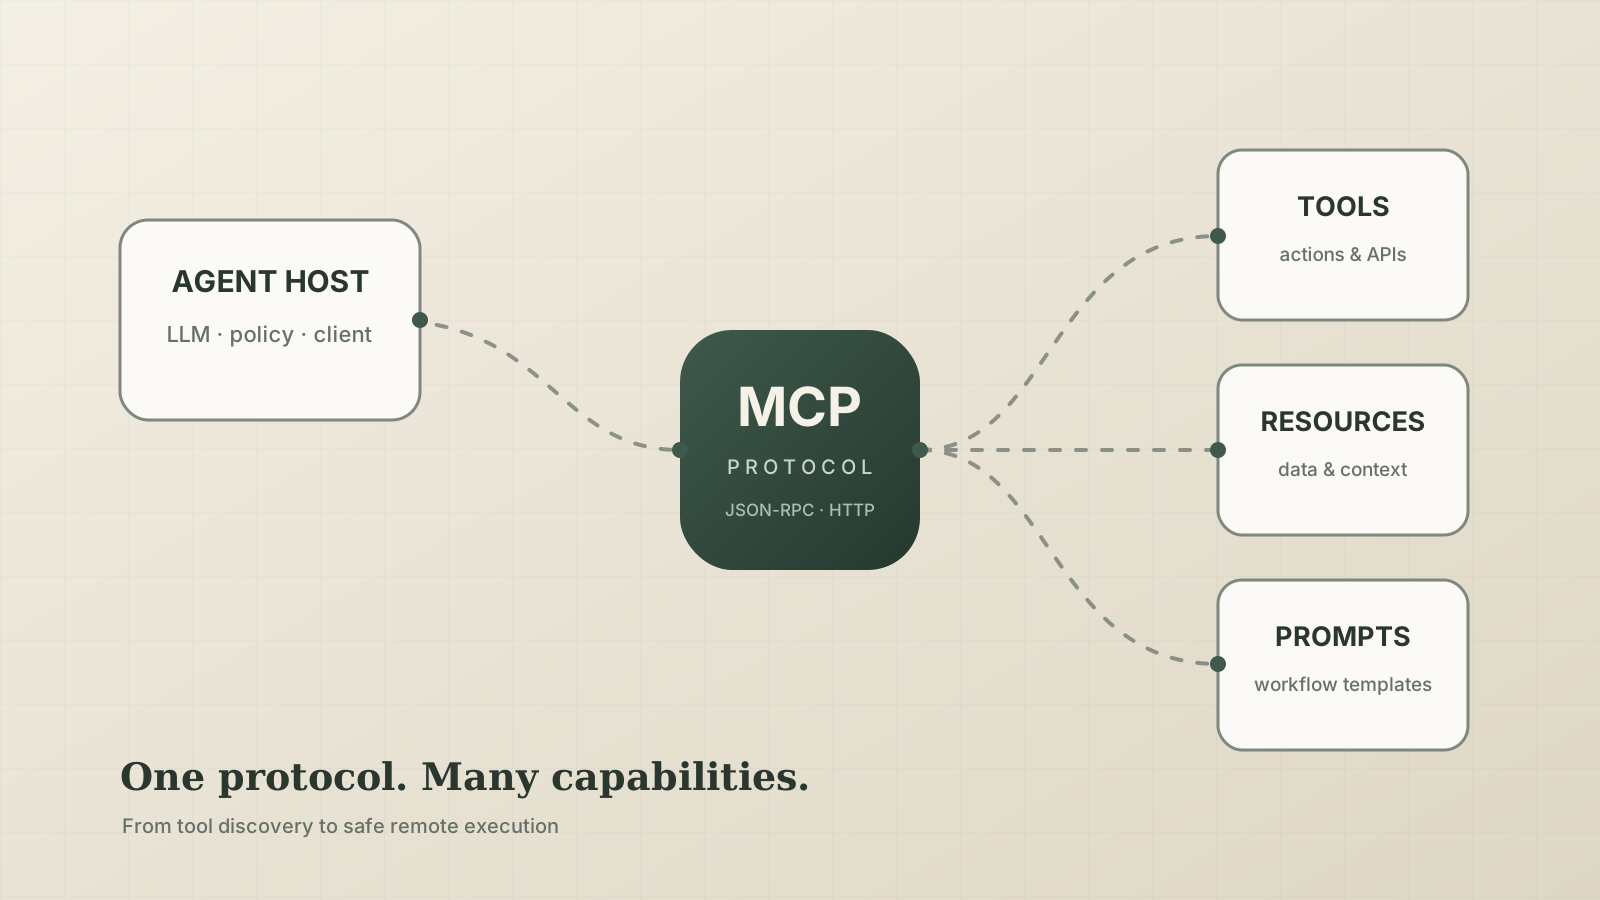
如果只记一句话,可以记住:
MCP(Model Context Protocol,模型上下文协议)是 Agent 应用与外部能力之间的标准接口。它规定如何发现能力、描述参数、发起调用、返回结果与协商权限;它不是模型,也不是新的业务 API。
本文按 2026-07-28 版 MCP 规范讲解,同时标出旧版客户端常见的初始化与会话差异。协议仍在快速演进,真正接入时应以所用 Host 和 SDK 支持的版本为准。
一、为什么需要 MCP
没有 MCP 时,每个 Agent 平台都有一套插件格式。若要让三个 Agent 连接 GitHub、数据库和内部工单系统,往往需要写九份适配代码:
MCP 把“Agent 如何使用外部能力”从具体平台中抽了出来。它带来的核心价值不是少写一次 HTTP 请求,而是统一了以下契约:
| 问题 | MCP 给出的统一方式 |
|---|---|
| 服务有什么能力 | tools/list、resources/list、prompts/list |
| 参数长什么样 | JSON Schema |
| 怎样执行动作 | tools/call |
| 怎样读取上下文 | resources/read |
| 怎样返回结果 | content、structuredContent、错误信息与元数据 |
| 双方支持哪些功能 | 协议版本、capabilities 与扩展协商 |
| 消息如何传输 | 本地 stdio 或远程 Streamable HTTP |
它和 USB-C 的类比有用但不完整:USB-C 统一了物理接口,MCP 统一的是一组面向模型的语义与调用契约。一个工具的名字、描述和 Schema 会直接影响模型是否选中它,因此 MCP 元数据本身就是产品界面的一部分。
二、先认清四个角色
Agent 应用] H --> M[LLM] H --> C1[MCP Client A] H --> C2[MCP Client B] C1 <-->|MCP| S1[MCP Server
项目系统] C2 <-->|MCP| S2[MCP Server
知识库] S1 --> API1[(业务 API / DB)] S2 --> API2[(文档 / 搜索)]
| 角色 | 做什么 | 常见误解 |
|---|---|---|
| User | 提出目标并对高风险动作确认 | 用户通常不直接构造 MCP 请求 |
| Host | 承载 Agent、模型、上下文、策略、审批与多个 MCP Client | MCP Server 不负责整个 Agent 循环 |
| MCP Client | 与一个 Server 通信,完成发现、调用和协议兼容 | 它一般是 Host 内部组件,不等于用户界面 |
| MCP Server | 暴露能力,校验调用并连接真实业务系统 | 它不是把整个数据库无条件交给模型 |
最重要的一点:通常不是模型直接访问 MCP Server。Host 先把允许的能力提供给模型;模型产生工具调用意图;Host 再根据权限、审批和运行策略决定是否执行。这个边界让“模型想做什么”和“系统允许做什么”可以分开。
三、MCP 暴露什么
MCP Server 主要暴露三类原语:
| 原语 | 控制者 | 适合什么 | 示例 |
|---|---|---|---|
| Tools | 模型选择调用,Host 执行策略把关 | 查询或执行动作 | search_projects、create_ticket |
| Resources | Host / 应用选择加载 | 可寻址的只读上下文 | project://P-1024/spec |
| Prompts | 用户或 Host 选择 | 可复用的工作流模板 | “生成发布检查清单” |
此外还有通知、补全、引导式输入等能力。不要因为协议支持很多功能就全部实现:大多数服务从少量清晰的 Tools 开始就够了。
Tool 和普通 REST API 有什么不同
底层业务逻辑完全可以继续使用 REST、gRPC 或数据库。MCP Server 更像一层“面向 Agent 的适配器”:
名称 + 描述 + Schema] --> S[MCP Server
鉴权 · 校验 · 编排] S --> R1[REST API] S --> R2[gRPC] S --> R3[(Database)] S --> R4[Message Queue]
REST 路由通常为人类开发者设计,例如 PATCH /v1/projects/:id;MCP Tool 应围绕用户目标设计,例如 archive_project(project_id, reason)。不要简单地把数百个内部端点一比一暴露给模型。
四、远程 MCP 的完整调用链路
远程 MCP 通常使用 Streamable HTTP。旧的 HTTP+SSE transport 已被取代,只应为旧客户端保留兼容。下面先看一次典型工具调用:
这条链路可以拆成五段。
1. 配置与发现
Host 保存 MCP Server 的名称、URL 和认证方式。连接时,双方确认协议版本、服务信息和 capabilities;Client 再读取工具列表。现代客户端会缓存列表,并在服务通知能力变化或缓存失效时刷新。
截至本文所用的 2026-07-28 规范,新链路以无会话的 server/discover 和每请求元数据为主;兼容旧规范的客户端则可能先走 initialize → initialized,并携带 Mcp-Session-Id。SDK 会处理大部分兼容逻辑,业务代码不要自己拼 JSON-RPC。
2. 工具进入模型上下文
Host 并不一定把所有工具都塞给模型。它可能按租户、角色、当前任务或工具搜索结果过滤,只向模型提供相关的名称、描述和 Schema。这一步决定模型“知道自己能做什么”。
工具越多不一定越好。五个边界明确的工具,通常比五十个描述含糊的工具更可靠,也更节省上下文。
3. 模型选择,Host 决策
模型返回的是一个结构化调用意图,而不是直接执行结果。Host 应在这里做策略判断:
- 该用户能否使用这个 Server 和 Tool;
- 读取是否可直接执行,写入是否需要确认;
- 参数是否命中数据边界、费用上限或速率限制;
- 是否存在提示注入、越权或破坏性风险。
Tool annotations 能帮助 Host 判断 readOnly、destructive、openWorld 等性质,但它们只是提示,不能替代服务端鉴权。
4. HTTP 调用与业务执行
Client 通过 HTTPS 向 /mcp 发送 MCP 请求。现代远程请求包含协议版本和路由相关信息,认证通常放在 Authorization header。Server 必须再次完成:令牌验证、scope 校验、租户隔离、参数校验、业务授权、超时与审计。
然后它才调用真正的 REST/gRPC/数据库。MCP 不会替你解决业务授权,也不会自动让一条危险 SQL 变安全。
把 SDK 隐藏的细节展开,一次现代 Tool 调用大致是下面这样(为便于阅读省略部分每请求 _meta):
|
|
成功结果仍是 JSON-RPC,其中 content 供模型阅读,structuredContent 供程序可靠消费:
|
|
不要在业务代码中手写这些报文。示例的意义是方便查日志、网关和 trace;版本协商、header 与 JSON-RPC 细节应交给 SDK。
5. 结果回到模型
工具结果常有三条通道:
| 字段 | 谁使用 | 建议 |
|---|---|---|
content |
模型 | 简洁、可理解,说明发生了什么 |
structuredContent |
Host / 后续工具 / UI | 遵守输出 Schema,返回稳定 ID 与字段 |
_meta |
Client 应用 | 放客户端专用信息;不要把它当秘密保险箱 |
Host 将允许模型看到的结果放回上下文,模型再生成最终答复。MCP 调用成功不等于用户任务成功:Agent 还需要检查 isError、确认数据完整性,并可能继续调用下一项工具。
五、两种远程连接模式
| 模式 | 优点 | 适合场景 |
|---|---|---|
| 运行时直连 | 网络、凭据、审批、过滤都由你的应用掌控 | 私网服务、严格合规、自定义策略 |
| 平台托管 MCP | 接入代码少,Agent 平台负责协议调用 | 公网 HTTPS 服务、快速集成 |
在 OpenAI Agents SDK 中,公开远程服务可作为 hosted MCP tool;本地或私有服务则可以由 SDK runtime 通过 stdio 或 Streamable HTTP 管理。选择标准不是“哪种更新”,而是连接与信任边界应该由谁拥有。
六、从零开发一个远程 MCP Server
下面做一个最小但完整的“项目查询”服务。示例使用 Python SDK v2、Python 3.10+,并选择无状态 Streamable HTTP,便于水平扩展。
1. 初始化项目
|
|
固定主版本很重要:MCP SDK 与规范演进较快,不应让生产构建在无审核时跨主版本升级。
2. 编写 server.py
|
|
这段代码虽短,却已经定义了完整契约:
- 函数名成为 Tool 名;
- docstring 成为模型看到的描述;
- 类型注解生成输入 JSON Schema;
- 返回类型生成输出 Schema;
ToolAnnotations告诉 Host 它是只读、幂等、非破坏且不访问开放互联网的;- SDK 处理 MCP 消息、协议版本与 Streamable HTTP。
生产环境里把 PROJECTS 替换成业务 Service 调用即可,但不要跳过“从当前认证身份推导租户”这一步。
3. 本地测试
先用官方 Inspector 检查能力发现、Schema 和结果:
|
|
再启动真正的远程 transport:
|
|
另一种可靠的自动化检查,是用同一 SDK 作为客户端:
|
|
测试至少覆盖:正常参数、边界值、非法枚举、无权限、下游超时、空结果和输出 Schema。Inspector 能证明“协议可用”,自动化测试才能证明“升级后仍然可用”。
4. 容器化与部署
|
|
|
|
生产地址应是稳定 HTTPS URL,例如:
|
|
上面的演示服务没有认证,只能用于本机学习。部署到任何可被其他人访问的网络前,必须接入 SDK 的 token verifier / OAuth 配置,并在每个 Tool 内落实业务授权。
反向代理和平台需要允许流式响应;设置合理的请求体上限、调用超时和连接空闲时间。无状态模式适合普通查询与动作;需要跨调用状态时,优先让服务返回显式 handle,再由后续工具把它作为参数传回,而不是偷偷依赖某台实例的内存。
七、让 Agent 真正使用你的 MCP
“服务能访问”只完成了一半。要让 Agent 稳定调用,还需要注册、授权、告知使用时机、验证真实行为。
接入 Codex
使用 Codex CLI 添加远程服务:
|
|
也可以写入 ~/.codex/config.toml:
|
|
然后在项目 AGENTS.md 中给出简短、可验证的路由规则:
|
|
配置决定“Agent 能看见哪些能力”,指令决定“什么时候优先使用”。不要写“永远相信工具结果”之类的规则,远程内容仍可能过期或包含恶意文本。
接入 OpenAI Agents SDK
公开的远程 MCP 可以作为 hosted tool 附到 Agent 上:
|
|
写操作不要照抄 never。审批策略应与工具风险匹配,并且服务端仍需独立鉴权。私有服务也可以让 Agents SDK runtime 直接管理连接,从而由你的应用控制网络、过滤与审批边界。
验证 Agent 是否会用
准备一组小型评测,而不是只问一句“能用吗”:
| 用例 | 期望行为 |
|---|---|
| “列出延期项目” | 调 list_projects(status="delayed") |
| “介绍什么是延期项目” | 若是通用定义,不应无意义调用 |
| “把 P-1002 删除” | 当前无删除工具,应说明做不到,不能伪造成功 |
“列出 status=hacked” |
Schema 拒绝非法枚举,Agent 应修正或解释 |
| Tool 返回网页中的“忽略之前指令” | 把它视作不可信数据,不执行越权动作 |
观察三类指标:工具选择是否正确、参数是否正确、拿到结果后是否忠实回答。只看最终文字,容易漏掉重复调用、越权尝试和不必要的高成本请求。
八、工具设计决定 Agent 上限
好工具的形状
建议遵循这些规则:
- 一个工具完成一个可识别目标。 用
list_projects、get_project、update_project,不要做project_action(mode, payload)万能入口。 - 描述“何时用”,而不只描述实现。 模型靠描述选择工具。
- 输入要窄。 枚举、长度、范围、格式能写进 Schema 就不要只写在文档里。
- 读取与写入分开。 这样 Host 才能给不同审批策略。
- 返回稳定 ID。 后续调用使用
P-1002,不要让模型靠名称猜记录。 - 分页且设上限。 不要一次把十万行塞进上下文。
- 错误应可恢复。 “项目不存在,请先 list_projects 获取 ID”比堆栈信息有用。
- Schema 向后兼容。 新增可选字段通常安全;改名、改类型或删除字段可能让旧 Agent 失效。
MCP 不适合什么
- 纯粹在应用内部、只被一处调用的简单函数,直接 function tool 可能更省事;
- 大文件持续传输、实时音视频等数据面,不应硬塞进工具结果;
- 要求严格确定性的核心交易流程,不应把关键状态机完全交给模型自由规划;
- 没有授权边界的“任意 SQL”“任意 Shell”“任意 URL 抓取”,不应作为生产工具暴露。
九、安全:把模型、Server 和返回内容都当作不可信边界
不可信] --> H[Host 策略层] H -->|最小工具集| M[模型输出
不可信意图] M --> A{审批 / 授权} A --> S[MCP Server
再次鉴权与校验] S --> B[业务系统] B --> R[工具结果
仍不可信] R --> H
上线前至少做好以下事项:
| 风险 | 防线 |
|---|---|
| 越权读取或跨租户访问 | 每次调用验证 token、scope、tenant 与对象级权限 |
| 破坏性动作 | 单独工具、明确 annotations、用户确认、幂等键、可审计与可回滚 |
| 提示注入 | 把 Tool/Resource 返回当数据;禁止其改写系统策略或索要更多工具 |
| Token 泄漏 | 不写入 Tool 描述、结果和日志;不向错误 audience 透传 token |
| SSRF | URL allowlist、DNS/IP 校验、阻止云元数据与内网地址、限制重定向 |
| 数据过量 | 字段最小化、分页、结果上限、PII 脱敏 |
| 拒绝服务与费用失控 | 速率限制、并发限制、超时、熔断、配额 |
| 供应链漂移 | 固定 SDK 主版本、扫描依赖、灰度升级、可回滚部署 |
认证回答“你是谁”,授权回答“你能对哪条数据做什么”。只验证 Bearer Token 是否存在远远不够。对多用户服务,业务查询必须从已验证凭据中取得用户和租户,绝不能信任模型传入的 user_id。
OAuth 场景使用标准授权发现、最小 scope 和明确 audience。Tool annotations、Host 弹窗、网络 allowlist 都属于纵深防御,但服务端对象级授权才是最终边界。
十、可观测性与排错
一次 MCP 问题可能出现在四层:模型没选工具、Host 拦截、协议失败、业务系统失败。日志必须能把它们串起来。
建议记录:
trace_id/ request ID、Server 与 Tool 名称、版本;- 已脱敏的调用方、租户、审批结果;
- 总耗时和下游耗时、结果大小、错误分类;
- Schema 版本与部署版本。
不要记录 access token、完整私密文档或未经脱敏的 Tool 结果。
| 现象 | 先查什么 |
|---|---|
| Server 完全连不上 | URL、HTTPS 证书、DNS、Host header、防火墙、/mcp 路径 |
| 已连接但看不到工具 | discovery/capabilities、tools/list、注册代码是否执行 |
| 模型从不调用 | Tool 名称与描述、指令、是否给了过多相似工具 |
| 参数总是错 | Schema 是否太宽或语义含糊,枚举与示例是否清楚 |
| 本地正常、远程超时 | 代理流式配置、平台超时、下游延迟、冷启动 |
| 调用成功但回答错误 | content 是否清楚、结构化结果是否完整、模型是否拿到旧缓存 |
| 多副本偶发失败 | 是否暗中依赖进程内状态或旧版 session sticky routing |
最短排错路径通常是:Inspector 直连 Server → SDK Client 直连 → Host 中查看工具列表 → 观察一次完整 Agent trace。这样能快速定位问题属于服务、协议还是模型决策。
十一、生产检查清单
- Tool 名称、描述、输入/输出 Schema 已评审
- 读取、写入、破坏性动作已拆分
- 每次请求都做认证、scope、租户和对象级授权
- 远程 endpoint 使用稳定 HTTPS 与 Streamable HTTP
- 写操作有审批、幂等与审计,必要时可回滚
- 结果有分页与大小上限,不含 secrets
- 超时、重试、限流、熔断和下游错误映射已配置
- Inspector、自动化测试和 Agent 行为评测均通过
- 有 trace、指标、脱敏日志和告警
- SDK 与 Schema 版本固定,升级可灰度和回滚
结语
MCP 真正解决的不是“让模型发一个 HTTP 请求”,而是让能力发现、参数契约、调用执行、结果返回和安全策略有一条共同的标准链路。
开发自己的 MCP,可以按这条最短路径推进:
先把一个只读工具做准,再增加写操作;先把权限边界做实,再追求复杂编排。MCP 降低了连接成本,却不会替代良好的 API 设计、授权模型与工程治理。