前言
欢迎来到 MySQL 的世界!无论你是刚接触编程的新手,还是想要补充数据库技能的开发者,这份教程都将为你提供最系统、最详细的学习路径。
MySQL 作为全球最流行的开源关系型数据库,凭借其轻量、高效、跨平台、免费的特性,已经成为 Web 开发、数据分析、后端服务的标配存储方案。从个人博客到大型电商平台,从学生管理系统到金融交易系统,MySQL 都能胜任。
本教程全程基于MySQL 8.0 LTS 稳定版编写,覆盖从环境搭建到生产级运维的全流程,所有代码均可直接复制执行,所有知识点都配有实战案例,确保零基础的你也能一步到位,彻底掌握 MySQL。
第一章:MySQL 基础认知
在动手操作之前,我们先搞懂几个核心概念,帮你建立对 MySQL 的整体认知。
1.1 核心概念
| 概念 |
通俗解释 |
| 数据库(DB) |
存储数据的大仓库,一个 MySQL 服务可以装很多个仓库,比如电商库、学生库 |
| 数据表(Table) |
仓库里的 Excel 表格,用来分类存储数据,比如用户表、订单表 |
| 字段(Column) |
表格里的列,比如用户表的id、name、age |
| 记录(Row) |
表格里的行,一条完整的数据,比如1,张三,20就是一个用户的记录 |
| SQL |
操作数据库的标准语言,就像你和数据库沟通的普通话 |
1.2 MySQL 整体架构
MySQL 采用经典的客户端 - 服务器架构,整个系统分为三层,理解这个架构能帮你搞懂 SQL 是怎么执行的:
1.3 存储引擎:选对工具事半功倍
MySQL 的存储引擎就像不同的文件管理器,你可以根据业务需求选择:
| 引擎 |
特点 |
适用场景 |
| InnoDB |
默认引擎,支持事务、外键、行级锁, crash-safe |
99% 的业务场景,生产环境首选 |
| MyISAM |
轻量,不支持事务,表级锁,查询快 |
只读的日志表、静态数据 |
| Memory |
数据存在内存里,速度极快,重启就没 |
临时缓存表、中间计算 |
💡 提示:不用纠结,直接用默认的 InnoDB 就对了,它能满足你所有的学习和开发需求。
第二章:环境搭建:全平台安装指南
这一章我们来搞定 MySQL 的安装,覆盖 Windows、Linux、Mac 三大平台,每一步都有避坑提示,保证你一次成功。
2.1 Windows 平台安装(图形化界面,新手首选)
Windows 用户推荐用官方的 MSI 安装包,全程图形化操作,不用敲命令。
步骤 1:下载安装包
-
打开官网下载页:https://dev.mysql.com/downloads/installer/
-
下载MySQL Installer for Windows的完整安装包(约 500M,不要下小的在线包)
步骤 2:安装流程
-
双击安装包,选择Developer Default(开发者默认),这个会自动帮你装齐所有需要的组件
-
等待依赖安装完成,一路 Next 到配置页面
-
Type and Networking:保持默认,端口 3306 不要改
-
认证方式:保持默认的强密码加密
-
设置 root 密码:务必记牢!比如Mysql@2026,要包含大小写、数字、特殊字符
-
Windows 服务:保持默认,勾选开机自启
-
点击 Execute,等待安装完成
步骤 3:配置环境变量(解决 mysql 不是内部命令)
-
找到 MySQL 的 bin 目录,默认是C:\Program Files\MySQL\MySQL Server 8.0\bin
-
右键此电脑→属性→高级系统设置→环境变量
-
找到系统变量里的 Path,双击添加上面的 bin 目录
-
重启 CMD,输入mysql -u root -p,输入密码能进入命令行就成功了!
2.2 Linux 平台安装(生产环境主流)
Linux 是企业生产环境的首选,我们覆盖 CentOS 和 Ubuntu 两大主流发行版。
CentOS/Rocky Linux 安装
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
|
# 1. 卸载系统自带的mariadb,避免冲突
yum remove -y mariadb*
# 2. 配置MySQL官方源
wget https://dev.mysql.com/get/mysql80-community-release-el8-3.noarch.rpm
rpm -ivh mysql80-community-release-el8-3.noarch.rpm
# 3. 安装MySQL
yum install -y mysql-community-server
# 4. 启动服务,设置开机自启
systemctl start mysqld
systemctl enable mysqld
# 5. 获取临时密码
grep 'temporary password' /var/log/mysqld.log
# 6. 登录修改密码
mysql -u root -p
ALTER USER 'root'@'localhost' IDENTIFIED BY 'Mysql@Linux2026!';
|
Ubuntu/Debian 安装
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
|
# 1. 更新源,清理旧版本
apt update -y && apt upgrade -y
apt remove -y mysql* mariadb*
# 2. 安装MySQL
apt install -y mysql-server
# 3. 启动服务
systemctl start mysql
systemctl enable mysql
# 4. 执行安全加固,设置密码
mysql_secure_installation
|
2.3 Mac 平台安装(Homebrew 一键搞定)
Mac 用户强烈推荐用 Homebrew 安装,比 dmg 包简单太多,自动适配 Intel 和 M 芯片。
1
2
3
4
5
6
7
8
9
|
# 1. 如果你没装Homebrew,先装它
/bin/bash -c "$(curl -fsSL https://mirrors.ustc.edu.cn/misc/brew-install.sh)"
# 2. 安装MySQL
brew update
brew install mysql
# 3. 启动服务
brew services start mysql
# 4. 安全加固,设置密码
mysql_secure_installation
|
2.4 安装报错急救包
99% 的安装失败都是这些问题,对照着解决:
-
1045 错误:密码错误:检查密码大小写,不要复制多余空格
-
2003 错误:连不上服务器:MySQL 服务没启动,或者防火墙拦了 3306 端口
-
命令找不到:环境变量没配对,重启终端试试
-
服务启动失败:之前的 MySQL 没卸载干净,或者路径有中文
第三章:SQL 核心语法入门
终于到了最核心的部分,SQL 语言!SQL 分为四大类,我们一个个来学。
后续的代码演示都在Navicat里操作的,命令行也一样,跟着敲一遍,理解更深刻!
3.1 DDL:数据库和表的结构操作
DDL 是用来定义数据库、表的结构的,比如建库、建表、改表。
数据库操作
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
-- 1. 创建数据库,不存在才创建,指定编码为utf8mb4(支持emoji)
CREATE DATABASE IF NOT EXISTS test_db DEFAULT CHARSET utf8mb4;

-- 2. 查看所有数据库
SHOW DATABASES;

-- 3. 使用/切换到这个数据库
USE test_db;

-- 4. 删除数据库(谨慎!删了就没了)
DROP DATABASE IF EXISTS test_db;
|
数据类型:选对类型很重要
建表之前要先搞懂字段的数据类型,这决定了你能存什么数据:
| 类型 |
说明 |
常用场景 |
| INT |
整数,4 字节 |
ID、年龄、数量 |
| TINYINT |
小整数,1 字节 |
状态、性别(1/0) |
| VARCHAR(n) |
可变长度字符串 |
用户名、手机号、标题 |
| TEXT |
长文本 |
文章内容、描述 |
| DECIMAL(m,n) |
精确小数 |
金额、价格(比如 DECIMAL (10,2) 就是最多 10 位,2 位小数) |
| DATE |
日期 |
生日、入职日期 |
| DATETIME |
日期时间 |
创建时间、更新时间 |
创建表
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
-- 创建用户表,包含各种约束和注释
CREATE TABLE IF NOT EXISTS `user` (
    `id` INT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '用户ID,自增主键',
    `username` VARCHAR(50) NOT NULL UNIQUE COMMENT '用户名,唯一',
    `name` VARCHAR(10) NOT NULL COMMENT '姓名',
    `age` TINYINT UNSIGNED DEFAULT 0 COMMENT '年龄',
    `gender` ENUM('男','女','未知') DEFAULT '未知' COMMENT '性别',
    `phone` CHAR(11) NOT NULL UNIQUE COMMENT '手机号',
    `create_time` DATETIME DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间,自动填充',
    PRIMARY KEY (`id`) -- 主键,唯一标识一条记录
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='用户信息表';
|
表的修改和删除
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
|
-- 查看表结构
DESC `user`;

-- 查看建表的SQL语句
SHOW CREATE TABLE `user`;

-- 添加字段:给user表加个email字段
ALTER TABLE `user` ADD `email` VARCHAR(50) AFTER `phone`;

-- 修改字段:把phone的长度改成20
ALTER TABLE `user` MODIFY `phone` VARCHAR(20);

-- 删除字段
ALTER TABLE `user` DROP `email`;

-- 删除表(谨慎!)
DROP TABLE IF EXISTS `user`;
|
3.2 DML:数据的增删改
DDL 是改结构,DML 是改表里的数据,也就是我们常说的增删改。
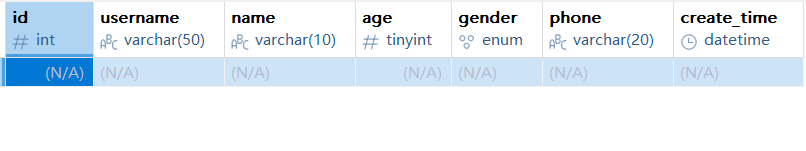
user表的结构如图所示:
插入数据(INSERT)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
|
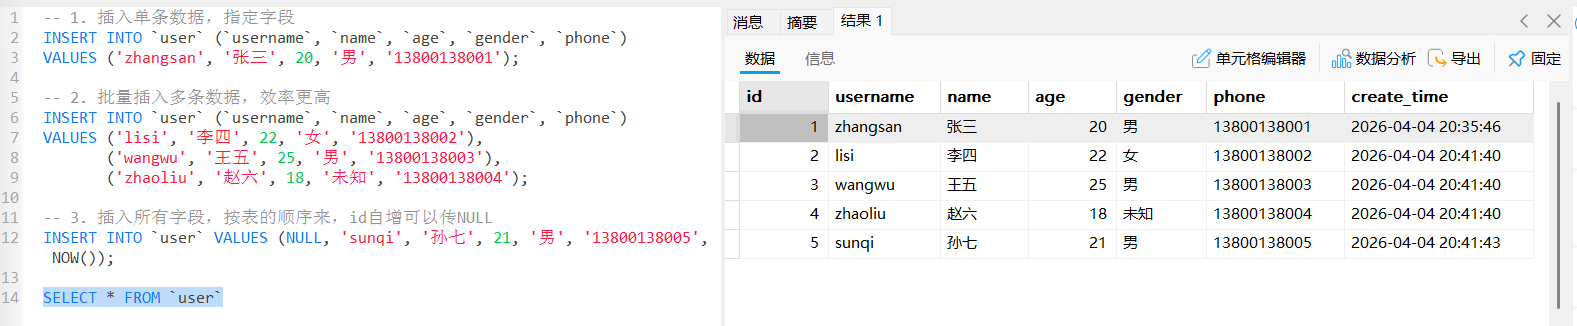
-- 1. 插入单条数据,指定字段
INSERT INTO `user` (`username`, `name`, `age`, `gender`, `phone`)
VALUES ('zhangsan', '张三', 20, '男', '13800138001');

-- 2. 批量插入多条数据,效率更高
INSERT INTO `user` (`username`, `name`, `age`, `gender`, `phone`)
VALUES
('lisi', '李四', 22, '女', '13800138002'),
('wangwu', '王五', 25, '男', '13800138003'),
('zhaoliu', '赵六', 18, '未知', '13800138004');

-- 3. 插入所有字段,按表的顺序来,id自增可以传NULL
INSERT INTO `user` VALUES (NULL, 'sunqi', '孙七', 21, '男', '13800138005', NOW());

SELECT * FROM `user`
|
更新数据(UPDATE)
⚠️ 新手最容易踩的坑:UPDATE 一定要加 WHERE 条件!不然会把全表的数据都改了!
1
2
3
4
5
6
7
8
|
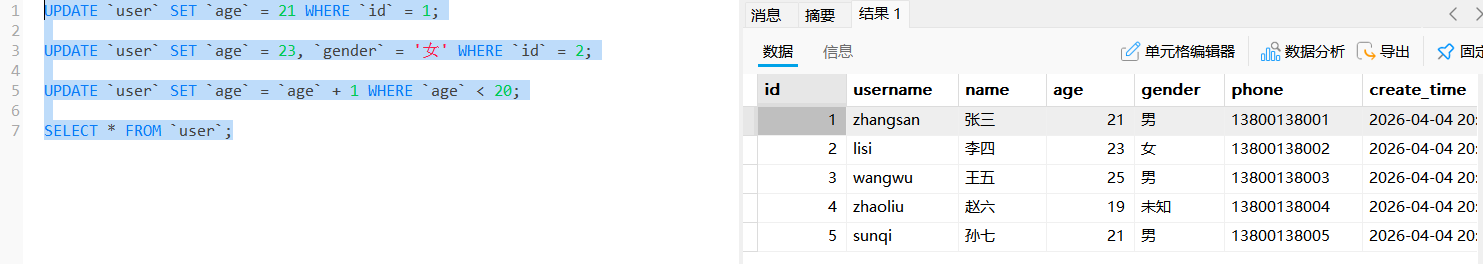
-- 1. 更新单条数据:把id=1的张三的年龄改成21
UPDATE `user` SET `age` = 21 WHERE `id` = 1;

-- 2. 更新多个字段:把李四的年龄和性别都改了
UPDATE `user` SET `age` = 23, `gender` = '女' WHERE `id` = 2;

-- 3. 批量更新:给所有20岁以下的用户年龄加1(谨慎使用!)
UPDATE `user` SET `age` = `age` + 1 WHERE `age` < 20;
|
删除数据(DELETE)
⚠️ 同样!DELETE 一定要加 WHERE!不然全表数据都没了!
1
2
3
4
5
6
7
8
|
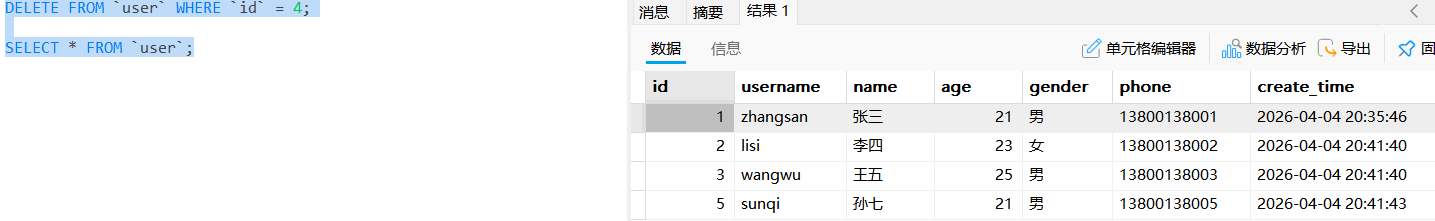
-- 1. 删除单条数据:删除id=4的赵六
DELETE FROM `user` WHERE `id` = 4;

-- 2. 批量删除:删除所有年龄大于100的无效数据
DELETE FROM `user` WHERE `age` > 100;

-- 3. 清空整个表,重置自增ID(比DELETE快,但是不可回滚)
TRUNCATE TABLE `user`;
|
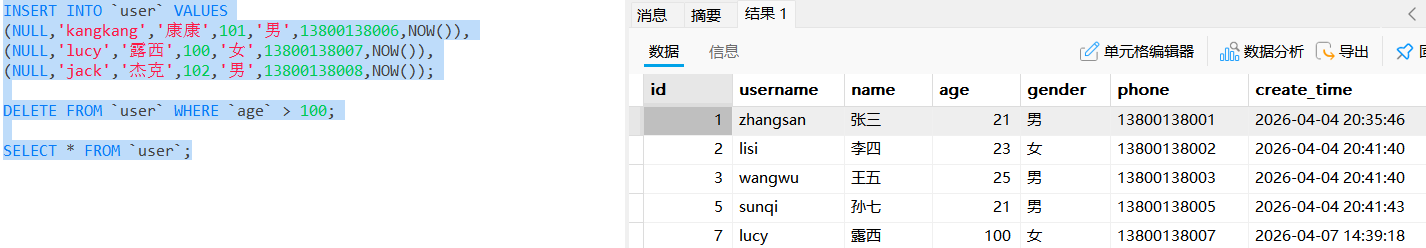
3.3 DQL:数据查询(核心中的核心)
DQL 是我们用的最多的,查询数据!90% 的数据库操作都是查询。
基础查询
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
-- 1. 查询所有字段(不推荐,效率低,要啥查啥)
SELECT * FROM `user`;

-- 2. 查询指定字段
SELECT `name`, `age`, `gender` FROM `user`;

-- 3. 给字段起别名,方便看
SELECT `name` AS 姓名, `age` AS 年龄, `gender` AS 性别 FROM `user`;

-- 4. 去重:查询所有不重复的性别
SELECT DISTINCT `gender` FROM `user`;
|
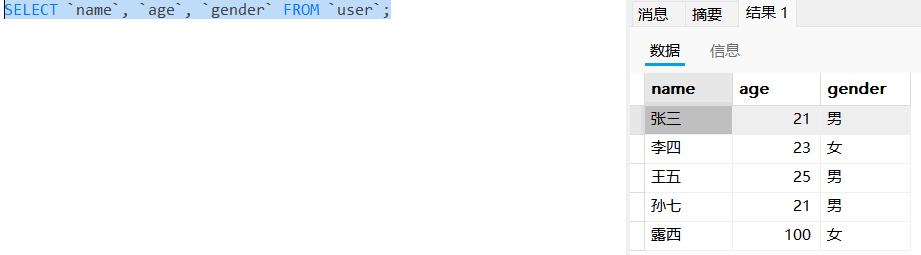
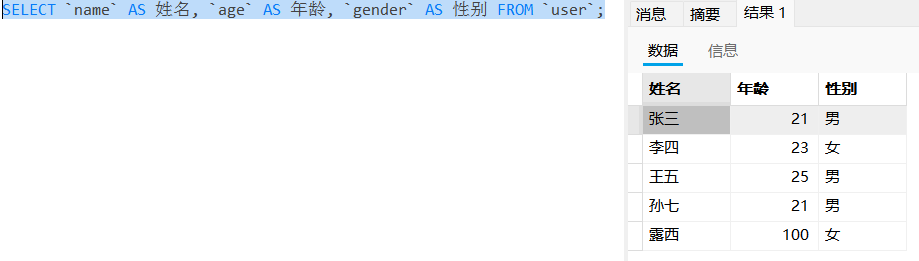
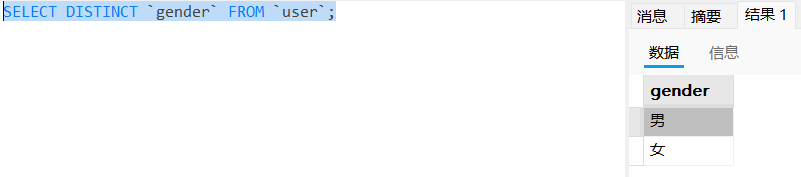
条件查询(WHERE)
按条件过滤数据,这是查询最常用的:
| 运算符 |
作用 |
示例 |
| = |
等于 |
WHERE id = 1 |
| != / <> |
不等于 |
WHERE age != 20 |
| > < >= <= |
比较 |
WHERE age > 18 |
| BETWEEN … AND … |
区间 |
WHERE age BETWEEN 18 AND 25 |
| IN(…) |
匹配多个值 |
WHERE id IN (1,2,3) |
| IS NULL / IS NOT NULL |
空值判断 |
WHERE phone IS NULL |
| LIKE |
模糊查询 |
WHERE name LIKE ‘张%’ |
| AND / OR |
逻辑与 / 或 |
WHERE age>18 AND gender=’ 男' |
实战示例:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
|
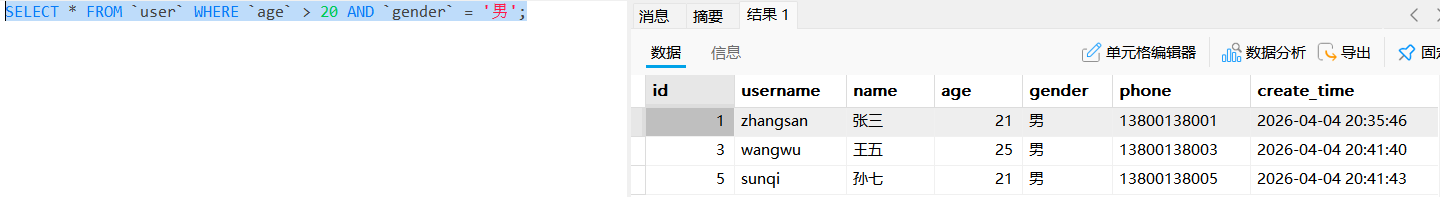
-- 1. 查询年龄大于20的男性
SELECT * FROM `user` WHERE `age` > 20 AND `gender` = '男';

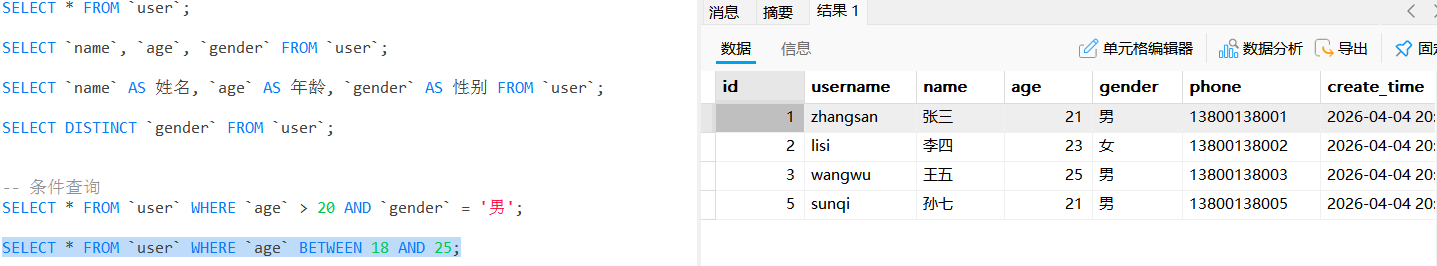
-- 2. 查询年龄在18到25之间的用户
SELECT * FROM `user` WHERE `age` BETWEEN 18 AND 25;

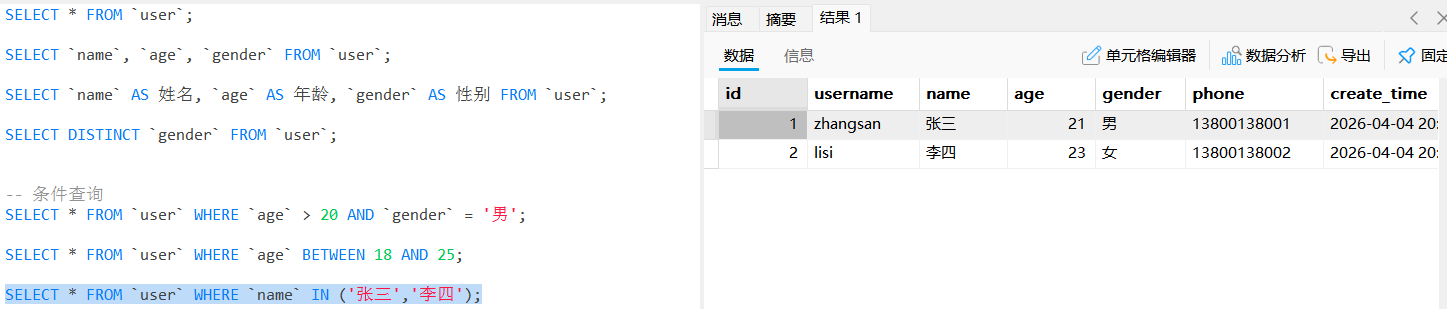
-- 3. 查询姓名是张三或者李四的
SELECT * FROM `user` WHERE `name` IN ('张三', '李四');

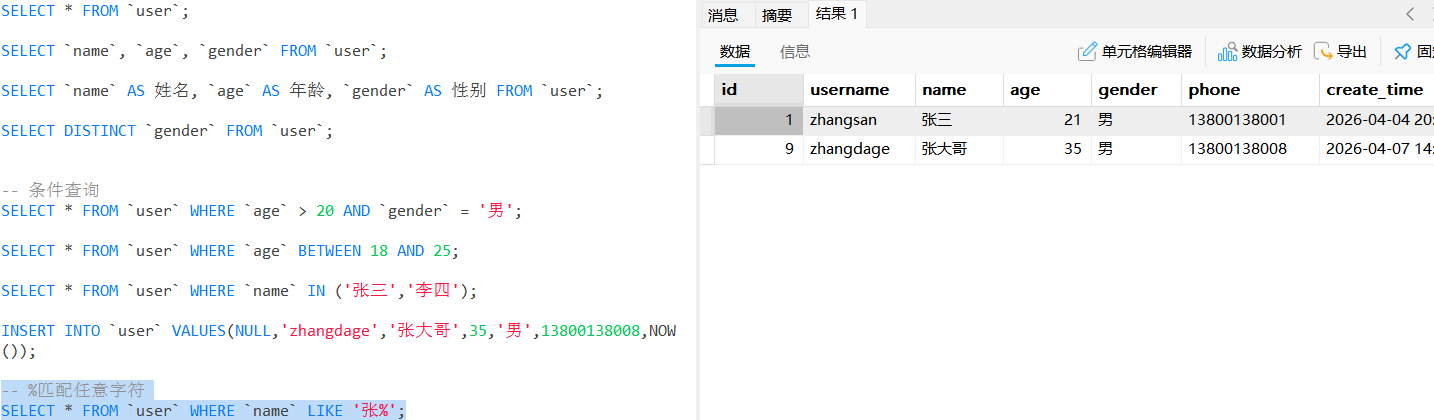
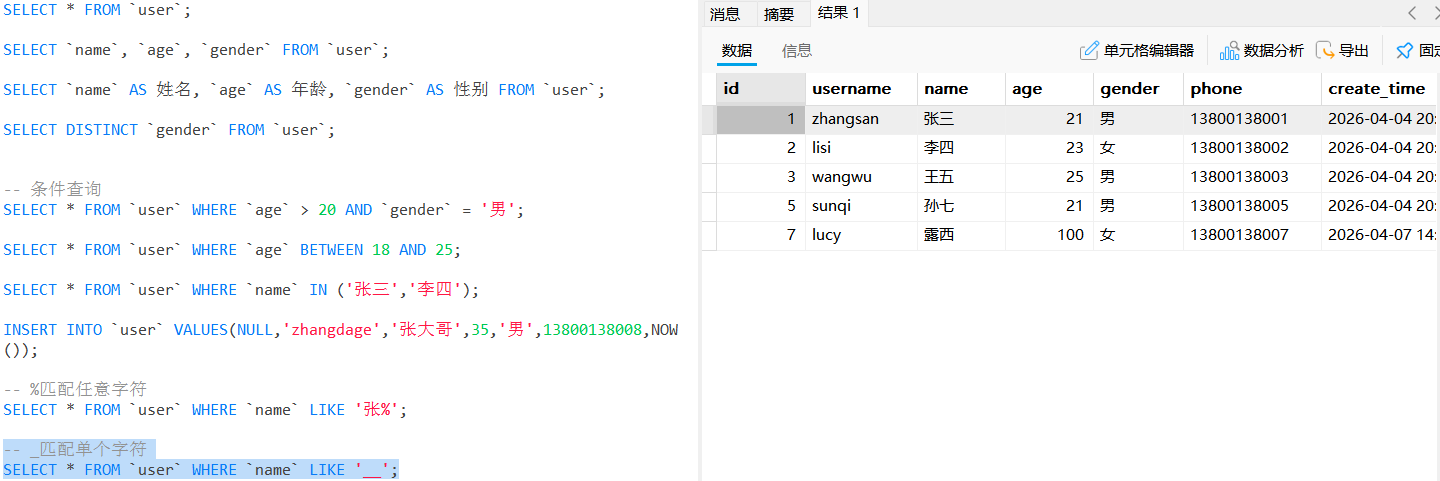
-- 4. 查询姓张的用户(%匹配任意字符)
SELECT * FROM `user` WHERE `name` LIKE '张%';

-- 5. 查询姓名是两个字的用户(_匹配单个字符)
SELECT * FROM `user` WHERE `name` LIKE '__';
|
排序查询(ORDER BY)
把查询结果按某个字段排序:
1
2
3
4
5
6
7
8
|
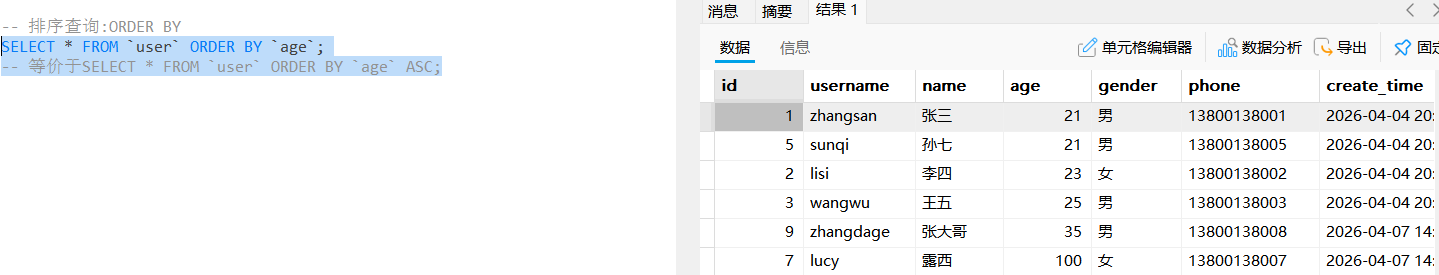
-- 1. 按年龄升序(从小到大,ASC是默认)
SELECT * FROM `user` ORDER BY `age` ASC;

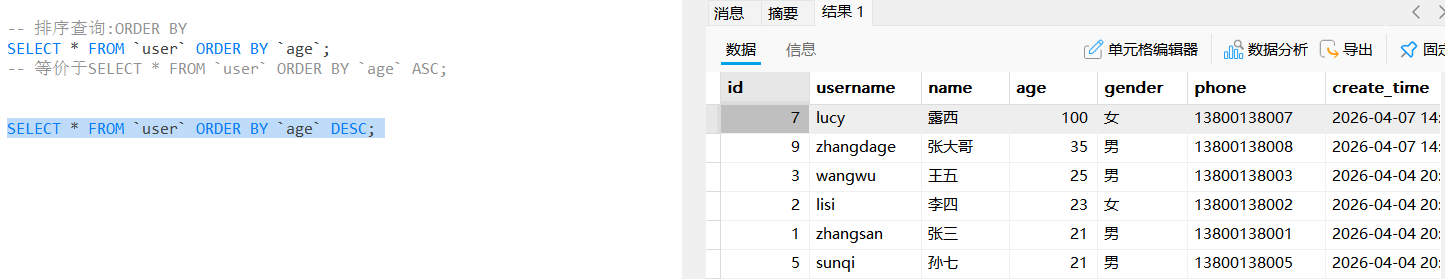
-- 2. 按年龄降序(从大到小)
SELECT * FROM `user` ORDER BY `age` DESC;

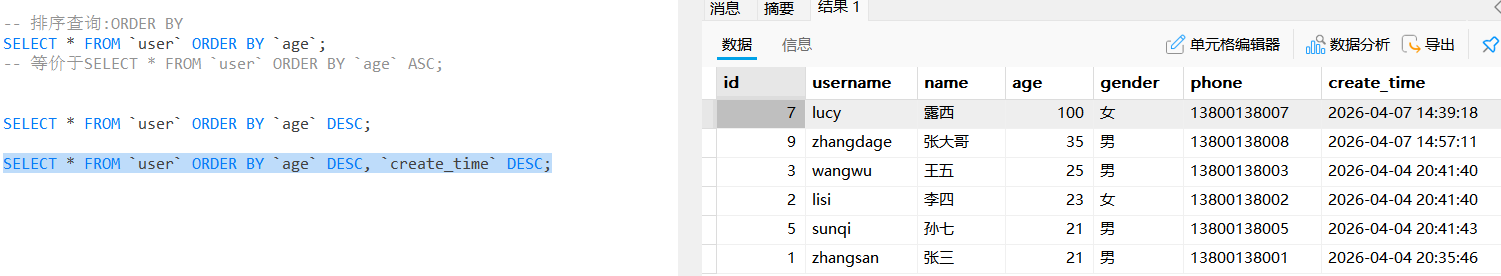
-- 3. 多字段排序:先按年龄排,年龄相同按创建时间排
SELECT * FROM `user` ORDER BY `age` DESC, `create_time` DESC;
|
分页查询(LIMIT)
数据太多的时候,分页显示,比如每页 10 条:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
-- 语法:LIMIT 起始索引, 每页条数
-- 起始索引 = (页码 - 1) * 每页条数

-- 第1页,每页2条
SELECT * FROM `user` LIMIT 0, 2;

-- 第2页,每页2条
SELECT * FROM `user` LIMIT 2, 2;

-- 第3页,每页2条
SELECT * FROM `user` LIMIT 4, 2;
|
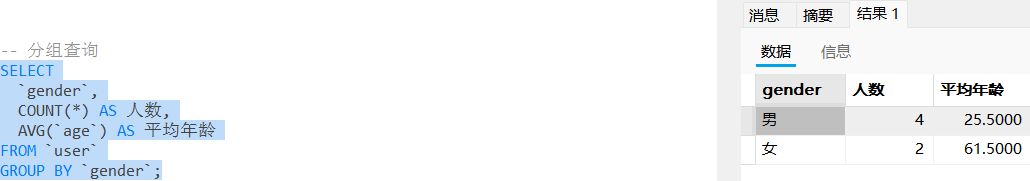
分组查询(GROUP BY)
分组统计,比如按性别统计人数,按班级统计平均分:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
|
-- 聚合函数:用来统计的函数
-- COUNT(*):统计行数,SUM():求和,AVG():平均值,MAX():最大值,MIN():最小值

-- 1. 按性别分组,统计每个性别的人数和平均年龄
SELECT
    `gender`,
    COUNT(*) AS 人数,
    AVG(`age`) AS 平均年龄
FROM `user`
GROUP BY `gender`;

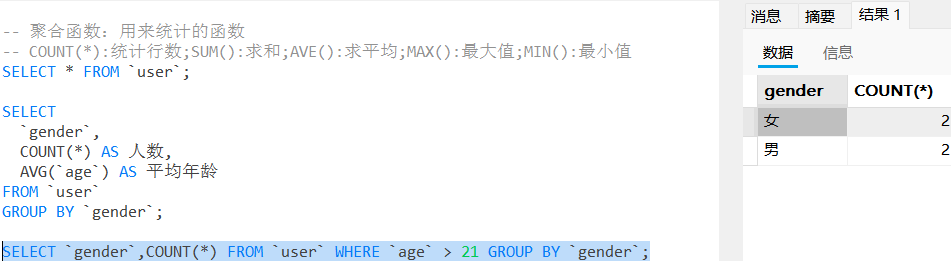
-- 2. 先过滤,再分组:查询20岁以上的用户,按性别分组
SELECT `gender`, COUNT(*) FROM `user` WHERE `age` > 21 GROUP BY `gender`;

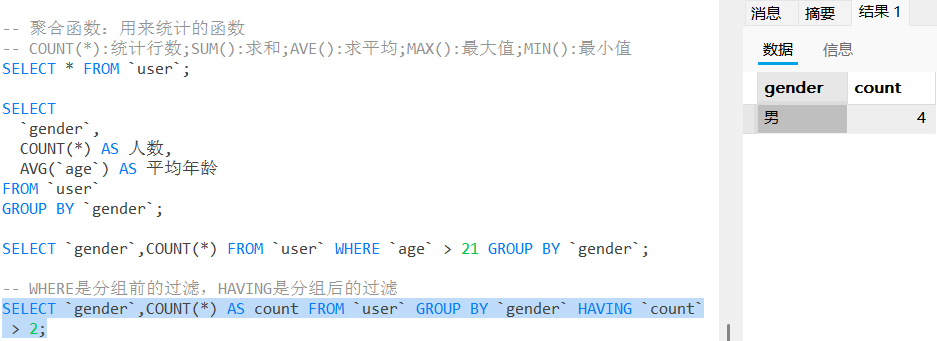
-- 3. 分组后再过滤:筛选人数大于1的分组(HAVING是分组后的过滤,WHERE是分组前的)
SELECT `gender`, COUNT(*) AS cnt FROM `user` GROUP BY `gender` HAVING cnt > 1;
|
第四章:高级查询技巧
学会了基础查询,我们来学更复杂的,多表查询、子查询这些。
4.1 多表连接查询
实际业务中,数据往往存在多个表里,比如用户表、订单表,我们需要把它们关联起来查询。
首先我们准备两个表:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
|
-- 订单表
CREATE TABLE `order` (
    `id` INT UNSIGNED NOT NULL AUTO_INCREMENT PRIMARY KEY,
    `order_no` VARCHAR(30) NOT NULL UNIQUE,
    `user_id` INT UNSIGNED NOT NULL,
    `amount` DECIMAL(10,2) NOT NULL,
    `create_time` DATETIME DEFAULT NOW(),
    FOREIGN KEY (`user_id`) REFERENCES `user`(`id`)
) ENGINE=InnoDB;

-- 插入测试数据
INSERT INTO `order` (`order_no`, `user_id`, `amount`) VALUES
('ORD001', 1, 99.9),
('ORD002', 1, 199.9),
('ORD003', 2, 299.9);
|
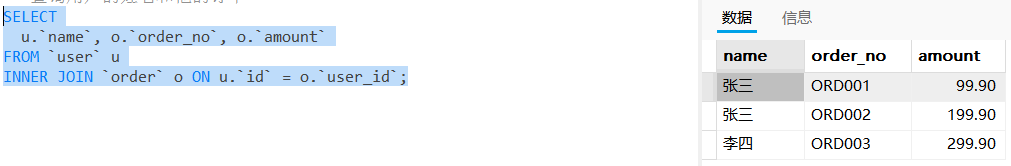
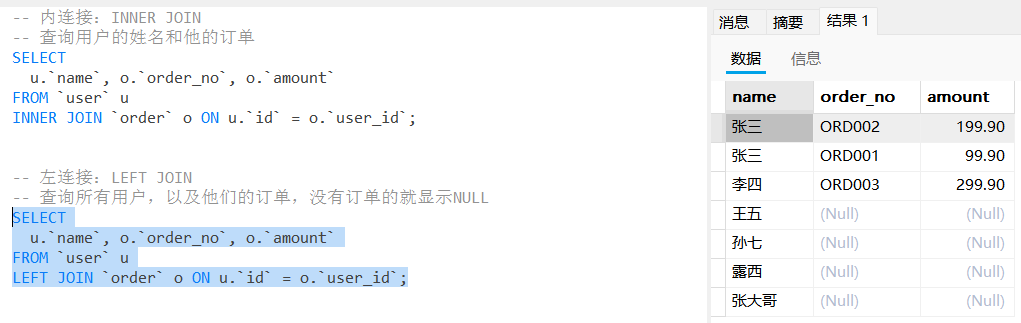
内连接(INNER JOIN)
只查两个表都匹配的数据,也就是有订单的用户:
1
2
3
4
5
|
-- 查询用户的姓名和他的订单
SELECT
    u.`name`, o.`order_no`, o.`amount`
FROM `user` u
INNER JOIN `order` o ON u.`id` = o.`user_id`;
|
左连接(LEFT JOIN)
查左表的所有数据,右表匹配不上的就显示 NULL,比如查所有用户,包括没有订单的:
1
2
3
4
5
|
-- 查询所有用户,以及他们的订单,没有订单的也显示
SELECT
    u.`name`, o.`order_no`, o.`amount`
FROM `user` u
LEFT JOIN `order` o ON u.`id` = o.`user_id`;
|
右连接(RIGHT JOIN)
和左连接相反,查右表的所有数据,左表匹配不上的显示 NULL,用的比较少。
4.2 子查询
子查询就是嵌套在 SQL 里的查询,用来处理复杂的条件。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
-- 1. 标量子查询:查询年龄大于平均年龄的用户
SELECT `name`, `age` FROM `user`
WHERE `age` > (SELECT AVG(`age`) FROM `user`);

-- 2. 表子查询:查询有订单的用户
SELECT * FROM `user`
WHERE `id` IN (SELECT DISTINCT `user_id` FROM `order`);

-- 3. exists子查询:查询有订单的用户,效率比IN高
SELECT * FROM `user` u
WHERE EXISTS (SELECT 1 FROM `order` o WHERE o.`user_id` = u.`id`);
|

第五章:数据完整性与约束:保证数据绝对正确
很多人刚学的时候,会插入乱七八糟的数据,比如手机号重复、年龄负数、订单的用户不存在,约束就是用来解决这个问题的,它是数据库的 ”守门员”,保证你存进去的数据都是合法的。
5.1 约束的核心作用
约束是定义在表上的强制规则,数据库会自动帮你检查,如果你插入 / 更新的数据违反了规则,直接拒绝执行,从根源上避免脏数据。
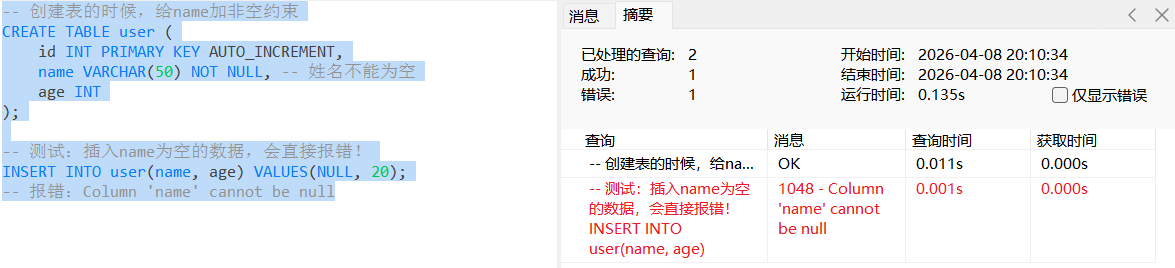
5.2 非空约束(NOT NULL):这个字段必须填
非空约束是最基础的,它规定这个字段不能为空,你插入数据的时候必须给它赋值。
实战示例
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
|
-- 创建表的时候,给name加非空约束
CREATE TABLE `user` (
    `id` INT PRIMARY KEY AUTO_INCREMENT,
    `name` VARCHAR(50) NOT NULL, -- 姓名不能为空
    `age` INT
);

-- 测试:插入name为空的数据,会直接报错!
INSERT INTO `user`(`name`, `age`) VALUES(NULL, 20);
-- 报错:Column 'name' cannot be null
|
💡 提示:必填的字段一定要加 NOT NULL,比如用户名、手机号,不然很容易出现空数据。
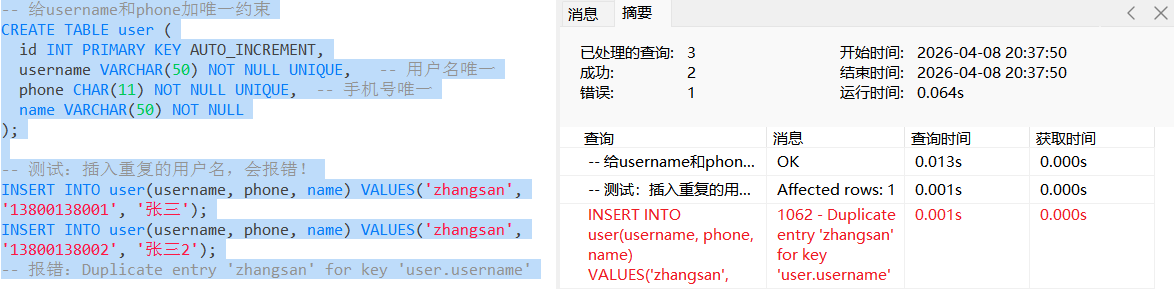
5.3 唯一约束(UNIQUE):这个字段不能重复
唯一约束规定,这个字段的所有值都不能重复,比如用户名、手机号、身份证号,这些都是不能重复的。
实战示例
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
|
-- 给username和phone加唯一约束
CREATE TABLE `user` (
    `id` INT PRIMARY KEY AUTO_INCREMENT,
    `username` VARCHAR(50) NOT NULL UNIQUE, -- 用户名唯一
    `phone` CHAR(11) NOT NULL UNIQUE, -- 手机号唯一
    `name` VARCHAR(50) NOT NULL
);

-- 测试:插入重复的用户名,会报错!
INSERT INTO `user`(`username`, `phone`, `name`) VALUES('zhangsan', '13800138001', '张三');
INSERT INTO `user`(`username`, `phone`, `name`) VALUES('zhangsan', '13800138002', '张三2');
-- 报错:Duplicate entry 'zhangsan' for key 'user.username'
|
💡 注意:唯一约束允许 NULL 值,而且可以有多个 NULL,因为 NULL 不等于任何值,包括它自己。
5.4 主键约束(PRIMARY KEY):数据的唯一身份证
主键约束是非空 + 唯一的组合,它是一条记录的唯一标识,一个表只能有一个主键。
主键的作用:
-
唯一标识一条记录,不会有重复
-
其他表的外键要关联它
-
默认的主键索引,查询主键的时候速度极快
主键的选择
如果经常纠结主键选什么,这里给你一个最佳实践:
-
不要用业务字段当主键:比如手机号、身份证号,这些业务字段可能会变
-
用自增 ID 当主键:INT UNSIGNED NOT NULL AUTO_INCREMENT,简单、高效、不会变
-
UUID 主键:分布式系统用,不过会导致索引碎片,新手不用考虑
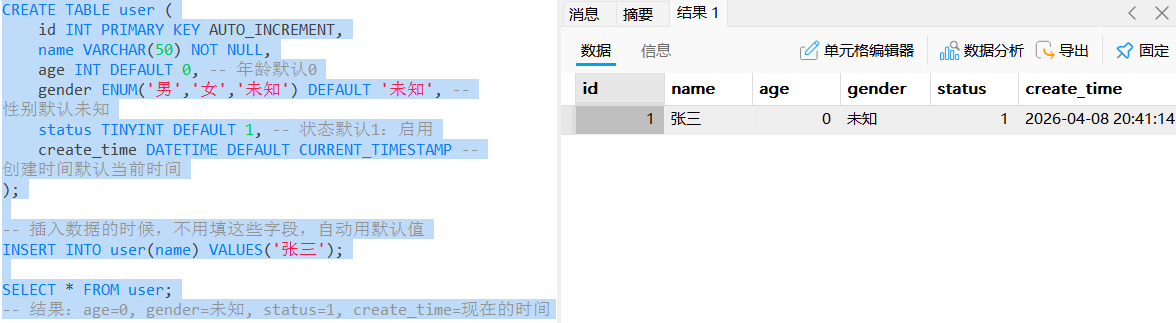
5.5 默认约束(DEFAULT):没填的话,用默认值
默认约束就是,如果你插入数据的时候没给这个字段赋值,就用默认值,非常方便。
实战示例
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
|
CREATE TABLE `user` (
    `id` INT PRIMARY KEY AUTO_INCREMENT,
    `name` VARCHAR(50) NOT NULL,
    `age` INT DEFAULT 0, -- 年龄默认0
    `gender` ENUM('男','女','未知') DEFAULT '未知', -- 性别默认未知
    `status` TINYINT DEFAULT 1, -- 状态默认1:启用
    `create_time` DATETIME DEFAULT CURRENT_TIMESTAMP -- 创建时间默认当前时间
);

-- 插入数据的时候,不用填这些字段,自动用默认值
INSERT INTO `user`(`name`) VALUES('张三');
-- 结果:age=0, gender=未知, status=1, create_time=现在的时间
|
5.6 检查约束(CHECK):自定义数据规则
MySQL 8.0 终于支持 CHECK 约束了!你可以自定义数据的规则,比如年龄必须大于 0,余额不能小于 0。
实战示例
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
|
CREATE TABLE `account` (
    `id` INT PRIMARY KEY AUTO_INCREMENT,
    `name` VARCHAR(50) NOT NULL,
    `age` INT CHECK (age > 0), -- 年龄必须大于0
    `balance` DECIMAL(10,2) CHECK (balance >= 0) -- 余额不能小于0
);

-- 测试:插入年龄为-1的,会报错!
INSERT INTO `account`(`name`, `age`, `balance`) VALUES('张三', -1, 100);
-- 报错:Check constraint 'account_chk_1' is violated.
|
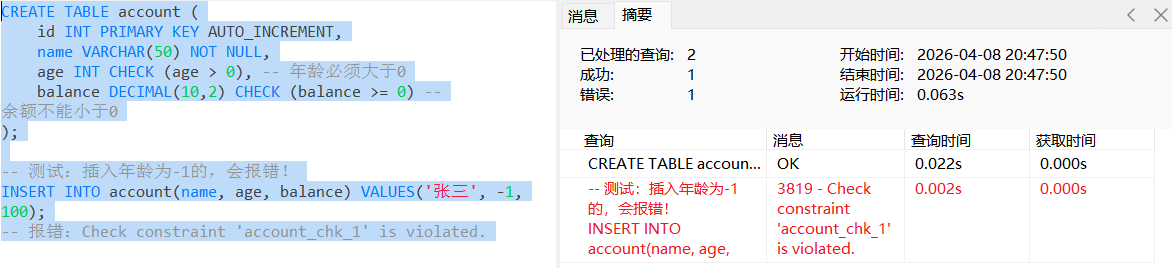
5.7 外键约束(FOREIGN KEY):关联数据的完整性
外键是用来保证两个表的关联数据正确的,比如订单表的user_id,必须在用户表存在,不能出现一个订单的用户是不存在的。
实战示例
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
|
-- 先建主表:用户表
CREATE TABLE `user` (
    `id` INT UNSIGNED NOT NULL AUTO_INCREMENT PRIMARY KEY,
    `name` VARCHAR(50) NOT NULL
);

-- 再建从表:订单表,user_id关联用户表的id
CREATE TABLE `order` (
    `id` INT UNSIGNED NOT NULL AUTO_INCREMENT PRIMARY KEY,
    `order_no` VARCHAR(30) NOT NULL,
    `user_id` INT UNSIGNED NOT NULL,
    `amount` DECIMAL(10,2) NOT NULL,
    -- 定义外键:user_id关联users的id
    FOREIGN KEY (user_id) REFERENCES `user`(id)
);

-- 测试:插入一个不存在的user_id的订单,会报错!
INSERT INTO `order`(`order_no`, `user_id`, `amount`) VALUES('ORD001', 999, 100);
-- 报错:Cannot add or update a child row: a foreign key constraint fails
|
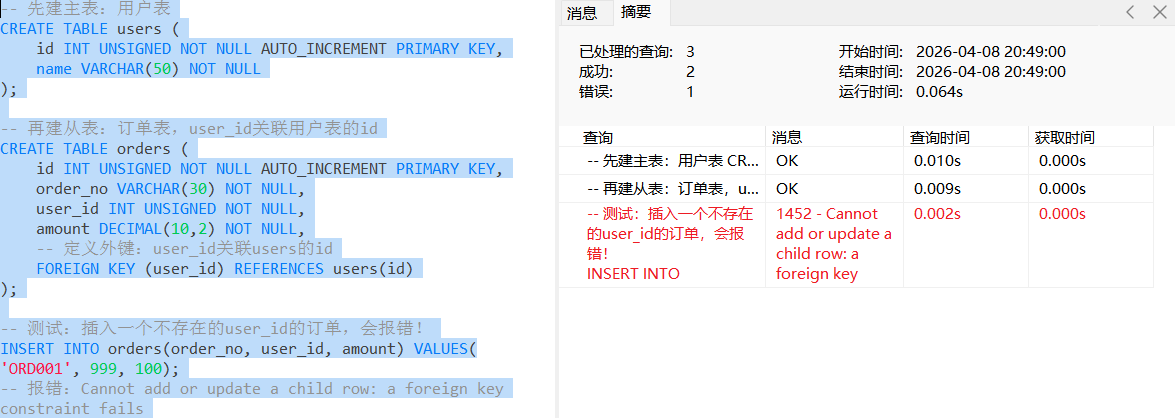
5.8 外键的级联操作:删主表数据的时候,从表怎么办?
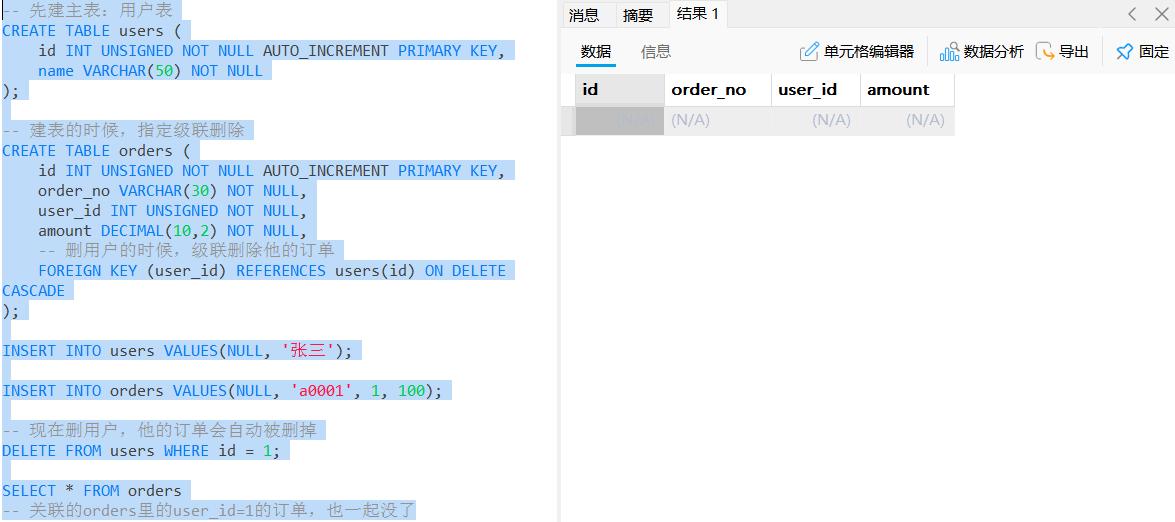
默认情况下,如果你要删的用户还有订单,MySQL 是不让你删的,这就是RESTRICT模式,防止你误删。
但是有时候我们希望,删用户的时候,把他的订单也一起删了,这时候就可以用级联操作:
| 级联模式 |
作用 |
| RESTRICT |
默认,不让你删,必须先删从表数据 |
| CASCADE |
级联,删主表数据的时候,把从表关联的数据也一起删了 |
| SET NULL |
删主表数据的时候,把从表的外键设为 NULL |
| NO ACTION |
和 RESTRICT 一样,啥也不做 |
级联删除实战
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
|
-- 先建主表:用户表
CREATE TABLE `user` (
    `id` INT UNSIGNED NOT NULL AUTO_INCREMENT PRIMARY KEY,
    `name` VARCHAR(50) NOT NULL
);

-- 建表的时候,指定级联删除
CREATE TABLE `order` (
    `id` INT UNSIGNED NOT NULL AUTO_INCREMENT PRIMARY KEY,
    `order_no` VARCHAR(30) NOT NULL,
    `user_id` INT UNSIGNED NOT NULL,
    `amount` DECIMAL(10,2) NOT NULL,
    -- 删用户的时候,级联删除他的订单
    FOREIGN KEY (user_id) REFERENCES `user`(id) ON DELETE CASCADE
);

INSERT INTO `user` VALUES(NULL, '张三');

INSERT INTO `order` VALUES(NULL, 'a0001', 1, 100);

-- 现在删用户,他的订单会自动被删掉
DELETE FROM `user` WHERE id = 1;

SELECT * FROM `order`
-- 关联的order里的user_id=1的订单,也一起没了
|
💡 避坑:外键虽然能保证数据完整性,但是会降低性能,高并发的生产环境,很多公司会选择在业务层保证数据一致性,不用外键,咱们学习的时候可以先用着。
第六章:事务管理:保证数据绝对不出错
你有没有遇到过这种情况:转账的时候,A 的钱扣了,B 的钱没加上?这就是没有事务导致的。
事务就是把一组操作打包成一个 ”原子操作”,要么全成功,要么全失败,绝对不会出现只成功一半的情况。
MySQL 中使用 START TRANSACTION 开启事务,COMMIT 提交事务,ROLLBACK 回滚事务。
6.1 事务的 ACID 特性:事务的四大金刚
1. 原子性(Atomicity):要么全做,要么全不做
原子性是事务最基础的特性,事务里的所有操作,就像一个原子一样,不可分割,不会只做一半。
比如转账的两个操作:A 减 100,B 加 100,这两个必须同时成功,或者同时失败,不能只成功一个。
2. 一致性(Consistency):数据的状态永远是对的
一致性是说,事务执行前后,数据的完整性约束没有被破坏。
比如转账前,A 有 1000,B 有 1000,总钱数是 2000;转账后,A 有 900,B 有 1100,总钱数还是 2000,这就是一致的。如果 A 减了 100,B 没加,总钱数变成 1900,这就是不一致的,事务会阻止这种情况。
3. 隔离性(Isolation):多个事务互不干扰
隔离性是说,多个事务同时执行的时候,互相看不到对方的中间状态,不会互相干扰。
比如你和我同时操作同一个账户,我的事务不会影响你的事务,你的也不会影响我的。
4. 持久性(Durability):提交了就永远不会丢
事务提交之后,数据就永久写到磁盘里了,就算系统断电、崩溃,数据也不会丢。
6.2 事务的基本操作:转账实战
我们用转账的例子,来看看事务怎么用:
1
2
3
4
5
6
7
8
9
|
-- 先建账户表
CREATE TABLE `account` (
    `id` INT PRIMARY KEY AUTO_INCREMENT,
    `name` VARCHAR(50) NOT NULL,
    `balance` DECIMAL(10,2) NOT NULL DEFAULT 0
);

-- 插入测试数据:A有1000,B有1000
INSERT INTO `account`(`name`, `balance`) VALUES('A', 1000), ('B', 1000);
|
现在我们要做转账:A 给 B 转 100 块。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
|
-- 1. 开启事务,关闭自动提交
-- 开启事务之后,你做的所有操作都是临时的,没提交之前别人看不到
START TRANSACTION;

-- 2. 执行操作:A减100
UPDATE account SET balance = balance - 100 WHERE id = 1;

-- 3. 执行操作:B加100
UPDATE account SET balance = balance + 100 WHERE id = 2;

-- 4. 检查一下,没问题的话,提交事务,生效
COMMIT;

-- 5. 如果中间出错了,比如网络断了,就回滚,回到事务之前的状态
ROLLBACK;
|
💡 提示:MySQL 默认是自动提交的,也就是你执行一条 SQL,它就自动提交了,所以你要手动开事务,它才会把你的操作打包。
6.3 并发问题:多个事务同时操作会出什么问题?
如果只有一个事务,那没问题,但是实际生产中,几百个事务同时执行,就会出现并发问题,主要有三个:
1. 脏读:读到了别人未提交的数据
脏读就是,一个事务读到了另一个事务还没提交的数据,然后那个事务回滚了,你读到的就是脏数据。
举个例子:
2. 不可重复读:同一个事务里,两次读同一个数据,结果不一样
不可重复读就是,在同一个事务里,你两次读同一个数据,结果不一样,因为中间被别的事务改了。
举个例子:
3. 幻读:同一个事务里,两次查询,行数不一样
幻读就是,在同一个事务里,你两次查同一个范围的数据,第二次多了一行,就像幻觉一样。
举个例子:
6.4 事务隔离级别:解决并发问题
为了解决这些并发问题,SQL 定义了四个隔离级别,级别越高,并发问题越少,但是性能越差。
| 隔离级别 |
脏读 |
不可重复读 |
幻读 |
说明 |
| 读未提交(Read Uncommitted) |
✅ |
✅ |
✅ |
最低,基本不用,性能最好 |
| 读已提交(Read Committed) |
❌ |
✅ |
✅ |
Oracle 默认,解决了脏读 |
| 可重复读(Repeatable Read) |
❌ |
❌ |
✅ |
MySQL 默认,解决了脏读、不可重复读 |
| 串行化(Serializable) |
❌ |
❌ |
❌ |
最高,所有问题都解决,但是性能最差,完全串行 |
💡 提示:MySQL 默认的可重复读,通过 MVCC(多版本并发控制),其实也解决了幻读,所以你不用改隔离级别,默认的就够用了。
6.5 事务避坑
-
不要开长事务:事务不要开太久,不然会锁表,影响其他业务,比如你开了事务,然后去调用接口,半天不提交,这就会出问题
-
异常一定要回滚:代码里如果出错了,一定要调用 ROLLBACK,不然事务会一直挂着
-
不要在事务里做远程调用:远程调用很慢,会把事务拖长
-
不要用事务做批量导入:大的批量操作,拆成小事务,不然锁太久了
第七章:索引:让查询快 1000 倍的秘密
很多人刚学的时候,数据少,查询很快,等数据到了 100 万,查询就慢的要死,这就是因为没加索引!
索引就是把数据按照某个字段进行排序,建立一个快速查找的目录,就像书的目录一样,有了索引,你就不用一页一页翻书了,直接就能找到你要的内容,查询速度能提升几百上千倍!
7.1 索引的原理:B + 树到底是什么?
MySQL 默认的索引是B + 树,这是一种有序的平衡树,所有的数据都存在叶子节点,而且叶子节点是有序的,用链表连起来。
B + 树的特点:
-
有序:所有数据都是排好序的,所以范围查询、排序都特别快
-
查询快:查询的时间复杂度是 O (log n),100 万的数据,只要查 20 次就找到了
-
叶子节点有序:叶子节点是用链表连起来的,所以遍历全表也很快
7.2 索引的类型:不同的索引用在不同的地方
| 类型 |
作用 |
适用场景 |
| 主键索引 |
主键自带的,聚簇索引,每个表必须有 |
主键 ID,查询 ID 的时候 |
| 二级索引 |
普通的索引,叶子节点存主键 |
普通的查询字段,比如 name |
| 唯一索引 |
唯一字段的索引,值不能重复 |
手机号、用户名、订单号 |
| 复合索引 |
多个字段的索引,比如 (name, age) |
经常一起查询的多个字段 |
| 覆盖索引 |
查询的字段都在索引里,不用回表 |
只查几个字段的查询 |
| 全文索引 |
文本的模糊搜索,比如文章内容 |
全文检索,比如搜索文章 |
7.3 回表:什么是回表,怎么避免?
二级索引的叶子节点存的是数据的主键,所以你用二级索引查到主键之后,还要用主键去主键索引里查完整的数据,这就叫回表,回表会多一次 IO,所以会慢一点。
如果你的查询的字段,都在索引里,那就不用回表了,这就是覆盖索引,速度会快很多。
比如:
1
2
3
4
5
6
|
-- 我们有复合索引(name, age)
-- 这个查询,只查name和age,都在索引里,不用回表,覆盖索引
SELECT `name`, `age` FROM `user` WHERE `name` = '张三';

-- 这个查询,要查phone,phone不在索引里,所以要回表
SELECT `name`, `age`, `phone` FROM `user` WHERE `name` = '张三';
|
7.4 最左前缀原则:复合索引的核心规则
复合索引是多个字段的索引,比如(a,b,c),它的顺序很重要,查询的时候,必须从最左边的字段开始匹配,这就是最左前缀原则。
举个例子,我们有复合索引(name, age, gender):
| 查询条件 |
能不能用到索引? |
WHERE name = ‘张三’ |
✅ 能,匹配最左的 name |
WHERE name = ‘张三’ AND age = 20 |
✅ 能,匹配 name’+age |
WHERE name = ‘张三’ AND age = 20 AND gender = ‘男’ |
✅ 能,匹配全部 |
WHERE age = 20 AND gender = ‘男’ |
❌ 不能,跳过了最左的 name |
WHERE name = ‘张三’ AND gender = ‘男’ |
✅ 能,name 能用到,gender 用不到 |
💡 所以建复合索引的时候,要把查询频繁的、区分度高的字段放最左边,把范围查询的字段放右边。
7.5 索引操作:怎么加索引
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
|
-- 1. 创建普通索引:给name字段加索引
CREATE INDEX idx_user_name ON `user`(`name`);

-- 2. 创建唯一索引:给phone加唯一索引
CREATE UNIQUE INDEX idx_user_phone ON `user`(`phone`);

-- 3. 创建复合索引:给name、age、gender加复合索引
CREATE INDEX idx_user_name_age_gender ON `user`(`name`, `age`, `gender`);

-- 4. 查看表的所有索引
SHOW INDEX FROM `user`;

-- 5. 删除索引
DROP INDEX idx_user_name ON `user`;
|
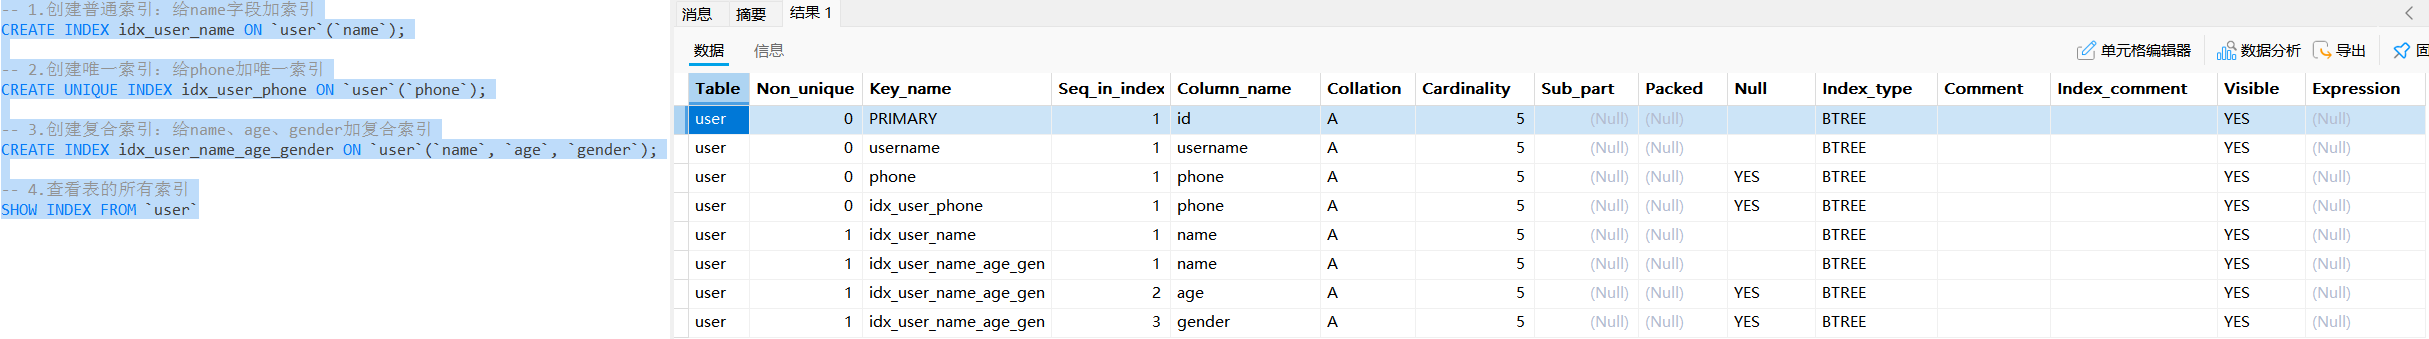
7.6 索引失效:最容易踩的坑,加了索引也没用
很多人加了索引,但是查询还是很慢,因为索引失效了,也就是你写的 SQL,导致索引用不了,变成了全表扫描。
我们一个个来看,这些都是最容易踩的坑:
1. 对索引字段做函数操作
如果你对索引字段做函数操作,MySQL 就没法用索引了,因为索引存的是原始值,不是函数处理后的值。
反例(索引失效):
1
2
|
-- 对create_time做了YEAR函数,索引失效
SELECT * FROM user WHERE YEAR(create_time) = 2026;
|
正例(索引生效):
1
2
|
-- 用范围查询,不用函数,索引生效
SELECT * FROM user WHERE create_time >= '2026-01-01' AND create_time < '2027-01-01';
|
2. 模糊查询,开头用通配符
LIKE '%xxx',开头的通配符,会导致索引失效,因为索引是有序的,开头不确定的话,没法匹配。
反例(索引失效):
1
2
|
-- 开头的%,索引失效
SELECT * FROM user WHERE name LIKE '%张三';
|
正例(索引生效):
1
2
|
-- 结尾的%,索引生效
SELECT * FROM user WHERE name LIKE '张三%';
|
3. 用 OR 连接没有索引的字段
如果 OR 的两个字段,一个有索引,一个没有,那整个查询都不会用索引。
反例(索引失效):
1
2
|
-- name有索引,age没有,OR导致整个索引失效
SELECT * FROM user WHERE name = '张三' OR age = 20;
|
4. 隐式类型转换
如果字段是字符串,你传了数字,MySQL 会自动做类型转换,导致索引失效。
反例(索引失效):
1
2
|
-- phone是字符串,你传了数字13800138001,隐式转换,索引失效
SELECT * FROM user WHERE phone = 13800138001;
|
正例(索引生效):
1
2
|
-- 传字符串,索引生效
SELECT * FROM user WHERE phone = '13800138001';
|
5. 用 NOT、’!=、<>、IS NOT NULL
这些操作,会导致索引失效,因为 MySQL 觉得全表扫描更快。
7.7 怎么看索引有没有生效:Explain 执行计划
很多人加了索引,不知道有没有生效,这时候就可以用EXPLAIN,它能告诉你 SQL 的执行计划,索引有没有用到。
用法很简单,在 SQL 前面加 EXPLAIN:
1
|
EXPLAIN SELECT * FROM user WHERE name = '张三';
|

然后看结果里的type字段,这个是查询的类型,越好的类型,速度越快:
system > const > eq_ref > ref > range > index > ALL
如果type是ALL,那就是全表扫描,索引没生效!
如果是ref、range这些,就是索引生效了。
还有key字段,显示的是用到的索引,如果这个是空的,就是没用到索引。
7.8 索引使用的最佳实践
-
不要给小表加索引:数据就几百条,全表扫描比索引还快
-
不要给区分度低的字段加索引:比如性别,只有男 / 女,加了索引也没用
-
不要给频繁修改的字段加索引:修改数据的时候,要同步修改索引,会变慢
-
索引不是越多越好:每个索引都会占用空间,而且会拖慢增删改的速度,一个表的索引不要超过 5 个
-
慢查询优化:开启慢查询日志,找到慢 SQL,然后给它们加索引
第八章:可视化工具:不用敲命令也能操作
很多人觉得命令行难,没关系,我们有可视化工具,点点鼠标就能操作!
8.1 Navicat:最流行的图形化工具
Navicat 是最常用的 MySQL 管理工具,界面友好,功能强大,新手首选。
连接数据库
-
打开 Navicat,点击左上角的「连接」→「MySQL」
-
连接名随便填,比如「本地 MySQL」
-
主机填localhost,端口 3306,用户名 root,密码填你安装时的密码
-
点击「测试连接」,成功就可以了
可视化建表
-
右键你的数据库→「新建表」
-
直接在表格里填字段名、类型、约束,点点鼠标就搞定
-
填完点保存,表就建好了,不用写 DDL!
数据操作
8.2 MySQL Workbench:官方免费工具
Workbench 是 MySQL 官方出的免费工具,不用花钱,功能也很全。
操作和 Navicat 差不多,新手也能很快上手,而且是官方的,兼容性最好。
第九章:数据备份与恢复:防止数据丢了
新手最容易忽略的就是备份!等你误删了库,才发现没备份,哭都来不及!
我们用 MySQL 自带的mysqldump工具,这是最常用的逻辑备份工具,简单好用。
⚠️ 注意:mysqldump 是终端命令,要在 CMD/Linux 终端里执行,不是在 MySQL 客户端里!
9.1 备份操作
1. 单库备份(最常用)
1
2
|
# 备份test_db库,生成sql文件
mysqldump -u backup_user -p --default-character-set=utf8mb4 --single-transaction test_db > D:mysql_backuptest_db_backup.sql
|
2. 只备份表结构,不备份数据
1
2
|
# 只备份结构,用来迁移表结构
mysqldump -u root -p --no-data test_db > D:mysql_backuptest_db_struct.sql
|
3. 全实例备份,备份所有库
1
2
|
# 备份整个MySQL的所有库,用来迁移服务器
mysqldump -u root -p --all-databases > D:mysql_backupfull_backup.sql
|
9.2 恢复操作
1. 单库恢复
1
2
3
4
|
# 先创建空库
mysql -u root -p -e "CREATE DATABASE IF NOT EXISTS test_db DEFAULT CHARSET utf8mb4"
# 恢复备份
mysql -u root -p test_db < D:mysql_backuptest_db_backup.sql
|
2. 客户端里恢复
1
2
3
|
-- 也可以在MySQL客户端里用source命令
USE test_db;
source D:/mysql_backup/test_db_backup.sql; -- 注意路径用正斜杠
|
9.3 备份避坑
-
定期备份:最好每天自动备份,不要手动
-
备份后要验证:备份完了打开 sql 文件看看,有没有内容,别备份了个空文件
-
定期恢复演练:别等出事了才发现备份是坏的
-
备份路径不要有中文:不然会报错
第十章:完整实战:电商订单系统
学了这么多,我们来做一个完整的实战案例,电商订单系统,把所有知识点串起来!
10.1 建库建表
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
|
-- 1. 创建数据库
CREATE DATABASE IF NOT EXISTS shop CHARACTER SET utf8mb4;
USE shop;

-- 2. 用户表
CREATE TABLE users (
    id INT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '用户ID',
    username VARCHAR(50) NOT NULL UNIQUE COMMENT '用户名',
    phone VARCHAR(20) NOT NULL COMMENT '手机号',
    status TINYINT DEFAULT 1 COMMENT '状态:1启用0禁用',
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP COMMENT '注册时间',
    PRIMARY KEY (id),
    INDEX idx_phone (phone)
) ENGINE=InnoDB COMMENT='用户表';

-- 3. 商品表
CREATE TABLE products (
    id INT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '商品ID',
    name VARCHAR(200) NOT NULL COMMENT '商品名称',
    price DECIMAL(10,2) UNSIGNED NOT NULL COMMENT '价格',
    stock INT UNSIGNED DEFAULT 0 COMMENT '库存',
    status TINYINT DEFAULT 1 COMMENT '上架状态',
    PRIMARY KEY (id),
    INDEX idx_name (name)
) ENGINE=InnoDB COMMENT='商品表';

-- 4. 订单表
CREATE TABLE orders (
    id INT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '订单ID',
    user_id INT UNSIGNED NOT NULL COMMENT '用户ID',
    total_amount DECIMAL(10,2) UNSIGNED NOT NULL COMMENT '订单金额',
    status ENUM('pending','paid','shipped','completed','cancelled') DEFAULT 'pending' COMMENT '订单状态',
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
    paid_at TIMESTAMP NULL COMMENT '支付时间',
    PRIMARY KEY (id),
    INDEX idx_user (user_id),
    INDEX idx_status (status),
    FOREIGN KEY (user_id) REFERENCES users(id)
) ENGINE=InnoDB COMMENT='订单表';
|
10.2 插入测试数据
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
|
-- 插入用户
INSERT INTO users(username, phone) VALUES
('张三', '13800138001'),
('李四', '13800138002'),
('王五', '13800138003');

-- 插入商品
INSERT INTO products(name, price, stock) VALUES
('笔记本电脑', 5999.00, 10),
('无线鼠标', 89.90, 100),
('机械键盘', 299.00, 50);

-- 插入订单
INSERT INTO orders(user_id, total_amount, status) VALUES
(1, 5999.00, 'paid'),
(1, 388.90, 'completed'),
(2, 89.90, 'pending');
|
10.3 复杂查询实战
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
|
-- 1. 查询每个用户的订单数和消费总额
SELECT
    u.username,
    COUNT(o.id) AS 订单数,
    IFNULL(SUM(o.total_amount), 0) AS 消费总额
FROM users u
LEFT JOIN orders o ON u.id = o.user_id
GROUP BY u.id
ORDER BY 消费总额 DESC;

-- 2. 查询已支付的订单,关联用户和商品
-- (这里我们可以扩展订单详情表,不过新手先理解这个)
|
第十一章:必避的 10 个坑
最后,总结一下最容易踩的坑,帮你少走弯路:
-
UPDATE/DELETE 忘记加 WHERE:这是最常见的,一不小心全表数据没了,执行前先 SELECT 看看对不对
-
字符集乱码:建库建表一定要用 utf8mb4,不要用 latin1,备份恢复也要指定字符集
-
密码忘记:root 密码一定要记牢,重置密码很麻烦
-
外键导致删不了表:有外键关联的话,要先删从表,或者关掉外键校验
-
大表 SELECT:大表查所有字段,会把数据库卡死,要啥查啥,加 LIMIT
-
长事务:事务不要开太久,会锁表,影响业务
-
索引建太多:索引不是越多越好,会拖慢增删改的速度
-
备份不验证:备份完了一定要看看备份文件有没有内容,别备份了个空的
-
root 用户到处用:生产环境不要用 root,要创建专用用户,最小权限原则
-
路径有中文:MySQL 对中文路径兼容性差,安装、备份的路径都用英文
附录:SQL 速查表
| 操作 |
SQL 语句 |
| 创建数据库 |
CREATE DATABASE db DEFAULT CHARSET utf8mb4; |
| 切换数据库 |
USE db; |
| 建表 |
CREATE TABLE t(id INT PRIMARY KEY AUTO_INCREMENT, name VARCHAR(50)); |
| 插入 |
INSERT INTO t(name) VALUES('test'); |
| 更新 |
UPDATE t SET name='test2' WHERE id=1; |
| 删除 |
DELETE FROM t WHERE id=1; |
| 查询 |
SELECT * FROM t WHERE id=1; |
| 分页 |
SELECT * FROM t LIMIT 0,10; |
| 排序 |
SELECT * FROM t ORDER BY id DESC; |
| 分组 |
SELECT name,COUNT(*) FROM t GROUP BY name; |
写在最后
MySQL 是一个入门简单但内涵丰富的工具,这份教程带你从零基础入门,到掌握生产级的技能。学习数据库最重要的就是多练,把这些 SQL 都自己敲一遍,做几个小项目,很快就能上手了。
希望这份教程能帮你彻底搞定 MySQL,开启你的数据之旅!