前言
MongoDB 作为当前最流行的文档型 NoSQL 数据库,凭借其灵活的文档模型、强大的扩展能力和卓越的性能,已经成为现代互联网应用架构中不可或缺的一环。无论是初创公司的快速迭代,还是巨头企业的海量数据存储,MongoDB 都展现出了极强的适应性。
本指南旨在为你提供一份从零基础到生产实战的完整学习路径。我们将从最基础的概念讲起,逐步深入到高级查询、索引优化、分布式架构,最后结合 Python 实战,帮助你彻底打通 MongoDB 的任督二脉。
无论你是刚入门的后端开发新手,还是希望深入优化数据库性能的资深工程师,这份指南都能为你提供详实的参考。
第一章:MongoDB 核心认知
1.1 什么是 MongoDB?
MongoDB 是一个开源、跨平台、面向文档的非关系型数据库。它将数据存储为一个文档,数据结构由键值对组成,类似于 JSON 对象,但采用二进制的 BSON 格式进行存储和传输,这使得它能够支持更丰富的数据类型和更快的解析速度。
核心特性:
-
灵活的文档模型:无需预定义 Schema,字段可以动态添加,完美适配需求快速变化的业务。
-
强大的索引支持:支持单字段、复合、地理空间、全文等多种索引类型。
-
高可用:通过副本集(Replica Set)实现数据自动备份和故障转移。
-
水平扩展:通过分片(Sharding)技术,将数据分散到多台机器,轻松应对 PB 级数据。
-
丰富的查询语言:支持聚合、事务、Graph 查询等复杂操作。
1.2 核心概念与术语
对于从关系型数据库(如 MySQL)转过来的开发者,理解下面的对应关系至关重要:
| MongoDB 术语 |
MySQL 术语 |
说明 |
| Database (数据库) |
Database (数据库) |
数据的物理容器,一个 MongoDB 实例可以包含多个 Database |
| Collection (集合) |
Table (表) |
一组文档的集合,类似于关系型数据库中的表 |
| Document (文档) |
Row (行) |
一条记录,以 BSON 格式存储,类似于 JSON 对象 |
| Field (字段) |
Column (列) |
文档中的一个属性,类似于表中的列 |
| Index (索引) |
Index (索引) |
加速查询的数据结构 |
| Primary Key (主键) |
Primary Key (主键) |
MongoDB 自动提供 _id 字段作为主键 |
1.3 BSON 数据类型
MongoDB 使用 BSON(Binary JSON)来存储数据,它比 JSON 支持更多的数据类型:
-
String:字符串,必须是 UTF-8 编码。
-
Integer:整型,32 位或 64 位,取决于环境。
-
Boolean:布尔值,true 或 false。
-
Double:双精度浮点型。
-
ObjectId:12 字节的唯一 ID,用于文档的唯一标识。
-
Array:数组,列表或有序集合。
-
Object:嵌套文档。
-
Date:日期时间,存储为从 Unix 纪元开始的毫秒数。
-
Binary:二进制数据,用于存储二进制流。
-
Code:JavaScript 代码。
_id 解析:默认的 _id 字段是一个 ObjectId,它不是随机的,而是包含了时间戳、机器码、进程 ID 和自增计数器,因此你可以直接从中提取创建时间:ObjectId("507f1f77bcf86cd799439011").getTimestamp()
1.4 MongoDB vs MySQL:该如何选择?
很多人会问,MongoDB 和 MySQL 到底哪个好?其实没有绝对的好坏,只有适合不适合。
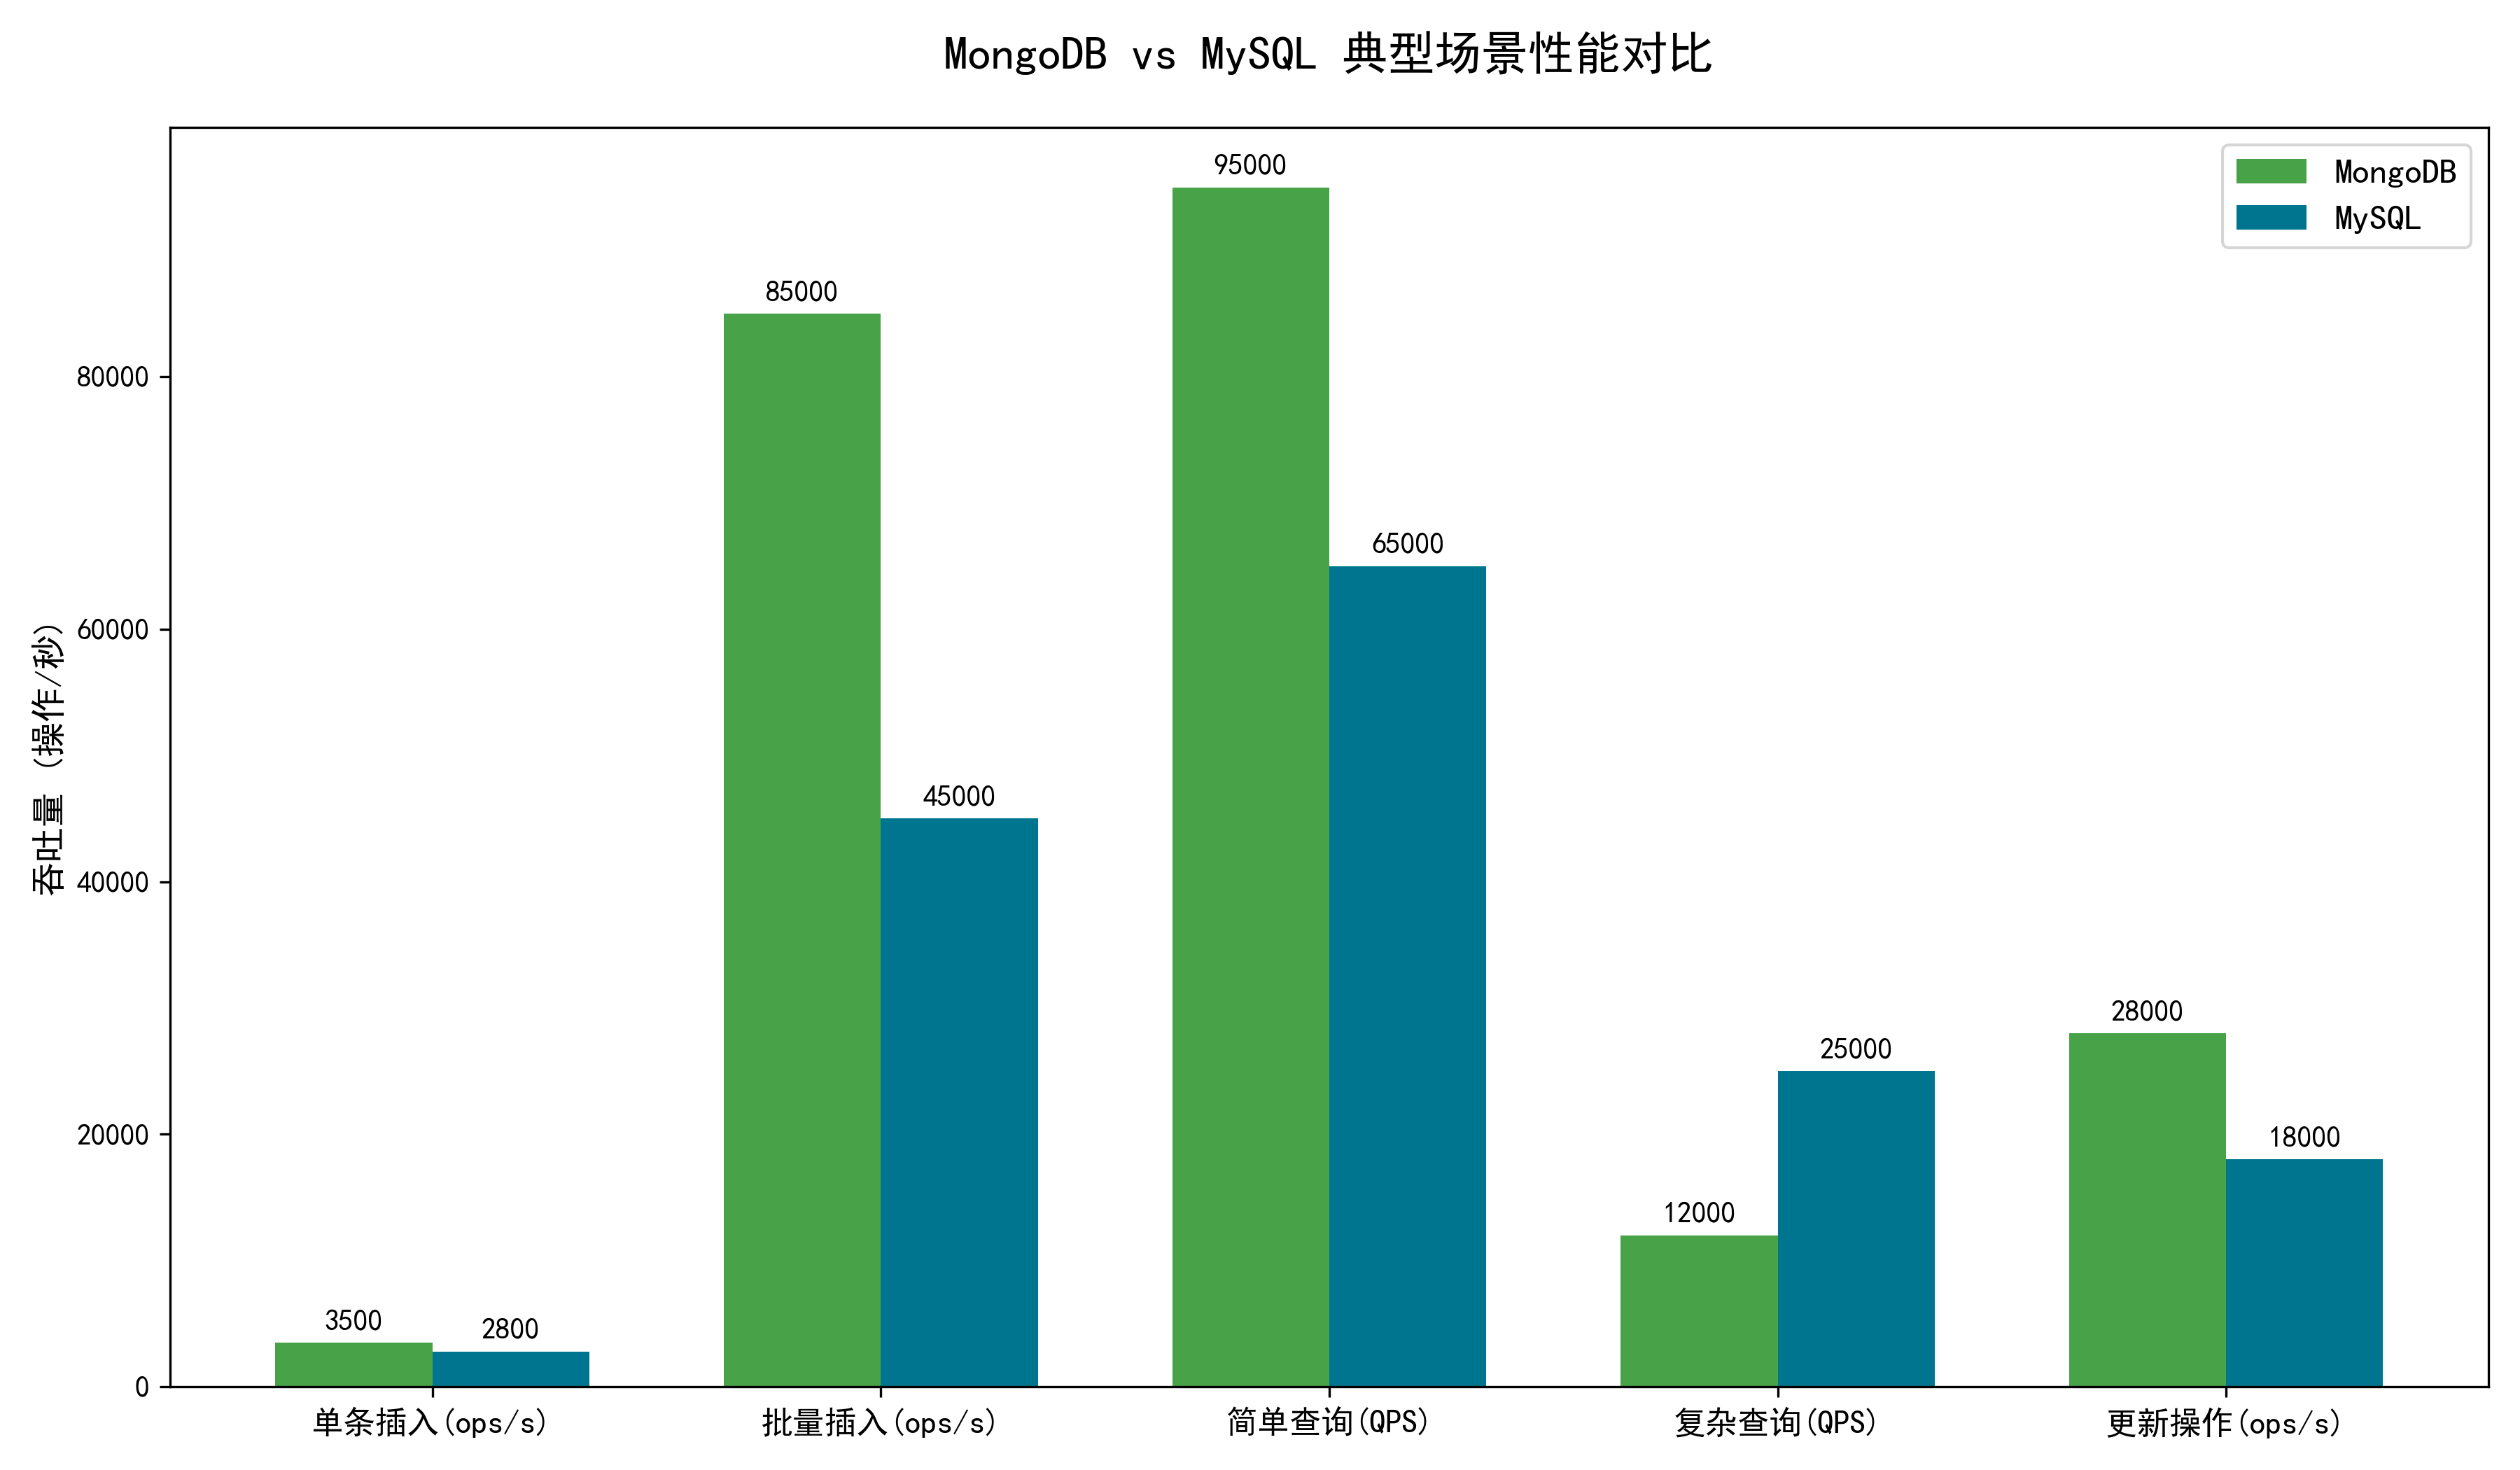
MongoDB 更适合:
-
数据结构频繁变化:电商商品属性、用户画像、内容管理系统。
-
海量数据读写:日志系统、物联网设备数据、用户行为埋点。
-
高并发读写:社交网络的 Feed 流、实时数据统计。
-
地理位置查询:LBS 服务、附近的人 / 商家。
-
快速开发迭代:初创项目,需求频繁变动。
MySQL 更适合:
第二章:环境搭建与部署
MongoDB 支持全平台部署,下面我们介绍几种最常用的安装方式。
2.1 Docker 一键部署(推荐开发环境)
对于开发和测试环境,使用 Docker 是最快的方式,一行命令即可启动。
1
2
3
4
5
6
7
|
# 拉取镜像并启动
docker run -d \
  --name mongodb \
  -p 27017:27017 \
  -e MONGO_INITDB_ROOT_USERNAME=admin \
  -e MONGO_INITDB_ROOT_PASSWORD=your_strong_password \
  mongo:7.0
|
如果你需要持久化数据,可以挂载数据卷:
1
2
3
4
5
6
7
8
|
docker volume create mongo_data
docker run -d \
  --name mongodb \
  -p 27017:27017 \
  -v mongo_data:/data/db \
  -e MONGO_INITDB_ROOT_USERNAME=admin \
  -e MONGO_INITDB_ROOT_PASSWORD=your_strong_password \
  mongo:7.0
|
2.2 Linux 系统安装(生产环境推荐)
以 Ubuntu 20.04/22.04 为例:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
|
# 1. 导入公钥
wget -qO - https://www.mongodb.org/static/pgp/server-7.0.asc | sudo apt-key add -

# 2. 添加源
echo "deb [ arch=amd64,arm64 ] https://repo.mongodb.org/apt/ubuntu $(lsb_release -cs)/mongodb-org/7.0 multiverse" | sudo tee /etc/apt/sources.list.d/mongodb-org-7.0.list

# 3. 安装
sudo apt-get update
sudo apt-get install -y mongodb-org

# 4. 启动服务
sudo systemctl start mongod
sudo systemctl enable mongod

# 5. 验证
sudo systemctl status mongod
|
2.3 Windows 系统安装
-
前往 MongoDB 下载中心 下载 MSI 安装包。
-
运行安装程序,选择 “Complete” 安装。
-
安装向导会自动将 MongoDB 安装为 Windows 服务。
-
安装完成后,在命令行输入 mongo 即可连接。
2.4 连接数据库
安装完成后,使用 mongosh(新版的 MongoDB Shell)连接数据库:
1
2
3
4
5
|
# 本地无认证连接
mongosh

# 带账号密码连接
mongosh "mongodb://admin:your_strong_password@localhost:27017/?authSource=admin"
|
第三章:基础操作:CRUD 增删改查
掌握了连接之后,我们来学习最基础的增删改查操作。所有的操作都围绕着集合(Collection)进行。
3.1 数据库与集合管理
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
|
// 查看所有数据库
show dbs

// 切换/创建数据库(插入数据后才会真正创建)
use test_db

// 查看当前数据库
db

// 查看当前数据库下的集合
show collections

// 创建集合(可选,插入数据时自动创建)
db.createCollection("users")

// 删除集合
db.users.drop()

// 删除当前数据库
db.dropDatabase()
|
3.2 插入文档(Create)
MongoDB 提供了 insertOne 和 insertMany 两个方法。
插入单个文档
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
db.users.insertOne({
  name: "张三",
  age: 25,
  email: "zhangsan@example.com",
  hobbies: ["篮球", "游戏"],
  address: {
    province: "广东",
    city: "深圳"
  },
  createTime: new Date()
})
|
返回结果会包含自动生成的 _id:
1
2
3
4
|
{
  "acknowledged" : true,
  "insertedId" : ObjectId("662f...")
}
|
插入多个文档
1
2
3
4
5
|
db.users.insertMany([
  { name: "李四", age: 28, gender: "female" },
  { name: "王五", age: 30, gender: "male" },
  { name: "赵六", age: 26, gender: "female" }
])
|
3.3 查询文档(Read)
查询是 MongoDB 最强大的部分之一。
基础查询
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
// 查询所有文档
db.users.find()

// 查询单个文档(返回第一条匹配的)
db.users.findOne({ name: "张三" })

// 条件查询
db.users.find({ age: 25 }) // age 等于 25
db.users.find({ age: { $gt: 25 } }) // age 大于 25
db.users.find({ age: { $gte: 25, $lt: 30 } }) // 25 <= age < 30
db.users.find({ name: { $ne: "张三" } }) // name 不等于 张三
|
常用查询运算符
| 运算符 |
作用 |
示例 |
$gt |
大于 |
{ age: { $gt: 25 } } |
$gte |
大于等于 |
{ age: { $gte: 25 } } |
$lt |
小于 |
{ age: { $lt: 30 } } |
$lte |
小于等于 |
{ age: { $lte: 30 } } |
$ne |
不等于 |
{ age: { $ne: 25 } } |
$in |
包含在数组中 |
{ age: { $in: [25, 30] } } |
$nin |
不包含在数组中 |
{ age: { $nin: [25, 30] } } |
$and |
逻辑与 |
$and: [ {age: 25}, {name: "张三"} ] |
$or |
逻辑或 |
$or: [ {age: 25}, {name: "张三"} ] |
数组查询
1
2
3
4
5
6
7
8
|
// 包含某个元素
db.users.find({ hobbies: "篮球" })

// 包含所有指定元素
db.users.find({ hobbies: { $all: ["篮球", "游戏"] } })

// 数组长度
db.users.find({ hobbies: { $size: 2 } })
|
嵌套文档查询
1
2
3
4
5
|
// 精确匹配整个嵌套文档
db.users.find({ address: { province: "广东", city: "深圳" } })

// 点表示法,匹配单个字段(推荐)
db.users.find({ "address.city": "深圳" })
|
分页、排序、投影
1
2
3
4
5
6
7
8
|
// 排序:1 升序,-1 降序
db.users.find().sort({ age: -1 }) // 按年龄倒序

// 分页:skip 跳过,limit 限制
db.users.find().skip(10).limit(10) // 第2页,每页10条

// 投影:只返回指定字段,1 显示,0 隐藏
db.users.find({}, { name: 1, age: 1, _id: 0 })
|
3.4 更新文档(Update)
更新操作需要使用更新操作符,否则会直接替换整个文档。
更新单个文档
1
2
3
4
5
|
// $set:只更新指定字段,推荐!
db.users.updateOne(
  { name: "张三" }, // 条件
  { $set: { age: 26, email: "new_email@example.com" } } // 更新内容
)
|
更新多个文档
1
2
3
4
5
|
// 给所有年龄小于18岁的用户添加一个字段
db.users.updateMany(
  { age: { $lt: 18 } },
  { $set: { isMinor: true } }
)
|
常用更新运算符
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
|
// $inc:字段自增
db.users.updateOne({ name: "张三" }, { $inc: { age: 1 } }) // 年龄+1

// $push:向数组添加元素
db.users.updateOne({ name: "张三" }, { $push: { hobbies: "游泳" } })

// $addToSet:向数组添加元素,不存在才添加(去重)
db.users.updateOne({ name: "张三" }, { $addToSet: { hobbies: "游泳" } })

// $pull:从数组删除元素
db.users.updateOne({ name: "张三" }, { $pull: { hobbies: "游戏" } })

// $unset:删除字段
db.users.updateOne({ name: "张三" }, { $unset: { isMinor: 1 } })
|
Upsert 操作
如果找不到匹配的文档,就插入一个新的:
1
2
3
4
5
|
db.users.updateOne(
  { name: "钱七" },
  { $set: { age: 27 } },
  { upsert: true } // 开启 upsert
)
|
3.5 删除文档(Delete)
1
2
3
4
5
6
7
8
|
// 删除单个文档
db.users.deleteOne({ name: "赵六" })

// 删除多个文档
db.users.deleteMany({ age: { $lt: 18 } })

// 删除所有文档(保留集合)
db.users.deleteMany({})
|
⚠️ 警告:执行 deleteMany({}) 会清空整个集合,且无法回滚!生产环境操作前务必确认条件!
第四章:索引与性能优化
索引是数据库性能的关键。合理的索引可以将查询速度从秒级提升到毫秒级。
4.1 索引基础
MongoDB 的索引使用 B 树数据结构,与 MySQL 类似。默认情况下,所有集合都会在 _id 字段上创建一个唯一索引。
创建索引
1
2
3
4
5
6
7
8
|
// 单字段索引:1 升序,-1 降序
db.users.createIndex({ age: 1 })

// 复合索引:多个字段组合
db.orders.createIndex({ status: 1, createdAt: -1 })

// 唯一索引:确保字段值不重复
db.users.createIndex({ email: 1 }, { unique: true })
|
索引管理
1
2
3
4
5
6
7
8
|
// 查看集合的所有索引
db.users.getIndexes()

// 查看索引大小
db.users.totalIndexSize()

// 删除索引
db.users.dropIndex("age_1")
|
4.2 复合索引与 ESR 原则
创建复合索引时,字段的顺序至关重要。业界有一个著名的 ESR 原则:
Equality(等值匹配) -> Sort(排序) -> Range(范围查询)
为什么?
-
等值字段:用来快速定位到具体的行,应该放在最前面。
-
排序字段:让数据库在取出数据后不需要再内存排序,可以直接按索引顺序返回。
-
范围字段:放在最后,因为范围查询会导致后面的字段索引失效。
示例:
查询:status = "completed" AND amount > 100 ORDER BY createdAt DESC
错误的索引:{status: 1, amount: 1, createdAt: -1}
正确的索引:{status: 1, createdAt: -1, amount: 1}
4.3 高级索引类型
1. 部分索引(Partial Index)
只对符合条件的文档建立索引,大大减小索引体积。
1
2
3
4
5
|
// 只对已支付的订单建立索引,草稿订单不索引
db.orders.createIndex(
  { userId: 1, createdAt: -1 },
  { partialFilterExpression: { status: { $ne: "draft" } } }
)
|
2. 稀疏索引(Sparse Index)
只对包含特定字段的文档建立索引,适合字段可选的情况。
1
2
|
// 很多用户没有手机号,只对有手机号的用户建立索引
db.users.createIndex({ phone: 1 }, { sparse: true })
|
3. 覆盖索引(Covering Index)
如果查询的所有字段都在索引中,数据库就不需要去磁盘读取文档,直接返回索引数据,速度极快。
1
2
3
4
5
|
// 索引包含查询条件和返回字段
db.orders.createIndex({ status: 1, userId: 1, total: 1 })

// 查询只返回这几个字段,就是覆盖查询
db.orders.find({ status: "completed", userId: 123 }, { status: 1, userId: 1, total: 1, _id: 0 })
|
4.4 索引失效场景
即使建了索引,某些写法也会导致索引失效,触发全表扫描:
-
使用函数或表达式:db.users.find({ $where: "this.age + 10 > 30" })
-
正则非前缀匹配:db.users.find({ name: /zhang/ })(应该用 /^zhang/)
-
不满足最左前缀:复合索引 {a:1, b:1},只查 b 会失效。
-
**使用 **$ne 或 $not:有时候会导致索引失效。
-
数据类型不匹配:字段是 Number,你传了 String。
4.5 慢查询分析
如何找到慢查询?MongoDB 内置了分析工具。
1
2
3
4
5
6
7
8
|
// 开启慢查询日志,记录所有超过 100ms 的操作
db.setProfilingLevel(1, { slowms: 100 })

// 查看最近的慢查询
db.system.profile.find().sort({ ts: -1 }).limit(10)

// 查看执行计划,分析查询是否走了索引
db.users.find({ age: { $gt: 25 } }).explain("executionStats")
|
重点看 explain 的结果:
-
stage: "IXSCAN":索引扫描,正常。
-
stage: "COLLSCAN":全集合扫描,有问题!
-
executionTimeMillis:执行时间。
-
totalDocsExamined:扫描的文档数,如果远大于 nReturned,说明索引没建好。
第五章:高级查询特性
除了基础的 CRUD,MongoDB 还有很多强大的高级特性。
5.1 地理空间查询(LBS)
MongoDB 原生支持地理位置查询,完美适配外卖、网约车、同城社交等场景。
1. 存储格式
地理数据使用 GeoJSON 格式:
1
2
3
4
5
6
7
|
{
  name: "肯德基",
  location: {
    type: "Point",
    coordinates: [113.327, 23.125] // 注意:先经度,后纬度!
  }
}
|
2. 创建地理索引
1
|
db.merchants.createIndex({ location: "2dsphere" })
|
3. 查询附近的商家
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
|
// 查询我当前位置(113.330, 23.127)附近3公里内的商家
db.merchants.find({
  location: {
    $near: {
      $geometry: {
        type: "Point",
        coordinates: [113.330, 23.127]
      },
      $maxDistance: 3000 // 单位:米
    }
  }
})
|
4. 查询某个区域内的商家
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
|
// 查询某个多边形商圈内的商家
db.merchants.find({
  location: {
    $geoWithin: {
      $geometry: {
        type: "Polygon",
        coordinates: [[
          [113.320, 23.120],
          [113.340, 23.120],
          [113.340, 23.140],
          [113.320, 23.140],
          [113.320, 23.120]
        ]]
      }
    }
  }
})
|
5.2 全文检索
MongoDB 内置了全文索引,可以实现轻量级的搜索功能,无需额外部署 Elasticsearch。
1
2
3
4
5
6
7
8
|
// 创建全文索引,支持多个字段
db.goods.createIndex({ name: "text", description: "text", tags: "text" })

// 搜索包含 "苹果" 或 "华为" 的商品
db.goods.find(
  { $text: { $search: "苹果 华为" } },
  { score: { $meta: "textScore" } } // 返回相关性分数
).sort({ score: { $meta: "textScore" } }) // 按相关性排序
|
5.3 游标操作
当查询结果很大时,MongoDB 使用游标来分批返回数据,避免一次性加载所有数据到内存。
1
2
3
4
5
6
7
8
9
|
let cursor = db.users.find()

// 手动遍历
while (cursor.hasNext()) {
  printjson(cursor.next())
}

// 设置批量大小
cursor.batchSize(100)
|
第六章:聚合框架
聚合框架(Aggregation Framework)是 MongoDB 用于数据分析和统计的利器,它类似于 SQL 中的 GROUP BY、JOIN,但更强大。
聚合框架采用 ** 管道(Pipeline)** 模式:数据像流水线一样,依次通过多个阶段(Stage)进行处理。
6.1 常用管道阶段
| 阶段 |
SQL 等价操作 |
作用 |
$match |
WHERE |
过滤数据 |
$group |
GROUP BY |
分组统计 |
$sort |
ORDER BY |
排序 |
$limit / $skip |
LIMIT / OFFSET |
分页 |
$project |
SELECT |
投影,修改字段 |
$lookup |
LEFT JOIN |
关联查询 |
$unwind |
- |
拆分数组 |
$facet |
- |
多维度统计 |
6.2 分组统计示例
场景:统计每个省份的用户数量,以及平均年龄。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
db.users.aggregate([
  {
    $group: {
      _id: "$address.province", // 按省份分组
      count: { $sum: 1 }, // 计数
      avgAge: { $avg: "$age" }, // 平均年龄
      maxAge: { $max: "$age" }, // 最大年龄
      names: { $push: "$name" } // 收集所有名字
    }
  }
])
|
6.3 关联查询($lookup)
MongoDB 3.2+ 支持关联查询,实现了类似 SQL 的 Join 功能。
场景:查询订单,同时关联查询出订单对应的用户信息。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
|
db.orders.aggregate([
  {
    $lookup: {
      from: "users", // 关联的集合
      localField: "userId", // 本集合的关联字段
      foreignField: "_id", // 关联集合的关联字段
      as: "userInfo" // 输出的字段名
    }
  },
  // 因为 lookup 返回的是数组,我们用 $arrayElemAt 取出第一个元素
  {
    $addFields: {
      userInfo: { $arrayElemAt: ["$userInfo", 0] }
    }
  }
])
|
6.4 多维度统计($facet)
$facet 允许你在一次查询中,对同一输入数据执行多个聚合管道,非常适合实现报表的多维度统计。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
|
db.orders.aggregate([
  {
    $facet: {
      // 维度1:按状态分类统计
      byStatus: [
        { $group: { _id: "$status", count: { $sum: 1 } } }
      ],
      // 维度2:按月统计销售额
      byMonth: [
        { $group: { _id: { $month: "$createTime" }, total: { $sum: "$amount" } } }
      ],
      // 维度3:Top10 用户
      topUsers: [
        { $group: { _id: "$userId", total: { $sum: "$amount" } } },
        { $sort: { total: -1 } },
        { $limit: 10 }
      ]
    }
  }
])
|
第七章:事务
从 MongoDB 4.0 开始,MongoDB 支持了多文档事务,保证 ACID 特性。
7.1 事务的使用
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
|
// 开启会话
const session = db.getMongo().startSession()
session.startTransaction()

try {
  // 在事务中执行操作
  const users = session.getDatabase("test").users
  const accounts = session.getDatabase("test").accounts

  // 操作1:扣减余额
  accounts.updateOne(
    { userId: ObjectId("...") },
    { $inc: { balance: -100 } },
    { session }
  )

  // 操作2:增加积分
  users.updateOne(
    { _id: ObjectId("...") },
    { $inc: { points: 100 } },
    { session }
  )

  // 提交事务
  session.commitTransaction()
} catch (e) {
  // 出错回滚
  session.abortTransaction()
  throw e
} finally {
  session.endSession()
}
|
7.2 注意事项
第八章:高可用与分布式架构
当你的业务越来越大,单机已经无法满足需求时,就需要用到 MongoDB 的分布式架构。
8.1 副本集(Replica Set):高可用
副本集是一组 MongoDB 服务器,它们维护着相同的数据副本。它的作用是:
架构:
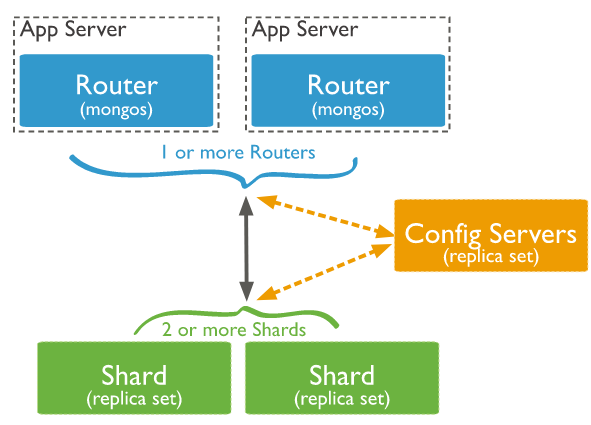
8.2 分片集群(Sharding):水平扩展
当数据量太大,单台机器存不下,或者读写 QPS 太高,单机扛不住时,就需要分片。
分片就是把一个大集合的数据,切分成小块,分散到不同的机器(Shard)上存储。
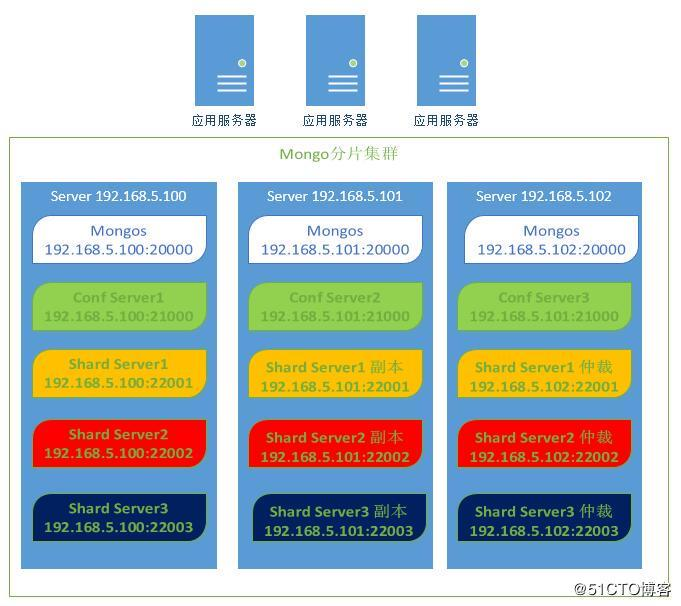
分片集群的三大组件:
-
Shard(分片):存储实际的数据,每个 Shard 本身就是一个副本集,保证高可用。
-
Config Server(配置服务器):存储集群的元数据,比如数据存在哪个分片上。它也必须是副本集。
-
Mongos(路由):客户端的入口。它负责把客户端的请求路由到正确的 Shard 上,对客户端透明。
分片键(Shard Key):
分片的核心是选择分片键,它决定了数据如何分布。
第九章:Python 实战:PyMongo
讲了这么多 Shell 命令,我们来看看在实际的 Python 开发中如何使用 MongoDB。
9.1 安装与连接
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
|
from pymongo import MongoClient
from pymongo.errors import ConnectionFailure, OperationFailure

# 连接数据库
client = MongoClient(
    "mongodb://admin:your_strong_password@localhost:27017/?authSource=admin",
    maxPoolSize=50,  # 连接池最大连接数
    minPoolSize=5    # 最小空闲连接
)

# 测试连接
try:
    client.admin.command('ping')
    print("连接成功!")
except ConnectionFailure:
    print("服务器不可达")
|
9.2 增删改查
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
|
# 获取数据库和集合
db = client["test_db"]
users_col = db["users"]

# 1. 插入
result = users_col.insert_one({
    "name": "张三",
    "age": 25,
    "hobbies": ["篮球", "游戏"]
})
print("插入ID:", result.inserted_id)

# 2. 查询
user = users_col.find_one({"name": "张三"})
print(user)

# 条件查询
for user in users_col.find({"age": {"$gt": 20}}).sort("age", -1):
    print(user)

# 3. 更新
users_col.update_one(
    {"name": "张三"},
    {"$set": {"age": 26}}
)

# 4. 删除
users_col.delete_one({"name": "张三"})
|
9.3 单例工具类封装
在项目中,我们通常会封装一个 MongoDB 工具类,保证全局只有一个连接。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
|
from pymongo import MongoClient
from pymongo.errors import ServerSelectionTimeoutError

class MongoUtil:
    _instance = None
    _client = None

    def __init__(self):
        # 配置从配置文件读取
        self.uri = "mongodb://admin:password@localhost:27017/?authSource=admin"
        self.db_name = "test_db"
        self._init_client()

    @classmethod
    def get_instance(cls):
        if not cls._instance:
            cls._instance = MongoUtil()
        return cls._instance

    def _init_client(self):
        try:
            self._client = MongoClient(
                self.uri,
                maxPoolSize=100,
                serverSelectionTimeoutMS=5000
            )
            self._client.admin.command('ping')
        except Exception as e:
            raise Exception(f"MongoDB连接失败: {e}")

    def get_db(self):
        return self._client[self.db_name]

    def get_collection(self, col_name):
        return self.get_db()[col_name]

# 使用
mongo = MongoUtil.get_instance()
users_col = mongo.get_collection("users")
|
第十章:生产环境运维与最佳实践
10.1 监控
10.2 备份恢复
10.3 最佳实践
-
永远不要在生产环境开启公网访问,使用内网或 VPN。
-
永远开启认证,不要使用匿名访问。
-
合理设计 Schema,优先使用嵌入式文档,减少 Join。
-
不要过度索引,每个索引都会拖慢写入速度。
-
禁止大事务,事务会锁住资源,影响性能。
-
分页优化:深分页(大 skip)很慢,用 _id 游标分页代替。
参考资料
-
MongoDB Official Documentation
-
MongoDB Performance Tuning (Apress, 2021)
-
MongoDB 7.x 全平台部署指南
-
PyMongo 官方文档
Date: 2026-05-04
Version: MongoDB 7.0