Deformable Beta Splatting 论文解读与分享
本文根据本人对 Deformable Beta Splatting 论文的理解,结合论文中的实验结果和作者的分析,对该方法的核心创新、实验验证以及潜在的局限性进行了详细的解读与总结。同时也用于记录和分享该方法的核心思想和技术细节,方便后续的学习和参考。
- 成果展示:https://rongliu-leo.github.io/beta-splatting/
- 论文链接:https://dl.acm.org/doi/epdf/10.1145/3721238.3730716
- 代码链接:https://github.com/RongLiu-Leo/beta-splatting.git
一、先搞懂:这篇论文到底在解决什么问题?
1.1 前置知识:从NeRF到3DGS,实时3D渲染的演进
在讲DBS之前,我们先快速搞懂两个核心技术背景,不然所有原理都听不懂:
- NeRF(神经辐射场)
NeRF用神经网络把整个3D场景“编码”进去,能生成照片级逼真的新视角画面,但有两个致命缺陷:
- 渲染速度极慢,生成一张图要大量神经网络计算,完全做不到实时;
- 隐式的场景表示,没法和游戏引擎、工业建模软件(偏好显式几何)兼容。
- 3DGS(3D高斯溅射) 3DGS彻底抛弃了神经网络,把3D场景拆成无数个3D高斯椭球(可以理解成3D空间里的一个个小光斑/小颜料点)。每个椭球自带位置、大小、旋转、不透明度、颜色等参数,直接把这些椭球“喷”(splatting/溅射)到2D屏幕上,就能完成渲染。 它的核心突破是:实现了3D场景的实时渲染,同时画质接近NeRF,瞬间成了3D渲染领域的顶流。
1.2 3DGS的致命短板:为什么实时了,效果还是不够好?
3DGS虽然火,但它的渲染质量始终比不过顶级的NeRF方法,核心问题出在它的两个基础组件,还有配套的优化策略上,这也是DBS要解决的核心痛点:
| 3DGS的核心组件 | 致命缺陷 | 直观后果 |
|---|---|---|
| 高斯核(几何表示) | 1. 无界+长尾:高斯函数理论上取值范围是无限的,离中心再远也有值,实时渲染必须硬编码截断,引入截断伪影; 2. 天生平滑:高斯函数是钟形曲线,本质就会让画面模糊 |
锐利边缘闪烁/破碎、平坦表面画糊、精细纹理丢失 |
| 低阶球谐函数SH(视点相关颜色编码) | 1. 参数量爆炸:SH阶数越高,参数量按平方增长,实时渲染只能用低阶SH; 2. 只能表达平滑颜色变化,完全没法建模锐利的镜面高光 |
金属、玻璃、光滑塑料的反光糊成一片,没有真实质感 |
| 致密化/优化策略 | 3DGS和后续的3DGS-MCMC的增减点策略,完全和高斯核的数学特性绑定,换个核函数就用不了 | 想给3DGS换更好的核,却没有配套的优化方法,效果上不去 |
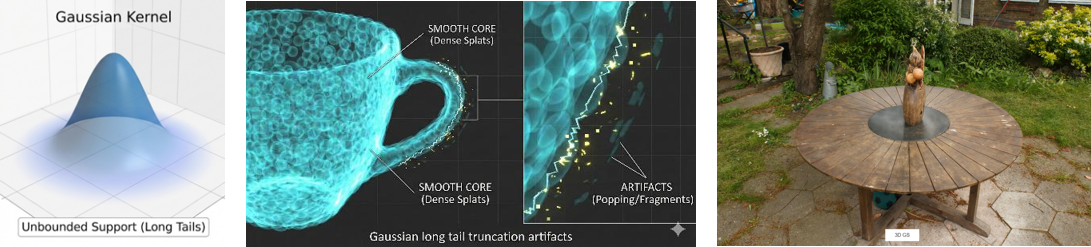
简单说:这篇论文的核心目标,就是给3DGS做一次“换心手术”——换掉有缺陷的高斯核和球谐函数,再配套一个通用的优化策略,实现画质更好、参数更少、渲染更快的全面突破。
二、DBS的核心解决方案:三大创新一次性讲透
DBS(可变形Beta溅射)的所有能力,都来自三个环环相扣的核心创新,我们逐个拆解得明明白白。
2.1 创新一:可变形Beta核——换掉高斯核,从根源解决几何模糊和伪影
DBS的第一个核心动作,就是用Beta核彻底替换了3DGS里的高斯核,从数学根源上解决了高斯核的所有缺陷。
2.1.1 Beta核是怎么来的?从Beta分布到Beta核函数
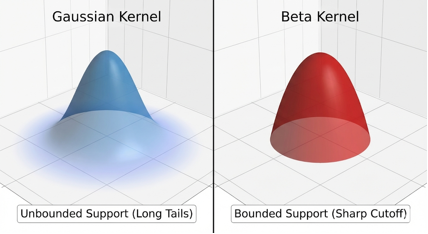
Beta核的灵感来自统计学里经典的Beta分布,它的核心特点是:天然定义在[0,1]的闭区间里,超过区间的地方值直接为0,完美解决高斯核的无界长尾问题。
原始Beta分布的公式是: $$f(x;\alpha,\beta) = \frac{1}{B(\alpha,\beta)} x^{\alpha-1} (1-x)^{\beta-1}, \quad x \in [0,1]$$
- $x$:到核中心的归一化距离,x=0是中心,x=1是核的边缘;
- $\alpha、\beta$:两个形状参数,控制分布的曲线形态;
- $B(\alpha,\beta)$:Beta归一化函数,用来让分布的积分和为1。
为了让Beta核有类似高斯的钟形,同时保证3D视图之间的平滑一致性,论文做了极简的优化:
- 把$\alpha$固定为1,只保留$\beta$作为形状控制参数;
- 去掉了归一化项,避免额外的计算开销。
最终得到了Beta核函数: $$B(x;\beta) = (1-x)^\beta, \quad x \in [0,1]$$
这个公式的通俗解读:
- 完美的有界支撑:x只在[0,1]里有值,x>1时函数值直接为0,再也不需要硬编码截断,彻底消除了截断伪影;
- 极致的形状可控性:$\beta$的大小直接决定核的“尖/平”,$\beta$越大,核越尖;$\beta$越小,核越平。
2.1.2 关键优化:Beta核的重参数化,让训练更稳定
直接优化$\beta$会有两个问题:
- $\beta$必须大于0,模型优化时很容易跑出无效值;
- 初始值不好设,训练很容易不稳定。
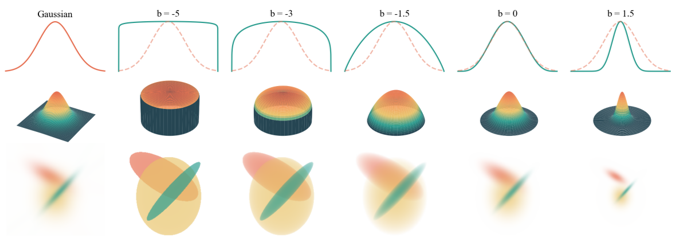
论文用指数激活给$\beta$做了重参数化,让模型优化一个无范围限制的参数$b$,再通过公式映射出$\beta$: $$\beta(b) = 4 \cdot e^b$$
- $b$:模型真正优化的参数,取值范围是$(-\infty, +\infty)$,没有任何限制;
- 常数4:当$b=0$时,$\beta=4$,此时Beta核的形状和高斯核几乎完全一致。
这个设计的妙处:
- 模型初始化时,Beta核和高斯核完全对齐,训练起点和3DGS一致,稳定性拉满;
- Beta核本质成了高斯核的超集——既能当高斯核用,还能变出更多高斯核做不到的形状。
2.1.3 形状参数$b$的神奇作用:一个参数搞定平坦表面和精细细节
$b$的取值直接决定了Beta核的形态,适配完全不同的场景,这也是DBS几何表达能力的核心:
- 当$b<0$时:$\beta<4$,核的形态非常平坦,边缘截断极其锐利。 适配场景:平坦的墙面、桌面,还有锐利的几何边缘(比如桌子的直角、建筑的轮廓),完美解决高斯核画平面对象会糊的问题。
- 当$b=0$时:$\beta=4$,核的形态和高斯核完全一致,完美兼容3DGS的所有效果。
- 当$b>0$时:$\beta>4$,核的形态非常尖锐,下降速度极快。 适配场景:高频细节纹理,比如布料的纹路、树叶的边缘、细小的物体,能比高斯核捕捉到更精细的细节。
2.1.4 3D椭球Beta基元:把Beta核用到3D场景里
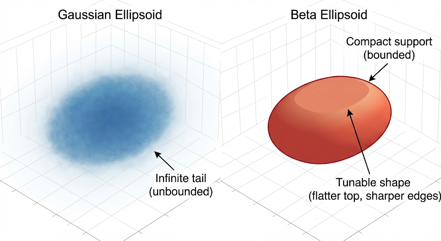
有了Beta核,论文定义了DBS里最基础的场景单元——3D椭球Beta基元,它的完整参数是: $$\mathcal{B} = {\mu, o, q, s, b, f}$$
每个参数的通俗解释,和3DGS做了对比:
| 参数 | 含义 | 和3DGS的关系 |
|---|---|---|
| $\mu$ | 3D空间中基元的中心坐标 | 和3DGS完全一致 |
| $o$ | 基元的不透明度 | 和3DGS完全一致 |
| $q$ | 四元数,定义基元的旋转角度 | 和3DGS完全一致 |
| $s$ | 三维缩放系数,定义椭球的大小/拉伸程度 | 和3DGS完全一致 |
| $b$ | Beta核的形状控制参数 | DBS独有,仅1个参数,开销可忽略 |
| $f$ | 球面Beta函数的系数(控制视点相关颜色) | DBS独有,替代3DGS的SH系数 |
划重点:相比3DGS的高斯椭球,DBS只多了1个$b$参数,几乎没有增加计算开销,却实现了几何表达能力的质的飞跃。
2.2 创新二:球面Beta(SB)——换掉球谐函数,精准拿捏镜面高光
解决了几何表示的问题,DBS的第二个核心创新,就是用球面Beta(SB) 替换了3DGS里的球谐函数SH,彻底解决了镜面高光画不出来的痛点。
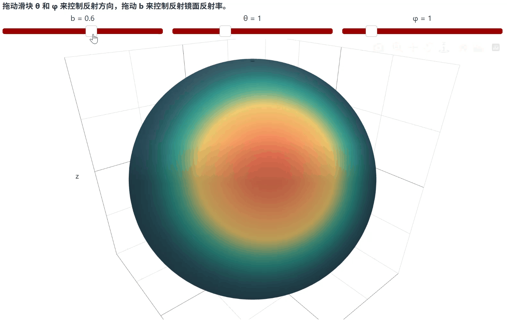
2.2.1 先搞懂:为什么球谐函数SH搞不定镜面高光?
3DGS里的“视点相关颜色”,通俗说就是:你站在不同角度看同一个物体,看到的颜色、反光是不一样的(比如镜子换个角度,高光就变了)。3DGS用低阶SH编码这个效果,但有两个无解的问题:
- 高阶SH参数量爆炸:SH的参数量随阶数呈平方增长,3阶SH就有16个参数,再高的话实时渲染就扛不住了,所以3DGS只能用低阶SH;
- 低阶SH只能表达平滑的颜色变化,比如漫反射的木头、墙面还行,但遇到金属、玻璃的锐利高光,直接就糊成一片,完全没有质感。
2.2.2 球面Beta的设计思路:抄作业经典Phong反射模型
论文的灵感来自计算机图形学里用了几十年的Phong反射模型——这个模型把物体的颜色拆成了三个物理上完全独立的部分:
- 环境光:场景里的基础光线,固定不变;
- 漫反射:物体本身的颜色,不管从哪个角度看,都基本一致;
- 镜面反射:物体表面的高光,只有特定角度能看到,角度越准,高光越亮。
球面Beta直接把这个物理规律搬了过来,把视点相关的颜色彻底解耦:
- 把环境光和漫反射合并成一个固定的基础颜色$c_0$,不管视角怎么变,这个颜色都不变;
- 用多个可学习的Beta核,直接建模镜面反射瓣,每个瓣对应一个方向的镜面反光,想让高光多锐利,就调对应的Beta核参数。
2.2.3 球面Beta的公式和通俗解读
球面Beta的最终公式是: $$c(V) = c_0 + \sum_{m \in M} \beta(1 - R_m \cdot V; b_m) c_m$$
我们把每个参数拆解得明明白白:
| 参数 | 通俗含义 | 核心作用 |
|---|---|---|
| $c(V)$ | 最终输出的RGB颜色 | V是当前相机的视线方向,不同角度对应不同的颜色 |
| $c_0$ | 基础漫反射颜色(RGB) | 固定不变,对应物体本身的颜色,仅3个参数 |
| $M$ | 高光瓣的数量 | 比如M=2,就是每个基元带2个高光瓣,数量可自定义,平衡效果和效率 |
| $R_m$ | 第m个高光瓣的反射方向(单位向量) | 模型自己学习,决定这个高光从哪个角度能看到 |
| $V$ | 相机的视线方向(单位向量) | $R_m \cdot V$是两个向量的点积,点积越大,视线和反射方向越重合,高光越亮 |
| $b_m$ | 第m个高光瓣的Beta核形状参数 | $b_m$越大,Beta核下降越快,高光越锐利;越小,高光越柔和 |
| $c_m$ | 第m个高光瓣的颜色(RGB) | 模型自己学习,决定高光的颜色/亮度 |
这个设计的碾压级优势:
- 物理上更合理:完全贴合现实世界的反光规律,比黑盒的SH函数可控性强太多,效果也更真实;
- 参数量极低,效率拉满:用2个高光瓣(sb=2)时,每个基元的颜色参数仅17个,和3阶SH的16个参数几乎一致,但表达能力天差地别,能画出超锐利的镜面高光,还不影响实时渲染;
- 完美解耦漫反射和镜面反射:漫反射和高光完全分开,训练后可以单独调整高光,不用改几何,也不用重新训练。
2.3 创新三:核无关的MCMC——通用的致密化策略,不再绑定高斯核
换掉了核函数和颜色编码,还剩最后一个问题:3DGS的致密化策略完全和高斯核绑定,Beta核用不了。DBS的第三个核心创新,就是提出了核无关的MCMC致密化策略,不管用什么溅射核,都能稳定生效。
2.3.1 先搞懂:致密化到底是干嘛的?
3DGS训练的时候,一开始场景里的基元数量是固定的。训练过程中会出现两个问题:
- 细节多的地方,基元数量不够,画面会糊;
- 没用的地方,基元太多,浪费算力,甚至出现重影。
致密化就是训练过程中,自动给细节多的地方“克隆/分裂”更多基元,给没用的基元“修剪”掉,让画面更清晰,同时不浪费算力。
3DGS-MCMC把这个过程改成了马尔可夫链蒙特卡洛(MCMC)过程:把基元的不透明度当成概率,不透明度极低的“死亡”基元会被删掉,然后在不透明度高的基元附近“重生”新的基元,同时调整新基元的参数,保证克隆/重生后,画面效果和原来完全一致。
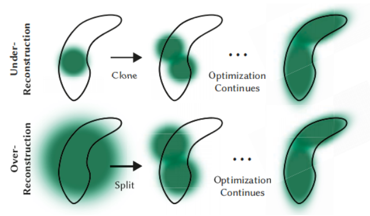
但它的致命问题是:参数调整的公式,完全是根据高斯核的数学特性推导出来的,换个核函数就不成立了。
2.3.2 DBS的核心突破:数学证明“只调不透明度,就能适配所有核”
论文用严谨的数学推导,证明了一个颠覆性的结论:只要基元的不透明度足够小,仅调整不透明度,就能保证克隆后的画面效果完全不变,和溅射核的类型没有任何关系。
我们用最通俗的方式,把这个证明过程讲明白:
- 步骤1:明确核心目标
一个基元,核函数是$f(x)$,不透明度是$o$,它在某个像素上的贡献(alpha值)是: $$\alpha = o \cdot f(x)$$ 现在要把这个基元克隆N个,每个新基元的不透明度是$o’$,我们的目标是:N个新基元叠加后的总贡献,和原来的完全一致,也就是$\alpha_{total}’ = \alpha$。
- 步骤2:透明度叠加的物理规则
根据计算机图形学里的alpha混合规则,N个不透明度为$\alpha’=o’ \cdot f(x)$的基元,叠加后的总不透明度是: $$\alpha_{total}’ = 1 - (1 - o’ \cdot f(x))^N$$
- 步骤3:求解新基元的不透明度$o’$
我们要求$\alpha_{total}’ = \alpha$,也就是: $$o \cdot f(x) = 1 - (1 - o’ \cdot f(x))^N$$ 暂时忽略核函数$f(x)$,方程简化为: $$o = 1 - (1 - o’)^N$$ 解这个方程,得到克隆后每个新基元的不透明度: $$o’ = 1 - \sqrt[N]{1 - o}$$
- 步骤4:泰勒展开证明:小不透明度下,和核函数完全无关
当基元的不透明度$o$很小的时候,我们可以用一阶泰勒展开对$\sqrt[N]{1-o}$做近似: $$(1-o)^{1/N} ≈ 1 - \frac{o}{N} + O(o^2)$$ 这里的$O(o^2)$是高阶无穷小,当$o$足够小时,这个项可以完全忽略不计。
把这个近似代入$o’$的公式,得到: $$o’ ≈ \frac{o}{N}$$
再把这个$o’$代回总不透明度的公式,做二次近似: $$\alpha_{total}’ = 1 - (1 - \frac{o}{N} \cdot f(x))^N ≈ 1 - (1 - o \cdot f(x)) = o \cdot f(x) = \alpha$$
最关键的结论来了:整个推导过程中,我们没有对核函数$f(x)$做任何限制!不管你是高斯核、Beta核,还是随便什么核函数,只要基元的不透明度$o$足够小,这个结论100%成立。
2.3.3 怎么保证“小不透明度”?配套的损失函数设计
为了让上面的结论完美生效,论文在损失函数里加了不透明度正则化项,强制让所有基元的不透明度都保持在很小的范围。
DBS的完整复合损失函数是: $$\mathcal{L} = \mathcal{L}{RGB} + \lambda{SSIM} \mathcal{L}_{DSSIM} + \lambda_o \mathcal{L}_o + \lambda_s \mathcal{L}_s$$
每个部分的作用:
- $\mathcal{L}_{RGB}$:L1像素损失,保证渲染图和真实图的像素一致,画得像;
- $\lambda_{SSIM} \mathcal{L}{DSSIM}$:结构损失,权重$\lambda{SSIM}=0.2$,保证画面的边缘、结构不糊;
- $\lambda_o \mathcal{L}_o$:不透明度正则化项,权重$\lambda_o=0.01$,惩罚高不透明度的基元,让基元的平均不透明度保持在0.1左右,完美满足“小不透明度”假设;
- $\lambda_s \mathcal{L}_s$:尺寸正则化项,惩罚过大的基元,避免巨型基元覆盖画面,保证细节。
2.3.4 这个创新的行业级意义
这个核无关的MCMC策略,不仅解决了DBS自身的优化问题,更给整个3DGS领域打开了新的大门: 以后大家研究新的溅射核函数,再也不用头疼配套的致密化/优化策略了,直接用这个通用方法就行,极大降低了3DGS核函数创新的门槛。
三、实验结果:DBS到底有多强?
论文在Mip-NeRF 360、Tanks&Temples、Deep Blending等行业通用数据集上做了全面测试,结果可以用“全面碾压”来形容。
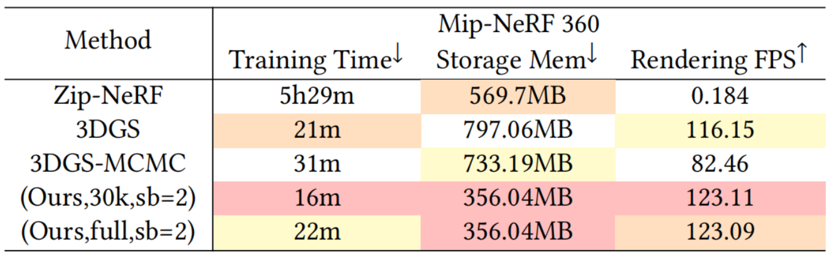
3.1 核心性能:画质、速度、内存全面超越
| 指标 | DBS的表现 | 对比基准 |
|---|---|---|
| 渲染画质 | 所有主流数据集上,PSNR/SSIM/LPIPS均达到SOTA;强镜面反射场景,PSNR比3DGS-MCMC、Zip-NeRF高1dB以上 | 超过3DGS、3DGS-MCMC,甚至超越了顶级NeRF方法Zip-NeRF |
| 参数量 | 仅用3DGS-MCMC 45%的参数,就能达到更好的画质;剪枝后的DBS-490K仅49万个基元,压缩后仅10MB,就达到原版3DGS的画质 | 原版3DGS需要335万个基元,占用几百MB空间 |
| 渲染速度 | 比3DGS-MCMC快1.5倍,达到123FPS的实时渲染 | 原版3DGS 116FPS,Zip-NeRF仅0.184FPS |
| 训练速度 | 完整训练仅需22分钟 | 3DGS-MCMC需31分钟,Zip-NeRF需5小时29分钟 |
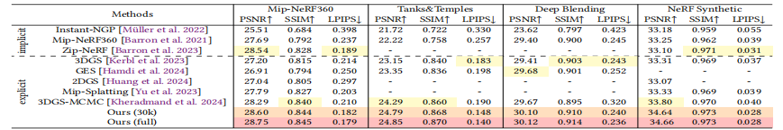
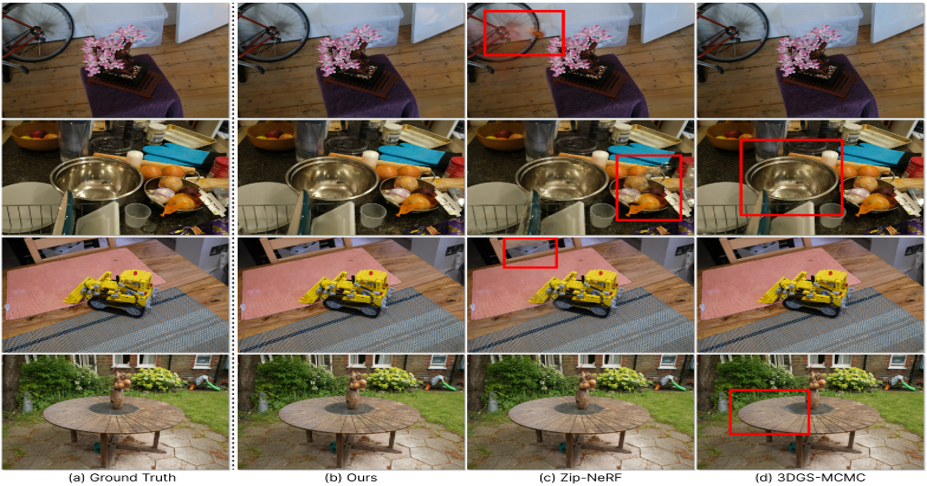
3.2 消融实验:每个创新点都实打实起作用
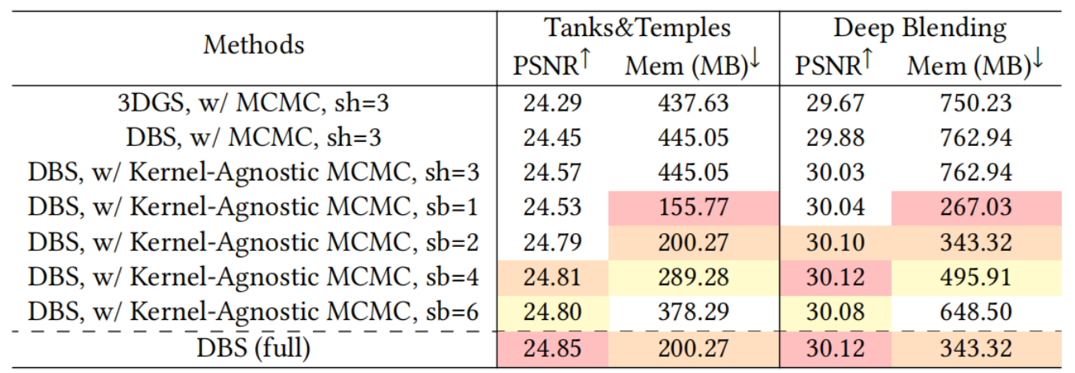 论文把三个创新点拆开测试,验证了每个部分的贡献:
- 仅用Beta核替换高斯核,其他不变:PSNR就有明显提升,证明Beta核的几何表达能力远超高斯核;
- 加上核无关的MCMC:PSNR进一步提升,证明这个优化策略能让Beta核更好地收敛;
- 把SH换成球面Beta(SB):PSNR再次大幅提升,尤其是高光场景,证明球面Beta完美解决了视点相关颜色的问题;
- 高光瓣数量sb=2时,效果和效率达到最佳平衡,sb超过4后,效果提升微乎其微。
3.3 彩蛋能力:训练后的几何+光照分解
详见:https://rongliu-leo.github.io/beta-splatting/。
因为DBS天生解耦了漫反射和镜面反射,再加上可变形的Beta核,它实现了3DGS完全做不到的能力:训练后对场景的几何和光照进行分解。
比如在经典的自行车场景里,DBS能把黑色长椅的几何,和上面的白色高光完美分离开。这个能力在3D场景编辑、后期渲染里价值巨大:你可以单独调整场景里的高光、反光,不用修改几何,也不用重新训练模型。
四、论文结论与行业意义
4.1 论文核心结论
DBS通过三个环环相扣的核心创新,彻底解决了3DGS的原生短板:
- 可变形Beta核:解决了高斯核无界长尾、天生平滑的问题,几何细节更精准,彻底消除截断伪影;
- 球面Beta:解决了低阶SH无法建模锐利镜面高光的问题,视点相关颜色表达能力拉满,同时保持极低的参数量;
- 核无关的MCMC:解决了致密化策略和高斯核绑定的问题,为任意溅射核提供了通用、稳定的优化方案。
最终,DBS实现了画质更好、参数更少、渲染更快、训练更快的全面突破,把实时辐射场渲染的水平推到了新的高度。
4.2 行业意义
- 工业级落地价值:DBS几乎可以直接替换原版3DGS,用在游戏、数字孪生、虚拟人、AR/VR等所有需要实时3D渲染的场景,效果和效率都有显著提升;
- 领域级创新价值:核无关的MCMC策略,为整个3DGS领域的核函数创新铺平了道路,大幅降低了后续研究的门槛;
- 内容创作价值:训练后的几何+光照分解能力,给3D内容创作、后期编辑提供了极大的便利,彻底改变了3DGS场景“一次训练、无法修改”的痛点。
附录:论文关键补充细节(详见论文附录)
附录A:2D核函数的通用有效条件
论文通过逆阿贝尔变换证明,只要一个2D溅射核满足以下5个条件,就一定能找到对应的、多视图一致的3D核函数:
- 定义在$r \in [0,1]$,值域在$[0,1]$;
- 边界条件:中心不透明度为1($\lim_{r \to 0} K(r)=1$),边界透明度为0($\lim_{r \to 1} K(r)=0$);
- 在$(0,1)$上连续可微;
- 核及其导数在$(0,1)$上绝对可积;
- 逆阿贝尔变换能生成有效的3D核。
附录B:论文核心超参数
| 超参数 | 取值 | 作用 |
|---|---|---|
| 位置初始学习率 | 0.00016 | 基元中心坐标的优化学习率,训练中衰减到0.0000016 |
| 基础颜色/球面Beta学习率 | 0.0025 | 颜色相关参数的优化学习率 |
| 不透明度学习率 | 0.05 | 不透明度参数的优化学习率 |
| Beta核形状参数$b$学习率 | 0.001 | 核形状参数的优化学习率 |
| DSSIM损失权重$\lambda_{SSIM}$ | 0.2 | 结构损失的权重 |
| 不透明度正则化权重$\lambda_o$ | 0.01 | 小不透明度约束的权重 |
| 致密化间隔 | 每100次迭代 | 训练中执行致密化的频率 |
附录C:压缩性能
DBS训练后,通过统一的PNG压缩,能把模型大小再压缩5-6倍,且PSNR仅下降0.15dB,几乎没有画质损失。剪枝后的DBS-490K,经过简单压缩后仅10MB,就能达到原版3DGS的画质,极其适合移动端、AR/VR等轻量化场景。