前言
本指南基于 2025-2026 年腾讯、阿里、字节、华为等大厂 168 道真实 Go 后端面试真题整理,覆盖从基础语法到架构设计的全维度考点,帮助你系统性准备 Go 后端岗位面试。
一、面试考点整体分布
根据真实面试题统计,各模块考察占比如下:
| 模块 | 占比 | 核心考察方向 |
|---|---|---|
| 并发与并行控制 | 24.1% | 协程管理、锁机制、资源竞争 |
| 性能优化与调试 | 18.9% | 内存管理、查询优化、日志监控 |
| 系统设计 | 17.5% | 高可用架构、业务系统设计 |
| 数据结构与 Go 特性 | 15.8% | 切片、map、标准库特性 |
| 数据库与缓存 | 12.7% | Redis、MySQL、缓存设计 |
| 网络与安全 | 7.0% | 协议、攻防、TCP 优化 |
| 工程实践 | 4.0% | CI/CD、依赖管理、监控 |
核心结论:前三个模块合计占比 60.5%,是决定面试成败的关键。
二、基础语法核心考点
1. new 和 make 的区别
问题: Go 中new和make有什么区别?
解析:
-
new(T):分配零值内存,返回*T指针,可用于所有类型,仅分配内存不初始化。 -
make(T, args):仅用于slice、map、channel三种引用类型,返回初始化后的实例本身,而非指针。
示例:
|
|
2. defer 关键字
问题: defer 的执行顺序是什么?对返回值有什么影响? 解析:
-
执行顺序:多个 defer 按后进先出(LIFO) 栈结构执行,最后声明的最先执行。
-
参数求值:defer 语句的参数在声明时立即求值,而非执行时。
-
对返回值的影响:
-
命名返回值:defer 可以修改返回值,因为返回值是函数作用域的变量。
-
普通返回值:defer 修改的是局部变量,不影响返回值(return 会创建临时变量保存结果)。
-
示例:
|
|
3. panic 和 recover
问题: panic 的执行流程是什么?recover 可以在什么地方使用? 解析:
-
panic 触发后,会立即停止当前函数的执行,然后逆序执行当前已入栈的 defer 函数,直到所有 defer 执行完毕,最后程序崩溃。
-
如果 defer 中调用了 recover,会捕获 panic,程序恢复正常执行。
-
recover 必须在 defer 的函数中调用,否则无效,无法捕获其他 goroutine 的 panic。
- 补充:recover 是 Go 内置函数,用于捕获 panic,返回 panic 的值,如果没有 panic 则返回 nil。可以用来实现错误处理和资源清理,避免程序崩溃。
|
|
4. 空结构体 struct{}
问题: 空结构体占用内存吗?有什么用途? 解析:
-
空结构体不占用任何内存空间(
unsafe.Sizeof(struct{}{}) = 0)。 -
常见用途:
-
实现 Set 集合:用 map 的 key 存值,value 用空结构体节省内存。
-
通道信号:仅需要通知,不需要传递数据时,发送空结构体。
-
仅包含方法的结构体:不需要存储数据时。
-
5. rune 类型
问题: rune 和 byte 有什么区别? 解析:
-
byte:等价于 uint8,占 1 个字节,代表 ASCII 码的一个字符。
-
rune:等价于 int32,占 4 个字节,代表一个 UTF-8 字符,用于处理中文、日文等多字节字符。但在下面的例子中为什么中文占3个字节呢?因为 UTF-8 编码中,中文字符通常占用 3 个字节,而 rune 是一个 Unicode 码点,占用 4 个字节的内存空间。
示例:
|
|
6. 结构体 Tag
问题: Go 的结构体 Tag 有什么用? 解析: Tag 是结构体字段的元数据,用于反射解析,常见用途:
-
json 序列化 / 反序列化:指定字段名、忽略空值等。
-
数据库映射:ORM 框架中指定数据库字段名。
-
参数绑定:Web 框架中指定表单参数、校验规则。
有关JSON参数绑定的详情可以参考Go语言中的JSON参数绑定。
示例:
|
|
7. init 函数
问题: init 函数什么时候执行?执行顺序是什么? 解析:
-
init 函数在 main 函数之前执行,用于包的初始化。
-
执行顺序:
import → const → var → init() → main() -
同一个包、同一个文件可以有多个 init 函数,执行顺序由编译器决定,不保证顺序。
三、核心数据结构底层原理
1. 切片 Slice
问题 1:切片的底层结构是什么?数组和切片的区别?
解析: 切片的底层是一个结构体,包含三个字段:
|
|
-
数组:固定长度,长度是类型的一部分(如 [5]int),值传递。
-
切片:动态长度,引用类型,对底层数组的封装。
问题 2:切片的扩容机制是什么?
解析: 当 append 元素时,如果容量不足,会触发扩容:
-
如果原容量小于 1024,新容量扩容为原来的 2 倍。
-
如果原容量大于等于 1024,新容量扩容为原来的 1.25 倍。
-
扩容时会分配新的底层数组,将原数组的元素拷贝过去,原数组如果没有引用会被 GC 回收。
注意:切片扩容会导致底层数组变更,所以如果要修改原切片的元素,需要注意引用关系。
问题 3:切片作为函数参数传递,会修改原切片吗?
解析: 切片本身是值传递,但是切片的底层数组是引用的:
-
如果修改元素,会修改原切片的元素,因为底层数组是同一个。
-
如果 append 导致扩容,新切片会指向新的底层数组,不会影响原切片。
2. 字典 Map
问题 1:Map 的底层实现原理是什么?
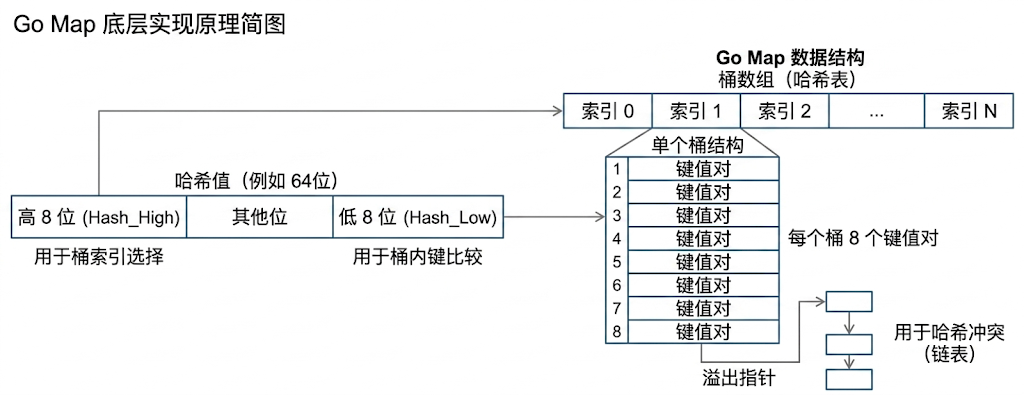
解析: Go 的 map 是哈希表实现,底层是数组 + 链表 + 溢出桶:
-
核心结构是
bucket数组,每个 bucket 存放 8 个键值对。 -
哈希冲突时,新的键值对会放到溢出桶中。
-
哈希值的高 8 位用于找 bucket,低 8 位用于在 bucket 内比较 key。
举个例子:假设有一个 key 的哈希值是0x12345678,高 8 位0x12用于计算 bucket 索引,低 8 位0x78用于在 bucket 内比较 key 是否匹配。如果 bucket 已经有 8 个元素了,就会把新的键值对放到溢出桶中,溢出桶是一个链表结构,继续存储更多的键值对。否则,如果 bucket 内有空位,就直接放在 bucket 内。
溢出桶的存在是为了处理哈希冲突,避免性能下降。溢出桶中的元素数量过多时,会触发扩容,增加 bucket 数量,减少哈希冲突,提高性能。
问题 2:Map 的扩容机制是什么?
解析: 当 map 的负载因子(元素个数 /bucket 数量)超过 6.5 时,会触发扩容:
-
翻倍扩容:创建新的 bucket 数组,长度是原来的 2 倍。
-
增量扩容:不会一次性迁移所有数据,而是每次读写时迁移少量 bucket,避免阻塞。
问题 3:Map 是并发安全的吗?
解析:
原生 map 不是并发安全的,并发读写会 panic:concurrent map read and map write。
-
解决方案:
-
加互斥锁
sync.Mutex或读写锁sync.RWMutex。 -
使用
sync.Map,适用于读多写少的场景。
-
问题 4:Map 的遍历是有序的吗?
解析: 不是,Go 为了防止开发者依赖遍历顺序,故意在每次遍历时随机起始位置,所以不能依赖 map 的遍历顺序。如果需要有序遍历,需要把 key 取出来排序,再遍历。
3. 字符串 String
问题: 如何高效拼接字符串?
解析:
常见的拼接方式性能对比:
strings.Join ≈ strings.Builder > bytes.Buffer > "+" > fmt.Sprintf
-
+:每次拼接都会创建新的字符串,性能差。 -
strings.Builder:底层是字节切片,可提前预分配容量,避免多次扩容,性能最高。
示例:
|
|
四、并发编程与调度模型
1. Goroutine 与线程
问题: Goroutine 和 OS 线程(操作系统线程)有什么区别?为什么 Go 能支持百万级 Goroutine?
解析:
| 维度 | OS 线程 | Goroutine |
|---|---|---|
| 栈大小 | 默认 MB 级,固定 | 初始 2KB,动态伸缩 |
| 调度 | 内核态调度,切换成本高 | 用户态调度,Runtime 调度,切换成本低 |
| 调度模型 | 1:1 映射(线程与 M 一对一) | M:N 映射,多个 G 映射到少量 M(内核线程) |
| 上下文切换 | 需要陷入内核 | 仅用户态切换,无需内核参与 |
- 正是因为 Goroutine 轻量,初始栈小,调度成本低,所以 Go 可以轻松支持百万级 Goroutine 同时运行。
2. GMP 调度模型
问题: 什么是 GMP 模型?P 的作用是什么?
解析: GMP 是 Go 的调度模型,三个核心组件:
-
G(Goroutine):协程实例,保存协程的栈、程序计数器等信息。
-
M(Machine):内核线程,真正执行代码的实体。
-
P(Processor):处理器,代表运行 G 的上下文,维护本地可运行 G 的队列。
P 的作用:
-
实现 M:N 调度,隔离调度上下文,避免全局锁竞争。
-
实现工作窃取(Work Stealing):当 P 的本地队列为空时,从其他 P 的队列偷取 G,提高 CPU 利用率。
-
如果去掉 P,就会退化成 1:1 调度,全局锁竞争会非常严重,性能大幅下降。
3. Channel
问题 1:Channel 的底层实现是什么?
解析: Channel 的底层是一个环形队列,维护了发送者和接收者的等待队列:
-
有缓冲 Channel:带缓冲区的环形队列,当缓冲区满时发送者阻塞,空时接收者阻塞。
-
无缓冲 Channel:没有缓冲区,发送和接收必须同时准备好,否则阻塞,用于同步。
问题 2:不同状态的 Channel 操作会发生什么?
| 操作 | nil Channel | 未关闭非空 Channel | 未关闭空 Channel | 已关闭非空 Channel | 已关闭空 Channel |
|---|---|---|---|---|---|
| 读 | 永久阻塞 | 正常读数据 | 阻塞 | 正常读数据 | 读到零值,ok=false |
| 写 | 永久阻塞 | 正常写数据(满时阻塞) | 正常写数据 | panic | panic |
| 关闭 | panic | 正常关闭 | 正常关闭 | panic | panic |
问题 3:什么情况下会导致 Goroutine 泄漏?
解析: Goroutine 泄漏是指 Goroutine 永久阻塞,无法退出,占用内存:
-
Channel 发送 / 接收永久阻塞:比如无缓冲 Channel,没有接收者,发送者永久阻塞。
-
锁竞争导致永久阻塞。
-
循环中没有退出条件。
解决方案:
-
使用 Context 控制 Goroutine 的生命周期,超时取消。
-
带缓冲的 Channel,避免发送者阻塞。
4. Select
问题: Select 的执行机制是什么?多个 Case 同时就绪时怎么处理?
解析:
-
Select 会同时监听所有 Case 的 Channel 操作,哪个 Case 就绪就执行哪个。
-
如果多个 Case 同时就绪,Select 会伪随机选择一个执行,避免饥饿。为什么是伪随机?因为 Go 的 runtime 会在每次 Select 时随机打乱 Case 的顺序,保证公平性。
-
如果所有 Case 都没就绪,会执行 Default 分支(如果有),否则阻塞。
5. Sync 包工具
问题 1:Mutex 的模式是什么?
解析: Go 的 Mutex 有两种模式:
-
正常模式:锁被释放后,等待的 Goroutine 按 FIFO 顺序获取锁,性能高。
-
饥饿模式:当有 Goroutine 等待超过 1ms 时,会进入饥饿模式,锁直接移交等待的 Goroutine,避免长等待。
问题 2:sync.Once 的作用和原理?
解析: sync.Once 用于保证函数只执行一次,常用于单例初始化。
- 底层用原子操作
uint32标记是否执行过,搭配 Mutex 保证并发安全。
问题 3:WaitGroup 的原理?
解析: WaitGroup 用于等待一组 Goroutine 完成:
-
Add (n):增加计数。
-
Done ():计数减 1。
-
Wait ():阻塞直到计数为 0。
-
底层用信号量实现。
问题 4:sync.Map 的适用场景?
解析: sync.Map 是并发安全的 Map,适用于:
-
读多写少的场景。
-
key 一旦写入很少修改的场景。
-
底层用 read map 和 dirty map,读操作不加锁,写操作时合并数据,性能比加锁的原生 map 好。
6. Context
问题: Context 的作用是什么?底层原理?
解析: Context 用于在 Goroutine 之间传递取消信号、超时时间、请求元数据:
-
核心方法:
Done()返回取消通道,Err()返回错误,Value()获取元数据。 -
实现了父子取消:父 Context 取消时,所有子 Context 都会取消。
-
常见用法:请求超时控制、Goroutine 退出控制、链路追踪传递 traceID。
五、内存管理与垃圾回收
1. 内存逃逸
问题: 什么是内存逃逸?什么情况下会发生?
解析: Go 的编译器会决定变量分配在栈上还是堆上,如果变量逃逸到堆上,就是内存逃逸。
-
栈上的变量函数返回后自动回收,不需要 GC。
-
堆上的变量需要 GC 回收,会增加 GC 压力。
常见逃逸场景:
-
变量太大,栈放不下。
-
变量的类型不确定,比如接口类型。
-
闭包引用变量(闭包就是一个函数值,它可以捕获并访问其外部作用域中的变量。当闭包引用了外部变量时,这些变量就会逃逸到堆上,因为闭包可能在函数返回后仍然存在)。例如:
|
|
- 变量被其他 Goroutine 引用。
可以用go build -gcflags="-m"查看逃逸分析结果。
2. 内存泄漏
问题: Go 有 GC,为什么还会内存泄漏?常见场景?
解析: GC 只会回收没有引用的内存,如果变量一直被引用,就不会被回收,导致内存泄漏。
常见场景:
-
Goroutine 泄漏:Goroutine 永久阻塞,一直占用栈内存。
-
全局 Map/Slice 一直增长,不清理过期数据。
-
没有关闭的资源,比如文件句柄、连接。
-
错误使用 sync.Pool,没有重置对象。
3. 垃圾回收 GC
问题 1:Go 的 GC 用的什么算法?三色标记法是什么?
解析: Go 的 GC 是并发三色标记清除算法:
-
白色:未被访问过的对象。
-
灰色:被访问过,但是它的引用对象还没处理。
-
黑色:被访问过,所有引用对象也处理过。
GC 流程:
-
初始所有对象都是白色。
-
从根对象出发,把根对象标记为灰色,加入队列。
-
取出灰色对象,把它的引用对象标记为灰色,自己标记为黑色。
-
直到没有灰色对象,剩下的白色对象(也是不可达的对象)就是垃圾,回收。
问题 2:什么是写屏障?混合写屏障?
解析: 并发 GC 时,用户程序可能并发修改对象引用,导致标记错误,所以需要写屏障:
-
写屏障是在修改引用时,记录操作,保证标记的正确性。
-
Go 1.8 之后用混合写屏障,取代了之前的插入写屏障和删除写屏障,大幅降低了 STW 的时间,现在 Go 的 STW 通常在微秒级。
问题 3:GC 的触发时机是什么?
解析:
-
内存分配达到阈值:当堆内存增长到上次 GC 后的 2 倍时触发。
-
手动触发:调用
runtime.GC()。 -
定时触发:每 2 分钟强制触发一次 GC,防止长时间不分配内存导致垃圾无法回收。
六、接口、反射与泛型
1. 接口 Interface
问题 1:接口的底层结构是什么?
解析: Go 的接口是二元组结构:
-
iface:有方法的接口,包含tab(类型信息、方法表)和data(数据指针)。 -
eface:空接口interface{},只有类型和数据指针。
问题 2:为什么 nil 接口不等于 nil?
解析:
接口的 nil 是指type和data都是 nil。如果把一个 nil 的具体类型指针赋值给接口,接口的type是具体类型,data是 nil,所以接口整体不是 nil。
示例:
|
|
2. 反射
问题: 反射的作用是什么?有什么缺点?
解析: 反射可以在运行时获取变量的类型和值,动态调用方法,常用于序列化、ORM 等框架。
- 缺点:性能差,破坏类型安全,代码难维护。
3. 泛型
问题 1:Go 的泛型是怎么实现的?
解析: Go 的泛型用编译期单态化实现:
-
编译器会为每个具体的类型生成一份专用的代码。
-
运行时没有额外开销,性能和非泛型代码一致。
-
缺点是会增大二进制文件的体积。
问题 2:any 和 interface {} 有什么区别?
解析: 没有本质区别,any 是 interface {} 的别名,只是为了泛型的可读性引入的。
问题 3:泛型的约束是什么?
解析: 约束用于限制类型参数的范围,比如:
|
|
七、Web 开发与 ORM 框架
1. Gin 框架
问题 1:Gin 的中间件怎么实现的?
解析:
Gin 的中间件是洋葱模型,中间件是HandlerFunc类型,通过Next()方法调用下一个处理函数:
|
|
问题 2:Gin 的路由原理是什么?
解析: Gin 用的是前缀树(Trie 树)实现路由,比正则匹配性能高,支持动态路由参数。
2. GORM ORM
问题 1:GORM 的 N+1 问题怎么解决?
解析: N+1 问题是指查询主表数据后,循环查询每个关联的从表数据,导致 N+1 次查询。
- 解决方案:用预加载
Preload,一次查询把关联数据查出来:
|
|
问题 2:GORM 怎么实现事务?
解析:
|
|
八、微服务与分布式架构
1. gRPC
问题 1:gRPC 和 REST 的区别是什么?
解析:
| 维度 | REST | gRPC |
|---|---|---|
| 协议 | HTTP/1.1,文本 / JSON | HTTP/2,二进制 / Protobuf |
| 性能 | 序列化慢,头信息大,不支持多路复用 | 序列化快,体积小,支持多路复用、流处理 |
| 类型安全 | 无 | 有,Protobuf 强类型 |
| 适用场景 | 对外 API,浏览器兼容 | 微服务内部通信 |
问题 2:gRPC 的拦截器是什么?
解析: 拦截器类似中间件,用于在请求处理前后做统一处理,比如认证、日志、链路追踪。
2. 微服务核心组件
问题 1:服务发现是什么?
解析: 服务发现用于解决服务地址动态变化的问题,常用的有 Consul、Etcd、Nacos,服务启动时注册自己的地址,消费者从注册中心获取服务地址。
问题 2:熔断降级是什么?
解析:
-
熔断:当某个服务调用失败率过高,暂时停止调用,避免雪崩,等服务恢复后再恢复调用。
-
降级:当系统压力大时,暂时关闭非核心服务,保证核心服务可用。
问题 3:链路追踪是什么?
解析: 链路追踪用于追踪分布式请求的整个调用链,排查性能瓶颈,常用的有 OpenTelemetry、Jaeger。
九、工程化与性能调优
1. 依赖管理 Go Mod
问题: Go Mod 的作用是什么?
解析: Go Mod 是 Go 的依赖管理工具,解决了 GOPATH 的问题,支持版本管理,每个项目可以有自己的依赖版本,不会冲突。
2. 性能排查工具 pprof
问题: 怎么用 pprof 排查性能问题?
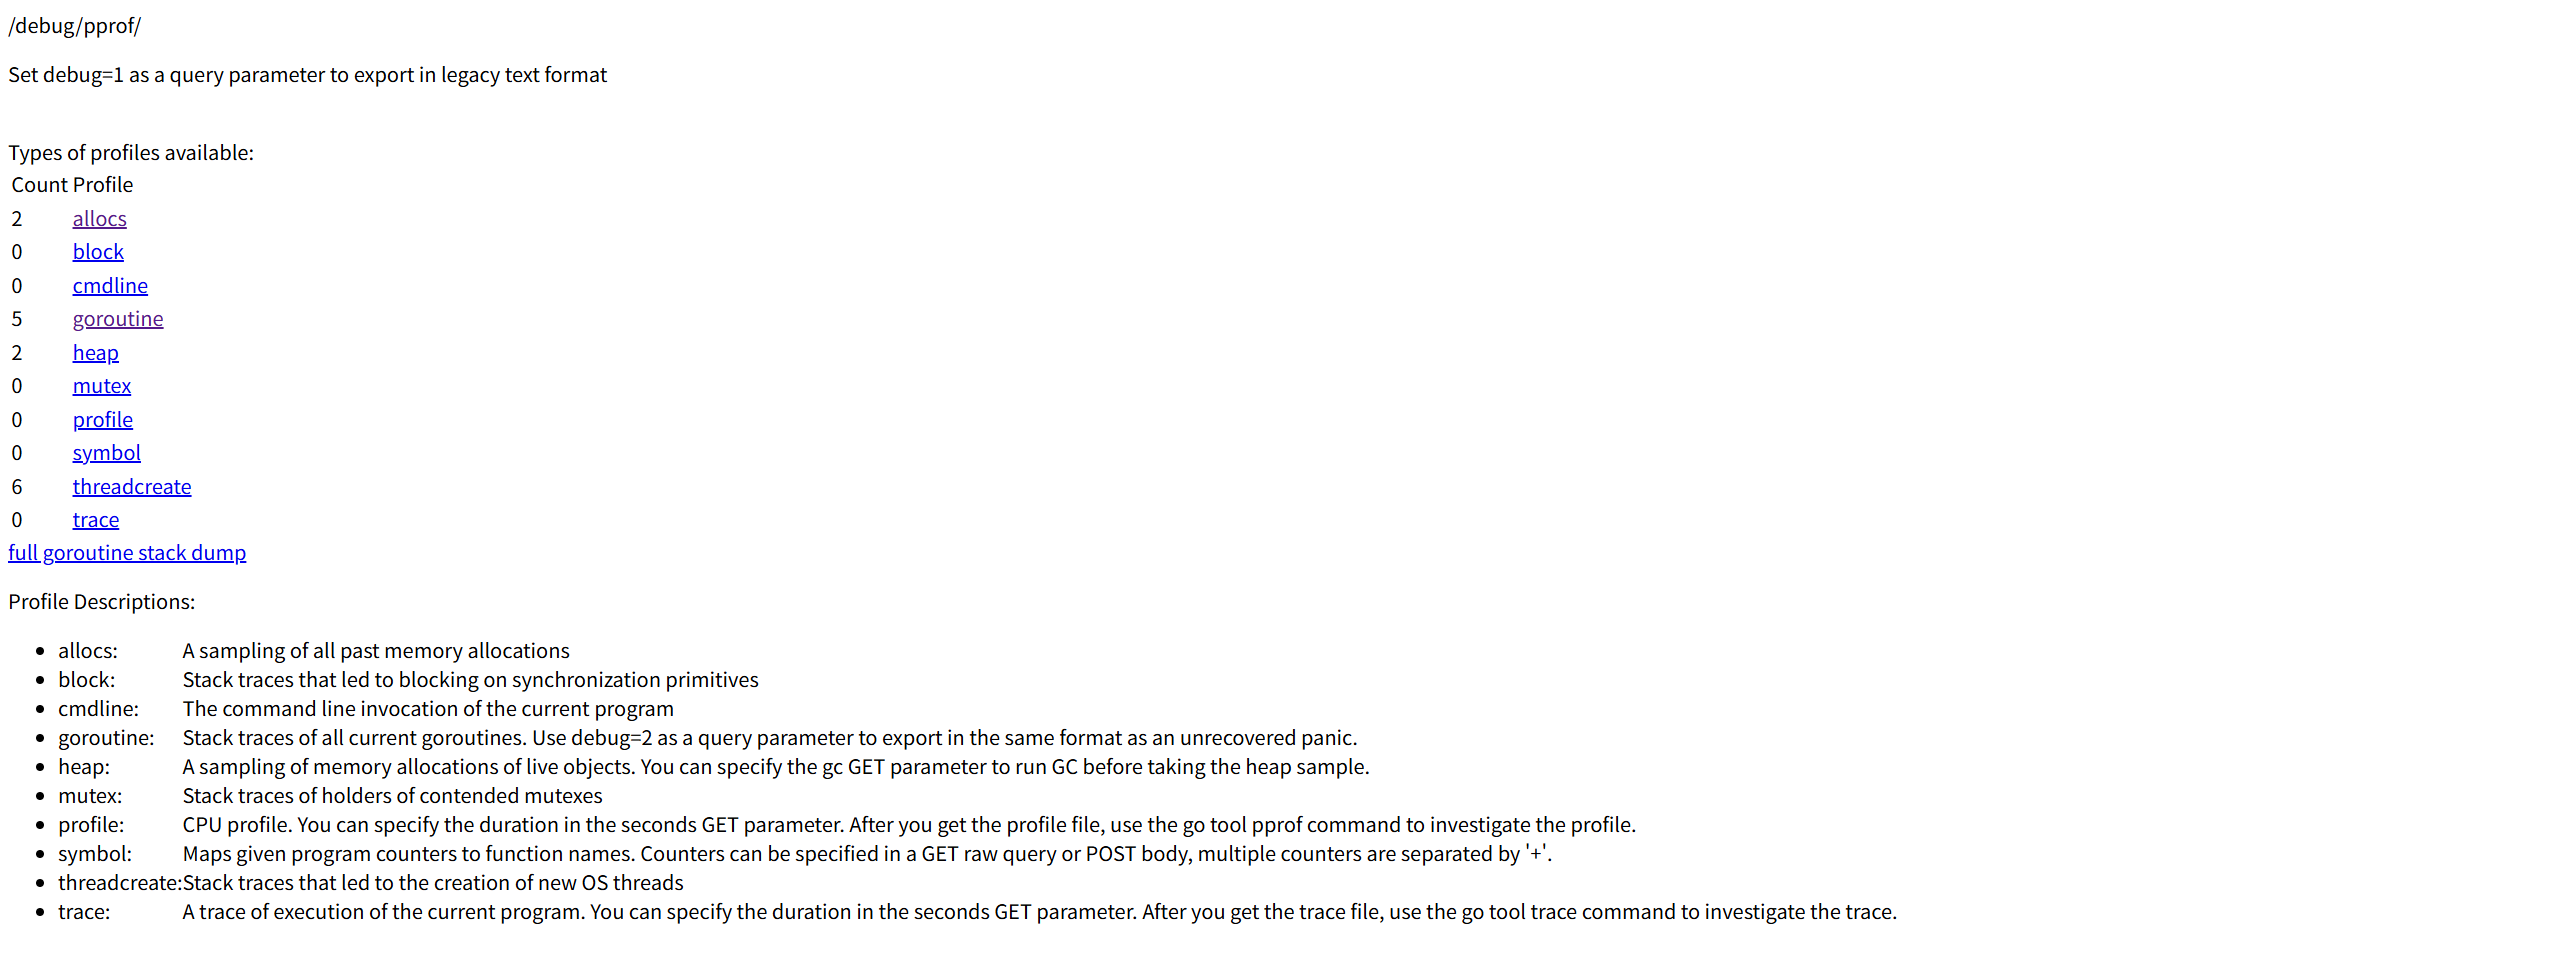
解析: pprof 是 Go 的性能排查工具,可以分析 CPU、内存、Goroutine、锁等问题:
-
排查 CPU 过高:查看哪些函数占用 CPU 最多。
-
排查内存泄漏:查看内存分配,有没有一直增长的对象。
-
排查 Goroutine 泄漏:查看 Goroutine 的数量,有没有阻塞的 Goroutine。
-
排查锁竞争:查看锁的等待时间。
示例:
|
|
上面的代码会启动一个 pprof 的 HTTP 服务器,可以通过http://localhost:6060/debug/pprof/访问性能数据。
3. 单元测试
问题: Go 的单元测试怎么写?
解析:
Go 的测试文件以_test.go结尾,测试函数以Test开头,参数是*testing.T:
|
|
十、业务实战与系统设计
1. 缓存常见问题
问题 1:缓存穿透、击穿、雪崩的区别和解决方案?
解析:
-
缓存穿透:查询不存在的数据,请求直接打到数据库。 解决方案:布隆过滤器,空值缓存。
-
缓存击穿:热点 key 过期,大量请求打到数据库。 解决方案:互斥锁,热点 key 永不过期。
-
缓存雪崩:大量 key 同时过期,或者 Redis 宕机,大量请求打到数据库。 解决方案:过期时间加随机值,Redis 集群,熔断降级。
2. 高并发系统设计
问题: 秒杀系统的核心设计点是什么? 解析:
-
限流:限制请求量,避免超过系统承载能力。
-
削峰:用消息队列把请求削峰,异步处理。
-
缓存:用 Redis 预存库存,避免直接查数据库。
-
原子操作:用 Redis 的原子操作扣减库存,避免超卖。
-
降级:秒杀时关闭非核心服务。
十一、常见易错点与踩坑指南
-
闭包陷阱:循环中的闭包捕获的是变量的地址,不是值,导致所有闭包都用了最后一个值。
1 2 3 4 5 6 7 8// 错误写法 for i := 0; i < 10; i++ { go func() { fmt.Println(i) }() // 全部输出10 } // 正确写法 for i := 0; i < 10; i++ { go func(i int) { fmt.Println(i) }(i) // 传值 } -
Range 变量复用:Go1.22 之前,for range 的迭代变量是复用的,地址不变,取地址会导致都指向最后一个元素。
-
Map 并发写:原生 map 并发写会 panic,一定要加锁或者用 sync.Map。
-
Goroutine 泄漏:启动 Goroutine 一定要考虑退出条件,用 Context 控制生命周期。
-
Defer 参数求值:defer 的参数在声明时就求值了,不是执行时,所以如果要延迟求值,要用闭包。
十二、高频代码手写题
- 用 Channel 实现三个 Goroutine 交替打印 ABC
|
|
- 实现一个限流器(令牌桶 / 漏桶)
|
|
- 实现生产者消费者模型
|
|
- 用 WaitGroup 实现并发控制
|
|
- 实现一个并发安全的 LRU 缓存
|
|
- 手写一个简单的 Gin 中间件
|
|
面试准备建议
-
优先掌握并发、性能优化、系统设计这三个核心模块,占比超过 60%。
-
结合自己的项目,准备量化的优化结果,比如 QPS 提升了多少,延迟降低了多少。
-
熟悉 pprof 的使用,能讲清楚怎么排查线上的性能问题。
-
准备 1-2 个系统设计的案例,比如秒杀、短链服务,覆盖限流、缓存、一致性这些点。