本文档整理了后端开发面试中关于 Redis 最常被问到的高频面试题和深度解析,重点聚焦于底层原理、高并发场景下的缓存设计及高可用架构。
一、 核心基础与数据结构
1. Redis 为什么这么快?
官方测试 Redis 的 QPS 可以达到 10万+,主要原因有:
- 完全基于内存:绝大部分请求是纯内存操作,速度极快。
- 高效的数据结构:Redis 专门设计了如 SDS(简单动态字符串)、跳表(SkipList)、压缩列表(ZipList)等高效的数据结构。
- 单线程模型:Redis 的网络 IO 和键值对读写是由一个线程来完成的,避免了不必要的上下文切换和竞争条件,不存在加锁解锁操作造成的性能损耗。(注:Redis 6.0 引入了多线程,但也只是用于网络 I/O 阶段,命令执行依然是单线程)。
- I/O 多路复用模型:采用 epoll 作为 I/O 多路复用技术的实现,非阻塞 I/O,可以同时监听多个 Socket。
2. Redis 的五种基本数据类型及其底层数据结构?
面试不仅会问应用场景,一定会深挖底层结构:
| 数据类型 | 应用场景 | 底层数据结构(Redis 3.2+ / 7.0+ 有所演进) |
|---|---|---|
| String | 缓存、计数器、分布式锁、Session(会话) | SDS (简单动态字符串)。比 C 字符串更安全、获取长度 O(1)、防止缓冲区溢出。 |
| List | 消息队列、文章列表、粉丝列表 | QuickList (快速列表,双向链表 + 压缩列表的组合)。 |
| Hash | 存储对象、购物车 | ZipList (压缩列表,数据少时) / HashTable (哈希表/字典,数据多时)。注:Redis 7.0 后 ZipList 替换为 ListPack。 |
| Set | 共同好友、点赞、抽奖 | IntSet (整数集合,元素全为整数且较少时) / HashTable (字典)。 |
| ZSet (Sorted Set) | 排行榜、延时队列 | ZipList (数据少时) / SkipList + HashTable (跳跃表+字典)。跳表保证范围查询效率 O(logN),字典保证单点查询 O(1)。 |
3. ZSet 为什么使用跳表(SkipList)而不是红黑树或 B+ 树?
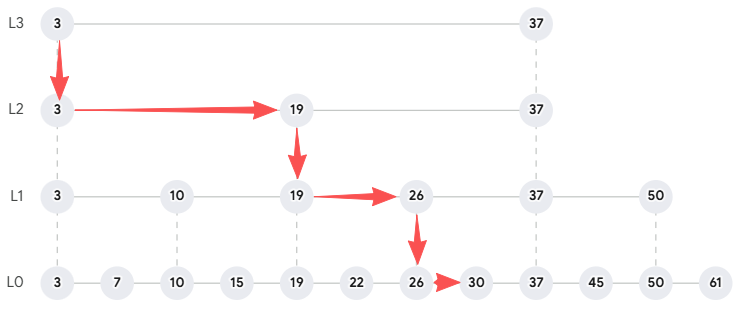
查询时,以查找 30 为例:
-
从最高层的最左侧开始。
-
如果当前节点的下一个节点比 30 小,就向右跳。
-
如果当前节点的下一个节点比 30 大或者已经是末尾,就向下掉一层。
-
重复此过程,直到在某一层找到 30,或者在底层确定该元素不存在。
跳表通过随机层数机制,平均每层节点数是下一层的 1/2 或 1/4,查询效率 O(logN)。插入和删除时只需要修改相邻节点的指针,维护成本较低。
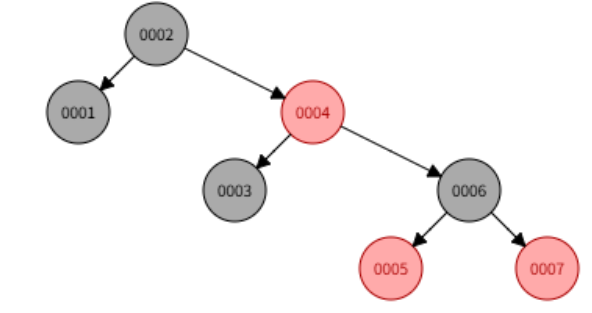
- 对比红黑树:跳表实现更简单;在进行范围查找(如排行榜获取前 10 名)时,跳表只需要找到起点然后顺着底层链表遍历即可,而红黑树需要中序遍历,跳表效率更高;跳表的插入/删除只需修改相邻节点的指针,不需要像红黑树那样做复杂的旋转。
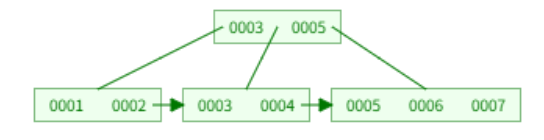
- 对比 B+ 树:B+ 树是为了最大限度减少磁盘 I/O 而设计的,树的高度较矮。但 Redis 是内存数据库,不需要考虑磁盘 I/O,跳表作为内存数据结构,其随机层数机制和简单的节点维护成本更低。
二、 持久化机制
4. Redis 的持久化是怎么实现的?
Redis 提供了两种持久化机制:
- RDB (Redis DataBase):快照机制,定期将内存中的数据以二进制文件(dump.rdb)保存到磁盘。可以通过 save(阻塞)或 bgsave(异步,fork 子进程)命令触发,也可以配置自动触发条件。恢复时直接加载 RDB 文件到内存,速度快,但可能丢失两次快照之间的数据。
- AOF (Append Only File):日志机制,记录服务器执行的所有写操作命令(appendonly.aof)。可以配置不同的同步策略(always、everysec、no)。恢复时需要重新执行 AOF 文件中的命令,速度较慢,但数据安全性高(最多丢一秒的数据)。
5. RDB 和 AOF 持久化的区别?
| 特性 | RDB (Redis DataBase) | AOF (Append Only File) |
|---|---|---|
| 原理 | 快照:将某个时间点的所有内存数据以二进制文件(dump.rdb)保存。 | 日志:记录服务器执行的所有写操作命令(appendonly.aof)。 |
| 触发方式 | save (阻塞), bgsave (异步,fork 子进程), 自动触发配置 | always (每次写), everysec (每秒,默认), no (交由操作系统) |
| 文件大小 | 较小(二进制压缩格式) | 较大(文本格式记录了所有写命令) |
| 恢复速度 | 快(直接把数据读入内存即可) | 慢(需要把所有命令重新执行一遍) |
| 数据安全性 | 容易丢数据(两次快照之间的数据会丢失) | 安全性高(最多丢一秒的数据) |
6. 什么是 AOF 重写(AOF Rewrite)?
随着命令不断写入,AOF 文件会越来越大。AOF 重写机制就是用来压缩 AOF 文件的。
- 原理:Redis 会 fork 出一个 bgrewriteaof 子进程,它会扫描当前内存中的数据,为每一个键值对生成一条对应的插入命令,写入到新的 AOF 文件中。比如以前对一个 key 进行了 100 次自增,重写后只会变成一条 SET key 100 的命令,大大减小了体积。
- 混合持久化:Redis 4.0 引入,AOF 重写时,将当前内存数据以 RDB 格式写入新 AOF 文件的开头,之后的新写入命令继续以 AOF 格式追加。结合了 RDB 恢复快和 AOF 数据不丢失的优点。
三、 内存淘汰与过期策略
7. Redis 的过期键删除策略是什么?
Redis 使用了 惰性删除 + 定期删除 的配合策略:
- 惰性删除:平时不主动管,只有当客户端试图访问某个 key 时,Redis 才去检查它是否过期,如果过期了就删除并返回空。优点是省 CPU,缺点是如果过期 key 一直不被访问,会造成内存泄漏。
- 定期删除:Redis 默认每秒执行 10 次清理操作,随机抽取一部分设置了过期时间的 key,检查并删除已过期的。这种机制可以防止内存被大量无人访问的过期 key 占满。
8. Redis 的内存淘汰策略有哪些?(当内存满了怎么办)
当 Redis 内存使用达到 max memory 限制时,会触发淘汰策略:
- noeviction(默认):不淘汰数据,如果有写请求直接报错 (OOM)。
- allkeys-lru:在所有 key 中,淘汰最近最少使用的 key(最常用)。
- volatile-lru:在设置了过期时间的 key 中,淘汰最近最少使用的。
- allkeys-random / volatile-random:随机淘汰。
- volatile-ttl:淘汰即将过期的 key。
- allkeys-lfu / volatile-lfu(Redis 4.0+ 引入):淘汰使用频率最少的 key(Least Frequently Used)。解决了 LRU 无法应对偶发性冷数据全表扫描的问题。
四、 缓存高并发经典问题(穿透、击穿、雪崩)
9. 什么是缓存穿透?如何解决?
-
定义:查询一个根本不存在的数据,缓存中肯定查不到(不命中),导致请求每次都要去数据库查,如果有人恶意疯狂请求这个不存在的 key,数据库可能会瞬间崩掉。
-
解决方案:
- 缓存空对象/默认值:当数据库查不到时,依然把这个空结果(如 null)存入缓存,设置一个较短的过期时间。
- 布隆过滤器 (Bloom Filter):在请求到达缓存之前,先经过布隆过滤器判断该 key 是否存在。如果布隆过滤器说不存在,那一定不存在,直接返回;如果说存在(有极小误判率),再去查缓存和 DB。
-
补充:布隆过滤器是一个空间效率极高的概率型数据结构,可以判断一个元素是否在一个集合中。它使用多个哈希函数将元素映射到一个位数组上,查询时同样通过哈希函数检查对应位是否为 1。虽然存在误判(可能会误判某个不存在的元素为存在),但绝不会漏判(真正存在的元素一定会被识别)。因此非常适合用来做缓存穿透的第一道防线。
10. 什么是缓存击穿?如何解决?
-
定义:一个极度热点的数据(比如秒杀商品),在缓存过期的瞬间,有极其庞大的并发请求过来。因为缓存失效了,这几万个请求会同时去穿透到数据库,导致数据库瞬间崩溃。
-
解决方案:
- 互斥锁 (Mutex Lock):在缓存失效去数据库查询重建缓存的这个步骤加上分布式锁(如 Redis 的 SETNX)。保证只有一个请求能打到 DB 并更新缓存,其他请求拿不到锁就休眠重试。
- 逻辑过期 (热点数据永不过期):物理上不设置 TTL,而是在 value 内部维护一个逻辑过期时间字段。发现逻辑过期时,异步开启一个线程去更新缓存,当前请求先返回旧数据。
-
补充:分布式锁是分布式系统中用来保证多个进程或线程之间互斥访问共享资源的机制。它的实现细节非常重要,必须保证“谁加的锁只有谁能解”,防止误删别人的锁。通常会在加锁时设置一个唯一的随机值(如 UUID),解锁时通过 Lua 脚本比对这个值,只有匹配成功才删除锁。
11. 什么是缓存雪崩?如何解决?
- 定义:大量的热点 key 在同一时间集中过期,或者 Redis 服务宕机。导致海量请求直接打到数据库,引发数据库宕机乃至整个系统雪崩。
- 解决方案:
- 打散过期时间:在设置 TTL 时,给基础时间加上一个随机值(如 1-5 分钟),避免大量 key 在同一秒过期。
- 服务高可用:搭建 Redis 哨兵 (Sentinel) 或 集群 (Cluster) 架构,防止 Redis 单点故障。
- 限流降级:在应用层(如使用 Sentinel/Hystrix)做好限流熔断,保护底层数据库。
五、 分布式锁与双写一致性
12. 如何用 Redis 实现分布式锁?
- 基础版本:使用 SET resource_name my_random_value NX PX 30000。
- NX:表示 Not eXists,只有 key 不存在时才设置成功(保证互斥性)。
- PX 30000:设置过期时间为 30 秒(防止宕机死锁)。
- my_random_value:必须是客户端唯一的随机 ID,解锁时通过 Lua 脚本比对这个值,保证“谁加的锁只有谁能解”,防止误删别人的锁。
- 进阶版本 (Redisson):基础版本的锁如果业务执行时间太长,锁提前过期了怎么办?Redisson 框架提供了 看门狗 (Watch Dog) 机制。加锁成功后,会开启一个后台线程,每隔 10 秒(默认超时时间 30s 的 1/3)检查一下业务是否还在执行,如果还在执行就将锁的过期时间续期回 30s。
13. Redis 和 MySQL 如何保证双写一致性?
这是面试高频必杀题。标准的处理模式是 Cache Aside Pattern(旁路缓存模式)。
- 标准操作:先更新数据库,再删除缓存。
- 为什么不能先更新缓存再更新 DB? 如果 DB 更新失败,缓存就是脏数据。
- 为什么不能先删缓存再更新 DB? 在并发环境下,线程 A 删了缓存还没更新 DB,线程 B 进来查缓存没命中,去 DB 读到了旧数据并写入缓存。然后 A 更新了 DB。导致缓存里永远是旧数据。
- 先更新 DB 再删缓存,有没有可能出问题? 有。A 查 DB 读到旧数据(还未写缓存),B 更新 DB 并删缓存,A 将刚才的旧数据写入缓存。但这种情况概率极低(要求写操作比读操作还快)。
- 为什么是删除缓存而不是更新缓存? 因为更新缓存需要保证原子性(更新 DB 和更新缓存必须是一个原子操作),而 Redis 没有提供这样的事务机制。删除缓存后,下一次读请求会去 DB 读到最新数据并写入缓存。
- 解决方案:
- 加分布式锁:在更新 DB 和删除缓存的过程中加锁,保证同一时间只有一个线程能操作这个 key。缺点是性能较差,增加了复杂度。
- 逻辑过期:不设置物理过期时间,而是在 value 内部维护一个逻辑过期时间字段。更新 DB 后,直接更新缓存并重置逻辑过期时间。读请求发现逻辑过期时,异步开启一个线程去更新缓存,当前请求先返回旧数据。缺点是可能会有短暂的脏数据窗口。
- 终极保障方案(延迟双删 / 消息队列):
- 延迟双删:先删缓存 -> 更新 DB -> 睡眠(如 500ms) -> 再次删缓存。确保把读请求可能产生的脏缓存删掉。
- 基于 Canal + 消息队列(推荐):业务代码只管更新数据库。通过 Canal 伪装成 MySQL 从节点监听 binlog,提取出修改的数据后扔到 MQ 中,消费者订阅 MQ 去异步且可靠地删除 Redis 缓存。
六、 高可用与集群架构
14. 主从复制的原理是什么?
- 全量同步:当从节点第一次连接主节点时。主节点执行 bgsave 生成 RDB 文件发送给从节点,从节点加载。期间主节点的新写命令会存入 replication buffer,RDB 发送完后再把 buffer 里的命令发给从节点。
- 增量同步:网络断开重连后,主节点根据从节点上报的 offset,从 repl_backlog_buffer(环形缓冲区)中把断开期间的命令发给从节点,无需重新全量同步。
15. 什么是哨兵模式 (Sentinel)?
主从复制无法自动故障转移。哨兵就是用来监控主从节点的:
- 监控:不断向主从节点发送 PING 检查是否在线(主观下线、客观下线)。
- 故障转移 (Failover):主节点挂了,哨兵集群会通过 Raft 算法选举出一个 Leader 哨兵,由它在从节点中选出一个新的主节点(根据优先级、复制偏移量 offset、RunID 选举)。
- 通知:将新的主节点信息通知给客户端和其他从节点。
16. Redis Cluster 集群的原理?什么是哈希槽 (Hash Slot)?
哨兵模式解决了高可用,但无法解决单机内存上限和写并发能力瓶颈。Redis Cluster 提供了**分布式(分片)**方案。
- 哈希槽:Redis 集群没有使用一致性 Hash,而是引入了 16384 个哈希槽。集群的每个主节点负责一部分槽。
- 寻址过程:当客户端发送命令时,对 key 使用 CRC16 算法取模 16384,计算出该 key 属于哪个槽。
- 去中心化:集群中没有中心节点,节点之间通过 Gossip 协议交换彼此的状态和槽信息。如果客户端请求打到了错误的节点,节点会返回 MOVED 重定向指令,让客户端去正确的节点操作。