PyTorch 是当前最流行的深度学习框架之一,由 Meta(原 Facebook)开源,凭借其简洁的 Python 语法、动态图机制和友好的调试体验,成为了深度学习入门的首选框架。
这份文档将带你从零开始,一步一步掌握 PyTorch 的核心知识,不需要你有任何深度学习基础,只要你会基础的 Python 编程,就能跟着这份指南,最终完成你的第一个 AI 项目 —— 手写数字识别。
本文只是一个入门级的 PyTorch 教程,更详细的教程可以参考官方文档和官方教程,这里我们会用最简单的语言,最实用的例子,帮你快速上手 PyTorch!
第一章:环境搭建:保姆级安装教程
对于零基础的你来说,第一步就是把环境搭好,这是所有学习的基础。我们会覆盖 Windows、Linux、Mac 全平台,以及 CPU 和 GPU 版本的安装。
1.1 为什么要使用虚拟环境?
在安装 PyTorch 之前,强烈推荐你使用 Anaconda/Miniconda 来管理 Python 环境。它可以帮你:
如果你还没有安装 Miniconda,可以先去官网下载,选择对应你系统的版本,一路默认安装即可。
1.2 创建并激活虚拟环境
打开你的终端(Windows 用 Anaconda Prompt,Linux/Mac 用终端),输入以下命令:
1
2
3
4
5
|
# 创建一个名为 learn_pytorch 的虚拟环境,Python 版本选择 3.10(最稳定兼容的版本)
conda create -n learn_pytorch python=3.10 -y

# 激活这个环境
conda activate learn_pytorch
|
激活成功后,你会看到你的终端前缀变成了 (learn_pytorch),这说明你已经进入了这个独立的环境,接下来的所有安装都只会在这个环境里生效,不会影响你的系统。
1.3 安装 PyTorch:CPU 版本(通用)
如果你没有 NVIDIA 显卡,或者只是想先试试,直接安装 CPU 版本就可以了,所有平台通用:
Pip 安装(简单直接)
1
|
pip install torch torchvision torchaudio
|
Conda 安装(更稳定)
1
|
conda install pytorch torchvision torchaudio cpuonly -c pytorch
|
1.4 安装 PyTorch:GPU 版本(NVIDIA 显卡专属)
如果你有 NVIDIA 显卡,强烈建议安装 GPU 版本,它能让你的训练速度提升几十甚至上百倍!
第一步:检查你的显卡支持的 CUDA 版本
打开终端,输入:
你会看到类似下面的输出:
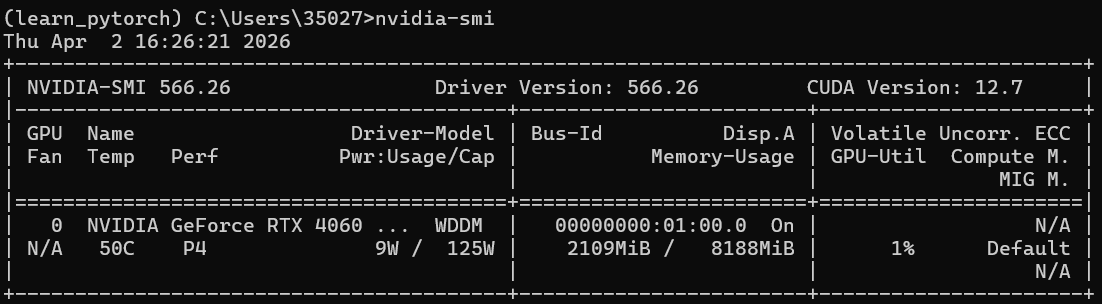
注意右上角的 CUDA Version: 12.7,这是你的显卡驱动最高支持的 CUDA 版本,你安装的 PyTorch 的 CUDA 版本不能超过这个值!
第二步:根据你的 CUDA 版本安装 PyTorch
比如你的显卡支持 CUDA 12.7,就用下面的命令,因为没有 CUDA 12.7 的预编译版本,这里使用 12.6 的版本:
Pip 安装
1
|
pip3 install torch torchvision --index-url https://download.pytorch.org/whl/cu126
|
💡 如果你是其他 CUDA 版本,比如 11.8,只需要把上面的 12.6 换成 11.8 就可以了。
你也可以直接去PyTorch 官网,选择你的系统和配置,官网会自动给你生成对应的安装命令,绝对不会错!
1.5 Mac 用户专属:M 芯片的 GPU 加速
如果你用的是苹果的 M1/M2/M3 芯片,PyTorch 已经原生支持了 Metal 加速,不需要额外安装 CUDA,直接安装默认版本就可以自动使用 GPU 加速了:
1
|
conda install pytorch torchvision torchaudio -c pytorch
|
1.6 验证安装是否成功
安装完成后,我们来验证一下环境是否正常:
在终端里输入 python 进入 Python 交互环境,然后输入下面的代码:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
|
import torch

# 打印 PyTorch 版本
print(f"PyTorch 版本: {torch.__version__}")

# 检查 CUDA 是否可用(GPU 版本才会是 True)
print(f"CUDA 是否可用: {torch.cuda.is_available()}")

# 检查 MPS 是否可用(Mac M 芯片才会是 True)
print(f"MPS 是否可用: {torch.backends.mps.is_available()}")

# 测试创建一个张量
x = torch.rand(5, 3)
print("创建的随机张量:")
print(x)
|
如果能正常输出,没有报错,说明你的环境已经安装成功了!
1.7 VS Code 用户专属:安装 Python 插件
如果你使用 VS Code 作为你的代码编辑器,强烈建议安装官方的 Python 插件,这样你就可以在 VS Code 里直接运行 Python 代码,调试也非常方便。
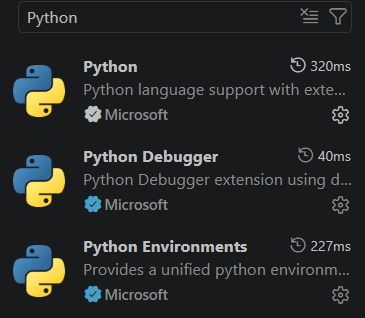
安装完成后,打开你的 Python 文件,观察 VS Code 窗口的右下角,你会看到当前使用的 Python 版本号,点击它可以选择你刚才创建的 learn_pytorch 虚拟环境,这样你在 VS Code 里运行代码的时候,就会使用这个环境里的 PyTorch 了!
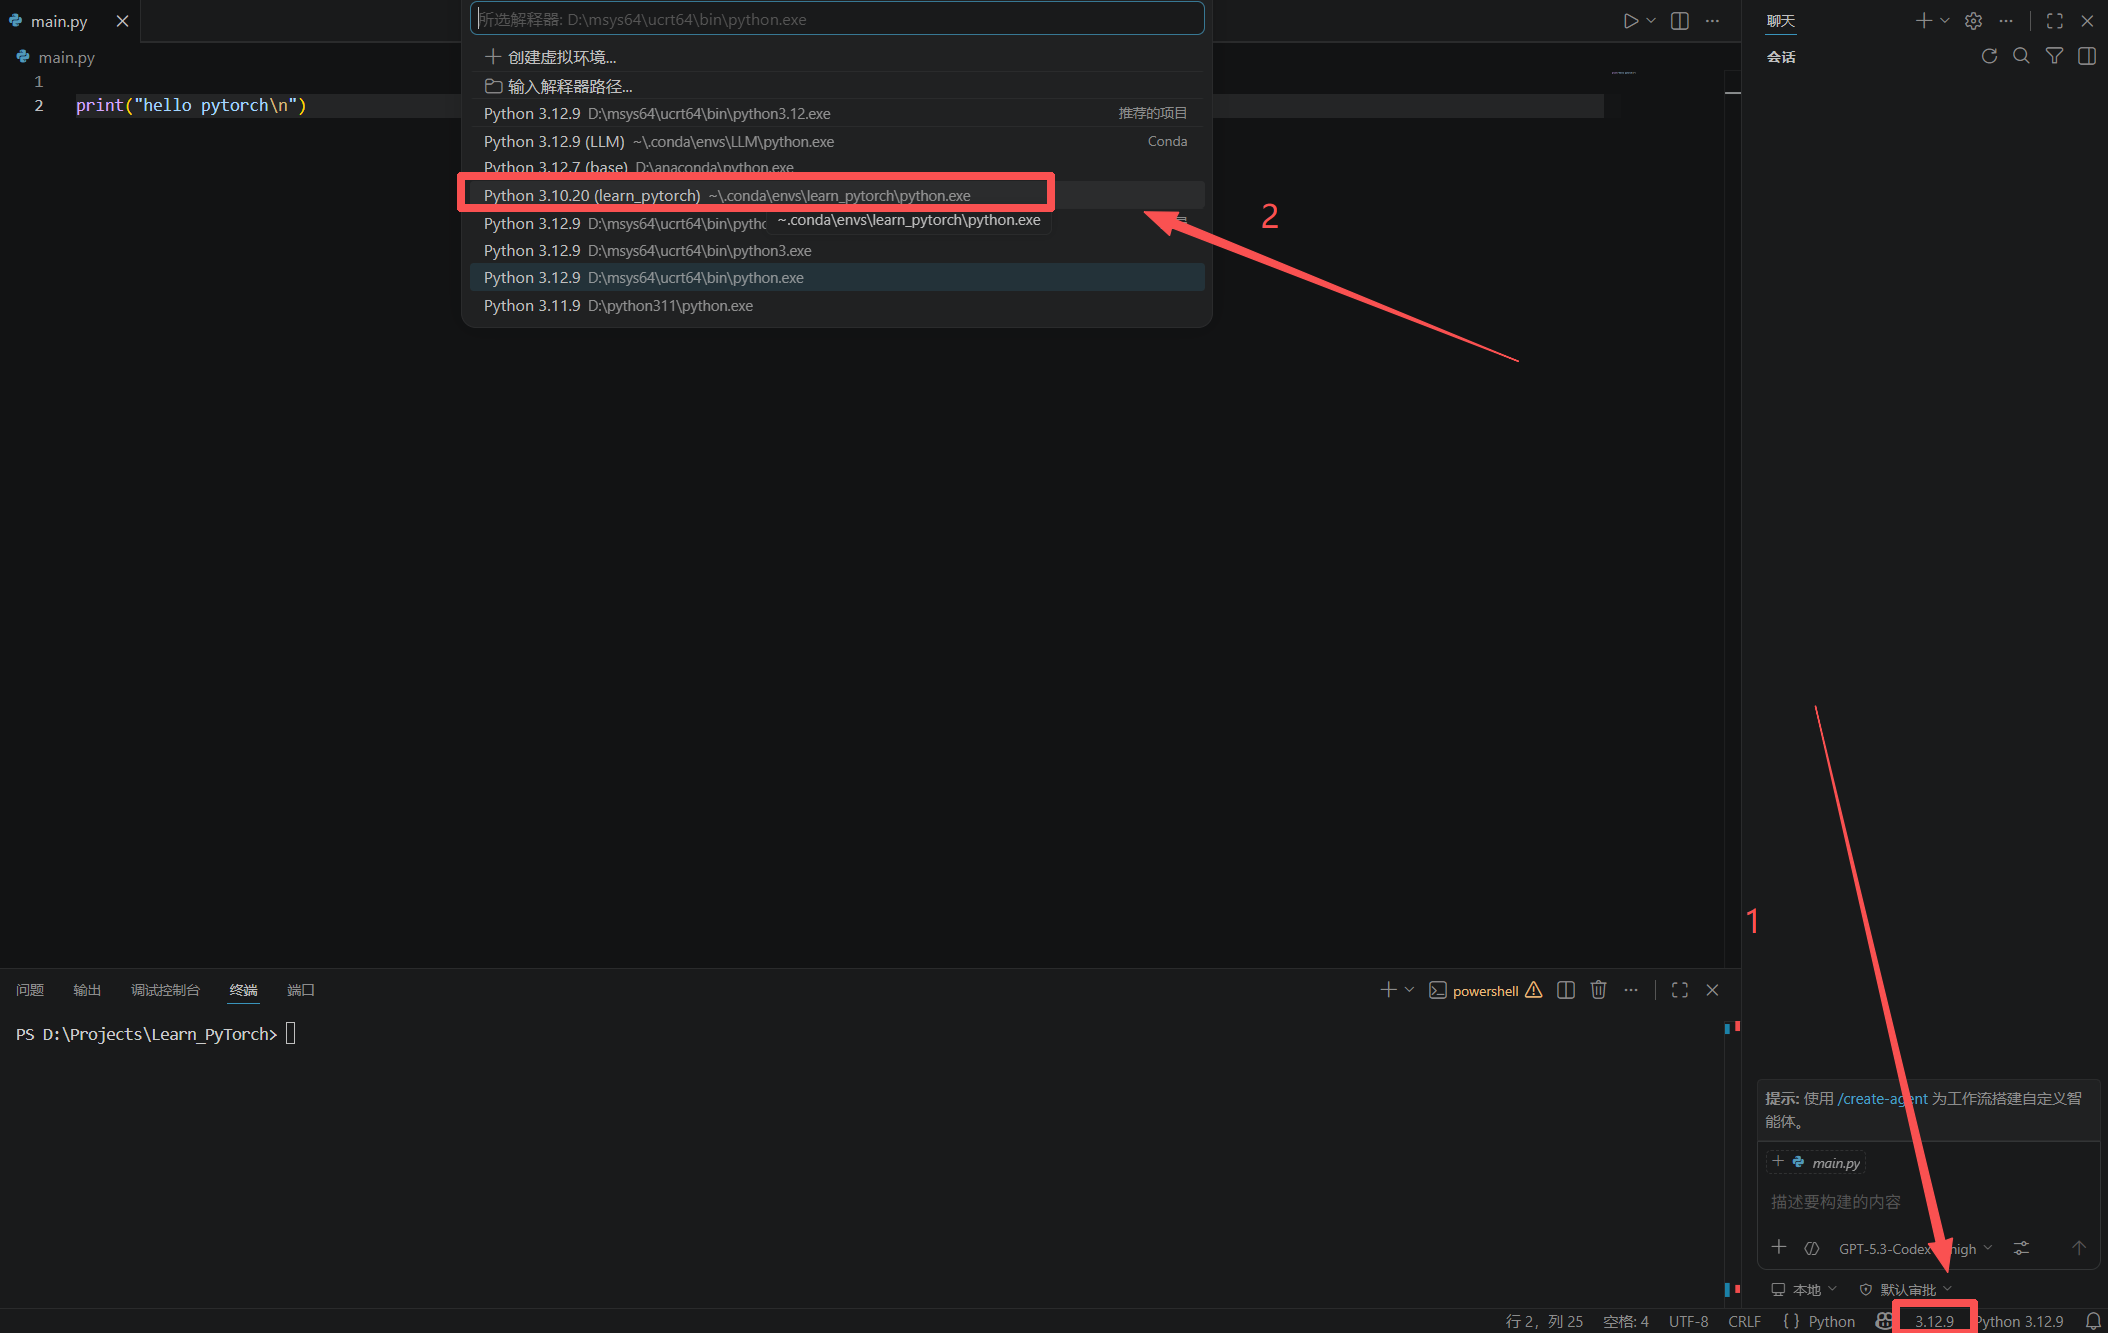
可以在VS Code的终端中输入 python,然后输入 import torch; print(torch.__version__) 来验证一下 VS Code 是否正确识别了你的环境。如果不能识别,重启VS Code的终端即可。
1.8 安装常见问题解决
问题 1:下载速度太慢?
用国内的镜像源加速:
1
2
3
4
5
|
# Pip 清华源
pip install torch torchvision torchaudio -i https://pypi.tuna.tsinghua.edu.cn/simple

# Conda 清华源
conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud/pytorch/
|
问题 2:CUDA 不可用?
-
检查你的 PyTorch 版本和 CUDA 版本是否匹配
-
检查你的显卡是否是 NVIDIA 的(AMD 显卡不支持 CUDA)
-
尝试重新安装对应 CUDA 版本的 PyTorch
问题 3:Windows 下安装报错?
第二章:核心基础:张量(Tensor)——PyTorch 的数字积木
环境搭好了,接下来我们来学习 PyTorch 最基础的概念:张量(Tensor)。
2.1 什么是张量?
简单来说,张量就是一个多维数组。你可以把它理解为升级版的 NumPy 数组,但是它有两个超能力:
-
可以在 GPU 上运行,加速计算
-
可以自动记录计算历史,帮你自动求导
我们平时接触的所有数据,最终都会变成张量,才能在 PyTorch 里处理。
| 维度 |
名称 |
生活中的例子 |
| 0 维 |
标量 |
一个单独的数字,比如 5、3.14 |
| 1 维 |
向量 |
一行数据,比如 [1,2,3,4],就像你的成绩单 |
| 2 维 |
矩阵 |
一个表格,比如 Excel 的二维表格 |
| 3 维 |
3D 张量 |
一张彩色图片,形状是 (高, 宽, 通道),比如 28×28 的灰度图是 (28,28,1) |
| 4 维 |
4D 张量 |
一批图片,形状是 (批次, 通道, 高, 宽),比如一次喂 32 张图片就是 (32,1,28,28) |
2.2 如何创建张量?
PyTorch 提供了非常多的方式来创建张量,我们一个个来看:
1. 从 Python 列表直接创建
这是最基础的方式:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
|
import torch
import numpy as np

# ======== 从 Python 列表创建张量 ========
# 从列表创建1维张量
t1 = torch.tensor([1, 2, 3, 4])
print(t1)

# 从二维列表创建2维张量
t2 = torch.tensor([[1, 2], [3, 4]])
print(t2)

# 如果把tensor大写为Tensor,则会创建一个默认类型的张量,通常是torch.float32
t3 = torch.Tensor([1, 2, 3, 4])
print(t3)

print("==============================")
|
⚠️ 避坑提醒:永远用小写的 torch.tensor(),不要用大写的 torch.Tensor()!
如果把tensor大写为Tensor,则会创建一个默认类型的张量,通常是torch.float32,这可能会导致你后续的计算出现类型不匹配的错误,尤其是当你想创建整数张量时。
2. 从 NumPy 数组创建
如果你已经有了 NumPy 数组,可以直接转成张量:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
|
# ======== 从 NumPy 数组创建张量 ========
# 创建一个 NumPy 数组
np_arr = np.array([[1, 2], [3, 4]])
print(np_arr)

# 转成 PyTorch 张量
t4 = torch.from_numpy(np_arr)
print(t4)

# 默认情况下,torch.from_numpy() 创建的张量与原始 NumPy 数组共享内存。这意味着修改张量会影响原始数组,反之亦然。
t4[0, 0] = 10  # 修改张量的值
print(t4)       # 张量被修改了
print(np_arr)   # NumPy 数组也被修改了,因为它们共享内存

# 如果不想共享内存,可以使用 torch.tensor() 来创建一个新的张量
t5 = torch.tensor(np_arr)
# 查看 t5 和 np_arr 的内存地址
print("t5 内存地址:", t5.data_ptr())
print("np_arr 内存地址:", np_arr.__array_interface__['data'][0])
|
💡 注意:默认情况下,NumPy 数组和张量是共享内存的!修改其中一个,另一个也会跟着变!
如果你想要独立的副本,用 t3 = torch.tensor(np_arr),这会做一个深拷贝。
3. 创建特殊值的张量
很多时候我们需要创建全 0、全 1、或者随机的张量:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
|
# ======== 创建特殊值的张量 ========
# 创建全零张量
t_zeros = torch.zeros((2, 3))
print(t_zeros)

# 创建全一张量
t_ones = torch.ones((2, 3))
print(t_ones)

# 创建指定值的张量,比如666
t_full = torch.full((2, 3), 666)
print(t_full)

# 单位矩阵
t_eye = torch.eye(3)
print(t_eye)
|
4. 创建随机张量
深度学习里我们经常需要随机初始化权重,PyTorch 提供了很多随机函数:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
|
# ======== 创建随机张量 ========
# [0, 1) 均匀分布的随机张量
t_rand = torch.rand((2, 4))
print(t_rand)

# 标准正态分布(均值0,方差1)的随机数,这是权重初始化最常用的
t_randn = torch.randn((2, 3))
print(t_randn)

# 随机整数,范围是 [1,10),形状是 2x3
t_randint = torch.randint(1, 10, (2,3))
print(t_randint)
|
5. _like 系列:自动匹配形状
如果你想创建一个和已有张量形状一样的新张量,用 _like 系列函数,不用手动写形状,非常方便:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
|
# ======== _like 系列:自动匹配形状 ========
# 假设外面已经有一个张量
old_t = torch.randn((2,3))

# 创建一个和 old_t 形状研一的全1张量
new_t = torch.ones_like(old_t)
print(new_t.size())
# 或者print(new_t.shape)  # 都会输出 torch.Size([2, 3])

# 同理还有 zeros_like, full_like, rand_like 等等
|
2.3 张量的属性
每个张量都有几个核心属性:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
|
import torch
import numpy as np

t = torch.randn((3,4))

print(f"形状:{t.shape}")       # 张量的维度大小
print(f"数据类型:{t.dtype}")   # 里面元素的类型,默认是 float32
print(f"存储设备:{t.device}")  # 存在 CPU 还是 GPU 上


# 如果你有GPU,只需要一行代码,就能把张量移动到GPU上加速
# 自动选择设备:有GPU用GPU,否则用CPU
device = "cuda" if torch.cuda.is_available() else "cpu"

# 把张量移动到GPU上
t = t.to(device)
print(f"存储设备:{t.device}")  # 存在 CPU 还是 GPU 上
|
2.4 张量的基本操作
张量的操作和 NumPy 几乎一模一样,如果你会 NumPy,那你直接就会用了!
1. 索引和切片
和 Python 列表、NumPy 一样,你可以索引和切片张量:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
|
import torch
import numpy as np

# ========= 索引和切片 =========
t = torch.tensor([[1,2,3,4],[5,6,7,8],[9,10,11,12]])

# 取第0行
print(t[0])

# 取第0列,[行,列],:表示所有行
print(t[:,0])

# 取最后一列,-1表示最后一个元素
print(t[:,-1])
|
2. 算术运算
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
|
# ========= 算术运算 =========
a = torch.tensor([1,2,3])
b = torch.tensor([4,5,6])

# 元素相加,对应位置元素相加,等价于torch.add(a,b)
print(a + b)

# 元素相乘,对应位置元素相乘,等价于torch.mul(a,b)
print(a * b)

# 矩阵乘法,对应位置元素相乘再加起来,等价于torch.matmul(a,b)
print(a @ b)
|
3. 形状变换
很多时候我们需要改变张量的形状,比如把图片展平:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
|
# ========= 形状变换 =========
t = torch.randn([4,4])
print(t.shape)

# 展开成 1 维
t_flat = t.reshape(16)
print(t_flat.shape)

# 也可以用 -1 让 PyTorch 自动计算维度,-1表示自动推断维度大小
t_flat2 = t.reshape(-1)
print(t_flat2.shape)

# 转成2行8列
t2 = t.reshape([2,8])
print(t2.shape)

# 也可指定行,自动推断列
t3 = t.reshape([2, -1])
print(t3.shape)
|
4. 把张量移到 GPU 上
如果你有 GPU,只需要一行代码,就能把张量移到 GPU 上加速:
1
2
3
4
5
|
# ========= 把张量转移到GPU上 =========
print(t.device)
device = "cuda" if torch.cuda.is_available() else "cpu"
t = t.to(device)
print(t.device)
|
第三章:自动微分(Autograd)——PyTorch 的灵魂
学完了张量,接下来我们来学习 PyTorch 最核心的功能:自动微分。这也是为什么 PyTorch 能这么方便的训练神经网络的原因。
3.1 什么是自动微分?
深度学习训练的核心就是反向传播,简单来说就是:我们计算出预测的误差(损失)之后,要把这个误差反向传给每一个参数,然后根据误差调整参数,让误差越来越小。
这个过程里最麻烦的就是求梯度(也就是求导),手动求导太麻烦了,而 PyTorch 的自动微分可以帮你自动计算所有参数的梯度,你只需要写前向传播的代码,剩下的求导 PyTorch 帮你搞定!
3.2 一个最简单的例子
我们来看一个最简单的例子,帮你理解自动微分:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
|
import torch
import numpy as np

# 定义一个参数w,我们要对他求导,所以设置requires_grad = True
# requires_grad是PyTorch中一个非常重要的属性,它告诉PyTorch需要对这个张量进行梯度计算。只有设置了requires_grad=True的张量,PyTorch才会在反向传播过程中计算它的梯度。
w = torch.tensor(10.0, requires_grad=True)

# 前向传播:我们的损失函数是 loss = 2 * w²
loss = 2 * w ** 2

# 反向传播:自动计算梯度,
loss.backward()

# 查看 w 的梯度,也就是 d(loss)/dw,pytorch会自动计算这个值,并存储在 w.grad 中
print(w.grad)
|
我们手动算一下:对 loss=2w² 求导,导数是 4w,w 是 10,所以导数是 40,和 PyTorch 算出来的一模一样!
就这么简单!PyTorch 自动帮你完成了求导,你完全不用管中间的过程!
3.3 核心概念解释
-
requires_grad=True:告诉 PyTorch,这个张量是需要求梯度的,你要记录它的所有计算历史。
-
计算图:当你做前向计算的时候,PyTorch 会在背后偷偷构建一个动态的计算图,记录所有的操作。
-
loss.backward():触发反向传播,从损失开始,沿着计算图反向遍历,自动算出所有 requires_grad=True 的张量的梯度。
-
w.grad:计算出来的梯度会存在张量的 .grad 属性里,你可以直接用它来更新参数。
3.4 训练循环的核心模板
这是所有深度学习训练的核心模板,你一定要记住:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
|
# 1. 梯度清零!PyTorch 默认会累积梯度,所以每次迭代都要清零!
optimizer.zero_grad()

# 2. 前向传播:计算预测值和损失
output = model(input)
loss = loss_fn(output, target)

# 3. 反向传播:自动计算梯度
loss.backward()

# 4. 更新参数:根据梯度更新模型的参数
optimizer.step()
|
⚠️ 最重要的坑:梯度清零!
如果你忘记了 optimizer.zero_grad(),梯度会一直累加,导致你的训练完全乱掉!这是新手最常见的错误!
第四章:数据加载:把数据喂给模型
数据是深度学习的燃料,PyTorch 提供了非常方便的工具来加载和处理数据,核心就是两个类:Dataset 和 DataLoader。
4.1 Dataset:你的数据集
Dataset 是 PyTorch 对数据集的抽象,它代表了你的所有样本。你可以用内置的数据集,也可以自定义自己的。
内置的数据集比如 MNIST、CIFAR10 等等,PyTorch 已经帮你下载好了,你只需要一行代码就能加载:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
|
from torchvision import datasets
from torchvision.transforms import ToTensor

# 加载 MNIST 训练集,自动下载到 data 目录
train_data = datasets.MNIST(
    root="data",        # 数据保存的目录
    train=True,         # True是训练集,False是测试集
    download=True,      # 本地没有就自动下载
    transform=ToTensor()# 把图片转成张量,并且归一化到 0~1
)
|
4.2 DataLoader:批量加载数据
Dataset 给了你所有的样本,但是训练的时候我们是一批一批的喂给模型的,DataLoader 就是帮你做这个的:
-
把数据集分成一个个的 batch
-
自动打乱数据(训练的时候需要)
-
多线程加载数据,加快速度
1
2
3
4
5
6
7
8
9
|
from torch.utils.data import DataLoader

train_loader = DataLoader(
    train_data,
    batch_size=32,          # 每个batch 32个样本
    shuffle=True,           # 训练的时候打乱数据,防止过拟合
    num_workers=4,          # 用4个线程加载数据,加快速度
    pin_memory=True         # 加速GPU数据传输
)
|
DataLoader 核心参数详解
| 参数 |
作用 |
最佳实践 |
batch_size |
每个批次的样本数 |
一般用 32/64/128,根据你的显存调整 |
shuffle |
是否打乱数据 |
训练集设为 True,测试集设为 False |
num_workers |
加载数据的线程数 |
一般设为 CPU 核心数的一半,不要太大 |
pin_memory |
锁页内存,加速 GPU 传输 |
有 GPU 的话设为 True,能提升速度 |
⚠️ Windows 注意:如果你用 Windows,并且设置了 num_workers>0,你的代码必须放在 if __name__ == '__main__': 里面,否则会报错!
第五章:构建你的第一个神经网络
现在我们来学习如何用 PyTorch 构建神经网络。
5.1 nn.Module:所有模型的基类
在 PyTorch 里,所有的神经网络模型都要继承 nn.Module 这个基类,你只需要实现两个方法:
-
__init__:定义你网络的层
-
forward:定义前向传播的逻辑
5.2 一个简单的全连接网络
我们来定义一个简单的全连接神经网络,也就是多层感知机(MLP):
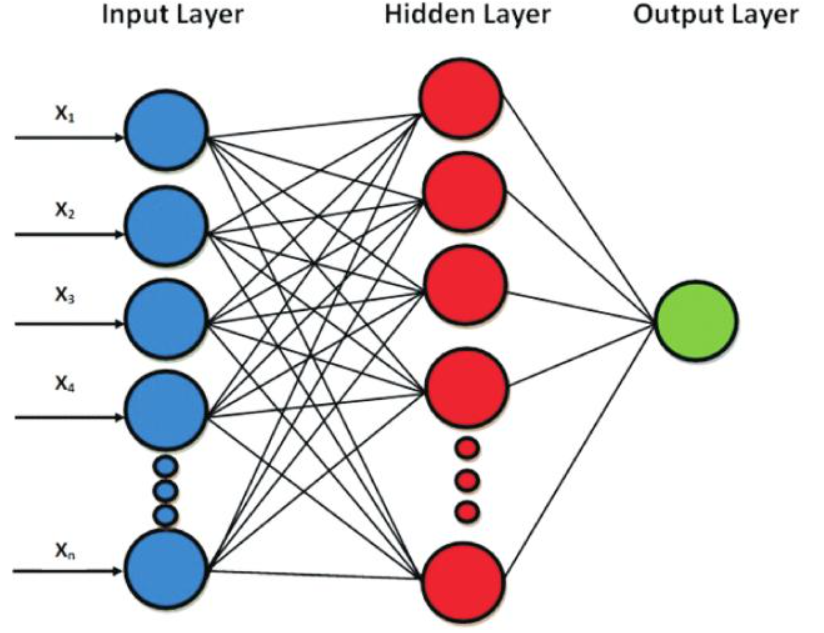
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
|
import torch.nn as nn

class MyNet(nn.Module):
    def __init__(self):
        super().__init__()      # 必须调用父类的初始化

        # 定义我们的类
        self.flatten = nn.Flatten()     # 展平层,把28x28的图片展平成728维
        self.fc1 = nn.Linear(28*28, 128) # 全连接层(线性层):输入784,输出128
        self.fc2 = nn.Linear(128, 256)  # 全连接层(线性层):输入128,输出256
        self.fc3 = nn.Linear(256, 10)   # 输出层:输入256,输出10(对应10个数字)

    def forward(self, x):
        # 前向传播的逻辑,x是输入的张量
        x = self.flatten(x)     # 先展平
        x = self.fc1(x)
        x = torch.relu(x)       # ReLU激活函数,加入非线性
        x = self.fc2(x)
        x = torch.relu(x)
        x = self.fc3(x)

        return x                # 返回输出
|
就这么简单!一个三层的全连接网络就定义好了!
5.3 损失函数和优化器
定义好模型之后,我们还需要两个东西:
-
损失函数:用来衡量我们的预测和真实标签的差距
-
优化器:用来更新模型的参数
1
2
3
4
5
6
7
8
9
|
# 模型实例化,并且转移到GPU上
device = "cuda" if torch.cuda.is_available() else "cpu"
model = MyNet().to(device)

# 损失函数:多分类任务用交叉熵损失
loss_fn = nn.CrossEntropyLoss()

# 优化器:用Adam优化器优化模型的参数,学习率是0.01
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
|
第六章:完整实战:MNIST 手写数字识别
好了,所有的基础我们都学完了,现在我们来做一个完整的实战项目:用 PyTorch 实现手写数字识别,这是深度学习的 Hello World!
6.1 项目介绍
MNIST 是一个经典的数据集,包含了 6 万张训练图片和 1 万张测试图片,都是 28x28 的手写数字灰度图,我们要训练一个模型,能识别这些图片是 0~9 中的哪个数字。
6.2 完整代码
我们把所有的步骤整合起来,你可以直接复制这段代码,运行就能得到结果!
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
|
import torch
from torchvision import datasets
from torchvision.transforms import ToTensor
from torch.utils.data import DataLoader
import torch.nn as nn
import matplotlib.pyplot as plt

# ---------------------- 1. 加载数据 ----------------------
print("正在加载数据...")
# 加载 MNIST 训练集,自动下载到data目录
train_data = datasets.MNIST(
    root="data",        # 数据保存的目录
    train=True,         # True是训练集,False是测试集
    download=True,      # 本地没有就自动下载
    transform=ToTensor()# 把图片转成张量,并且归一化到 0~1
)

test_data = datasets.MNIST(
    root="data",
    train=False,
    download=True,
    transform=ToTensor()
)

# train_loader = DataLoader(
#     train_data,
#     batch_size=32,          # 每个batch 32个样本
#     shuffle=True,           # 训练的时候打乱数据,防止过拟合
#     num_workers=4,          # 用4个线程加载数据,加快速度
#     pin_memory=True         # 加速GPU数据传输
# )

# 可视化几个样本看看
figure = plt.figure(figsize=(8, 8))     # figure是画布,figsize是画布大小
for i in range(9):
    img, label = train_data[i + 59000]
    figure.add_subplot(3, 3, i + 1)   # 3行3列的子图,i+1是第几个子图
    plt.title(label)                   # 标题是标签
    plt.axis("off")                    # 不显示坐标轴
    plt.imshow(img.squeeze(), cmap="gray") # 显示图片,squeeze去掉多余的维度,cmap灰度图
plt.show()

# 创建 DataLoader 的迭代器,准备训练
train_dataloader = DataLoader(train_data, batch_size=32, shuffle=True)
test_dataloader = DataLoader(test_data, batch_size=32, shuffle=False)

# ---------------------- 2. 定义模型 ----------------------
# 选择设备
device = "cuda" if torch.cuda.is_available() else "cpu"
print(f"使用设备:{device}")

# 定义一个简单的多层感知机(MLP)模型
class Model(nn.Module):
    def __init__(self):
        super().__init__()      # 必须调用父类的初始化
        self.flatten = nn.Flatten()     # 展平层,把28x28的图片展平成728维
        self.hidden1 = nn.Linear(28*28, 128) # 全连接层(线性层):输入784,输出128
        self.hidden2 = nn.Linear(128, 256)  # 全连接层(线性层):输入128,输出256
        self.out = nn.Linear(256, 10)   # 输出层:输入256,输出10(对应10个数字)

    def forward(self, x):
        # 前向传播的逻辑,x是输入的张量
        x = self.flatten(x)     # 先展平
        x = self.hidden1(x)
        x = torch.relu(x)       # ReLU激活函数,加入非线性
        x = self.hidden2(x)
        x = torch.relu(x)
        x = self.out(x)

        return x                # 返回输出


# 模型实例化,并且转移到GPU上
model = Model().to(device)
print(model)                    # 打印模型结构看看


# ---------------------- 3. 定义损失函数和优化器 ----------------------
# 损失函数:多分类任务用交叉熵损失
loss_fn = nn.CrossEntropyLoss()

# 优化器:用Adam优化器优化模型的参数,学习率是0.01
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)


# ---------------------- 4. 训练模型 ----------------------
def train(dataloader, model, loss_fn, optimizer):
    model.train()   # 设置模型为训练模式
    batch_num = 0   # 记录训练了多少个batch了

    for X, y in dataloader:   # 遍历每个batch的数据
        batch_num += 1
        X, y = X.to(device), y.to(device)   # 把数据转移到GPU上

        # 前向传播
        pred = model(X)    # 模型的预测结果
        loss = loss_fn(pred, y)  # 计算损失

        # 反向传播和优化
        optimizer.zero_grad()   # 清空之前的梯度
        loss.backward()         # 反向传播计算新的梯度
        optimizer.step()        # 更新模型参数

        if batch_num % 100 == 0:   # 每训练100个batch打印一次损失
            print(f"训练了 {batch_num} 个batch,当前损失:{loss.item():.4f}")


# ----------------------- 5. 测试模型 ----------------------
def test(dataloader, model, loss_fn):
    print("正在测试模型...")
    model.eval()    # 设置模型为评估模式
    size = len(dataloader.dataset)  # 测试集的样本数量
    num_batches = len(dataloader)   # 测试集的batch数量
    print(f"测试集样本数量:{size},batch数量:{num_batches}")
    test_loss, correct = 0, 0       # 累计损失和正确的预测数量


    with torch.inference_mode():    # 自动关闭梯度计算,不需要计算梯度了,节省内存和计算
        for X, y in dataloader:     # 遍历每个batch的数据,X是输入,y是标签。为什么X要大写?因为它是一个张量,习惯上张量用大写字母表示。
            X, y = X.to(device), y.to(device)

            pred = model(X)         # 模型的预测结果,形状是 [batch_size, 10],每行是一个样本的10个类别的预测分数
            test_loss += loss_fn(pred, y).item()  # 累加损失
            correct += (pred.argmax(1) == y).type(torch.float).sum().item()  # 累加正确的预测数量
            # pred.argmax(1) 是取每行最大值的索引,也就是预测的类别,和y比较是否相等,得到一个布尔张量,再转换成float类型,最后求和得到正确的数量

    test_loss /= num_batches  # 平均损失:总损失除以batch数量
    accuracy = correct / size  # 准确率:正确的数量除以总样本数量
    print(f"测试结果:测试集平均损失:{test_loss:.4f},准确率:{accuracy:.4f}")
    return accuracy


# ----------------------- 6. 运行训练和测试 ----------------------
print("开始训练和测试模型...")
epochs = 10

for epoch in range(epochs):
    print(f"Epoch {epoch + 1}/{epochs}\n------------------------------")
    train(train_dataloader, model, loss_fn, optimizer)  # 训练一个epoch:数据加载器、模型、损失函数、优化器
    test(test_dataloader, model, loss_fn)                # 测试模型看看效果:数据加载器、模型、损失函数

print("训练和测试完成!")

# 保存模型
torch.save(model.state_dict(), "model.pth")     # model.state_dict() 是模型的参数字典,保存到 model.pth 文件中
print("模型已保存到 model.pth")
|
6.3 运行结果
运行这段代码,你会看到类似下面的输出:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
|
正在加载数据...
使用设备:cuda
Model(
  (flatten): Flatten(start_dim=1, end_dim=-1)
  (hidden1): Linear(in_features=784, out_features=128, bias=True)
  (hidden2): Linear(in_features=128, out_features=256, bias=True)
  (out): Linear(in_features=256, out_features=10, bias=True)
)
开始训练和测试模型...
Epoch 1/10
------------------------------
训练了 100 个batch,当前损失:0.5379
训练了 200 个batch,当前损失:0.3962
训练了 300 个batch,当前损失:0.2342
训练了 400 个batch,当前损失:0.3782
训练了 500 个batch,当前损失:0.0717
训练了 600 个batch,当前损失:0.3981
训练了 700 个batch,当前损失:0.2678
训练了 800 个batch,当前损失:0.2566
训练了 900 个batch,当前损失:0.4510
训练了 1000 个batch,当前损失:0.2997
训练了 1100 个batch,当前损失:0.2082
训练了 1200 个batch,当前损失:0.2453
训练了 1300 个batch,当前损失:0.0343
训练了 1400 个batch,当前损失:0.5646
训练了 1500 个batch,当前损失:0.1000
训练了 1600 个batch,当前损失:0.5390
训练了 1700 个batch,当前损失:0.4575
训练了 1800 个batch,当前损失:0.2549
正在测试模型...
测试集样本数量:10000,batch数量:313
测试结果:测试集平均损失:0.2858,准确率:0.9220

...

Epoch 10/10
------------------------------
训练了 100 个batch,当前损失:0.2720
训练了 200 个batch,当前损失:0.0058
训练了 300 个batch,当前损失:0.0881
训练了 400 个batch,当前损失:0.0008
训练了 500 个batch,当前损失:0.0016
训练了 600 个batch,当前损失:0.0406
训练了 700 个batch,当前损失:0.0056
训练了 800 个batch,当前损失:0.0145
训练了 900 个batch,当前损失:0.3302
训练了 1000 个batch,当前损失:0.1829
训练了 1100 个batch,当前损失:0.0033
训练了 1200 个batch,当前损失:0.0012
训练了 1300 个batch,当前损失:0.1873
训练了 1400 个batch,当前损失:0.1014
训练了 1500 个batch,当前损失:0.0060
训练了 1600 个batch,当前损失:0.2971
训练了 1700 个batch,当前损失:0.1371
训练了 1800 个batch,当前损失:0.2050
正在测试模型...
测试集样本数量:10000,batch数量:313
测试结果:测试集平均损失:0.1954,准确率:0.9640
训练和测试完成!
模型已保存到 model.pth
|
你看!只用了 10 轮训练,我们的模型就达到了 96.4% 的准确率!也就是说,它能正确识别 96.4% 的手写数字!
每个人的结果可能会有一点差异,因为模型的初始化和数据的加载是随机的,但大体上应该都能达到 95% 以上的准确率,这已经非常不错了!你可以继续训练更多的轮数,或者调整模型结构和超参数,看看能不能达到更高的准确率!
第七章:常见问题与避坑指南
1. CUDA out of memory:显存不足
-
减小 batch_size,比如从 32 改成 16
-
测试的时候用 with torch.no_grad(),关掉梯度计算
-
用 torch.cuda.empty_cache() 清理没用的缓存
2. 训练不收敛,损失不动
3. Windows 下 DataLoader 卡死
- 把你的主程序代码放在
if __name__ == '__main__': 里面,因为 Windows 的多进程需要这个
4. 模型保存和加载
1
2
3
4
5
6
7
|
# 保存
torch.save(model.state_dict(), "model.pth")

# 加载
model = NeuralNetwork()
model.load_state_dict(torch.load("model.pth"))
model.to(device)
|
第八章:接下来你可以学什么?
恭喜你!你已经完成了 PyTorch 的入门,学会了:
-
环境搭建
-
张量操作
-
自动微分
-
数据加载
-
模型构建
-
训练一个完整的分类项目
接下来你可以继续深入学习:
-
卷积神经网络(CNN):用来处理图像,能达到更高的准确率
-
循环神经网络(RNN/LSTM):用来处理序列数据,比如文本、语音
-
迁移学习:用预训练的模型,快速做自己的任务
-
目标检测、图像分割:更复杂的计算机视觉任务
-
Transformer:现在最火的大模型的基础架构
PyTorch 的生态非常丰富,掌握了这份指南里的基础,后面的学习应该都会非常顺利!