This blog is used to record notes while learning Golang.
Video URL: https://www.bilibili.com/video/BV1gf4y1r79E?spm_id_from=333.788.videopod.episodes&vd_source=a28b0a61baf52e2de1f7120e1c9d88e1
Video Author: Liu Danbing
Go学习笔记
第一部分
基本结构
main函数不能有形参和返回值
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
// 程序入口
package main

// fmt 常用标准库
import "fmt"

func main() {
    fmt.Println("Hello World!")

    return 0
}
|
变量声明方式、赋值方式
默认0
1
2
3
|
    var a int
    fmt.Println("a =", a)
    fmt.Printf("type of a: %T\n", a)
|
赋初值
1
2
3
|
    var b int = 100
    fmt.Println("b =", b)
    fmt.Printf("type of b: %T\n", b)
|
省去类型名,类似python
1
2
3
|
    var c = 200
    fmt.Println("c =", c)
    fmt.Printf("type of c: %T\n", c)
|
省去var(最常用方法),直接自动匹配
1
2
3
|
    d := 300
    fmt.Println("d =", d)
    fmt.Printf("type of d: %T\n", d)
|
注:此方式不可用于声明全局变量
常量声明方式、iota的用法
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
|
// const和iota
// const就是定义变量时把var换成const
const PI = 3.1415926

// iota初值为0,往下每行自增1,用于给多个常量赋值
const (
    BEIJING = 10 * iota
    SHANGHAI
    SHENZHEN
)
const (
    a, b = iota + 1, iota + 2 // iota = 0,a = 1,b = 2
    c, d                      // iota = 1,c = 2,d = 3
    e, f                      // iota = 2,e = 3,f = 4

    g, h = iota * 2, iota * 3 // iota = 3,g = 6,h = 9
    i, j                      // iota = 4,i = 8,j = 12
)
|
函数、返回值
单返回值函数
go中的函数参数关键字func在前,类型名与返回值皆在后
1
2
3
4
5
6
7
|
func foo1(a string, b int) int {
    fmt.Println("====foo1====")
    fmt.Println("a =", a, ", b=", b)
    c := 100

    return c
}
|
多返回值函数(1)
多返回值就用括号包起来
1
2
3
4
5
6
7
|
func foo2(a string, b int) (int, int) {
    fmt.Println("====foo2====")
    fmt.Println("a =", a, ", b=", b)
    c := 100

    return c, c + 10
}
|
多返回值函数(2)
go中的函数参数关键字func在前,类型名与返回值皆在后
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
|
func foo3(a string, b int) (r1 int, r2 int) {
    fmt.Println("====foo3====")
    fmt.Println("a =", a, ", b=", b)

    //c := 100
    //return c, c + 10

    // 或者给有名称的返回值赋值
    fmt.Println("r1 =", r1, ", r2 =", r2) // r1,r2属于foo3的形参,初始化默认为0
    r1 = 100
    r2 = 200

    return
}
|
多返回值函数(3)
go中的函数参数关键字func在前,类型名与返回值皆在后
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
|
func foo4(a string, b int) (r1, r2 int) {
    fmt.Println("====foo4====")
    fmt.Println("a =", a, ", b =", b)

    //c := 100
    //return c, c + 10

    // 或者给有名称的返回值赋值
    r1 = 100
    r2 = 200

    return
}
|
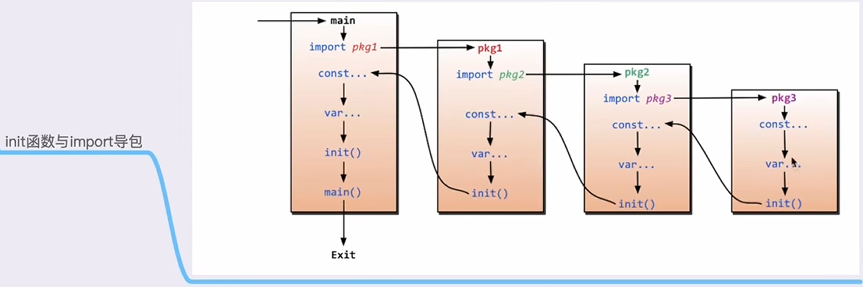
import时init方法调用流程
import匿名及别名导包形式
匿名导包
匿名导包用 _ 表示,可以导入某个包但不使用
1
2
3
4
5
|
import _ "fmt"

func main() {
	// 不会报未使用的错
}
|
别名导包
匿名导包用 . 表示,使用包中的方法时无需指明是哪个包的方法
1
2
3
4
5
6
|
import . "fmt"

func main() {
	Println("hello world")
    // fmt.Println("hello world")
}
|
defer语句
defer是在某个函数要结束时执行的语句,多个defer会用过压栈再出栈的顺序执行.
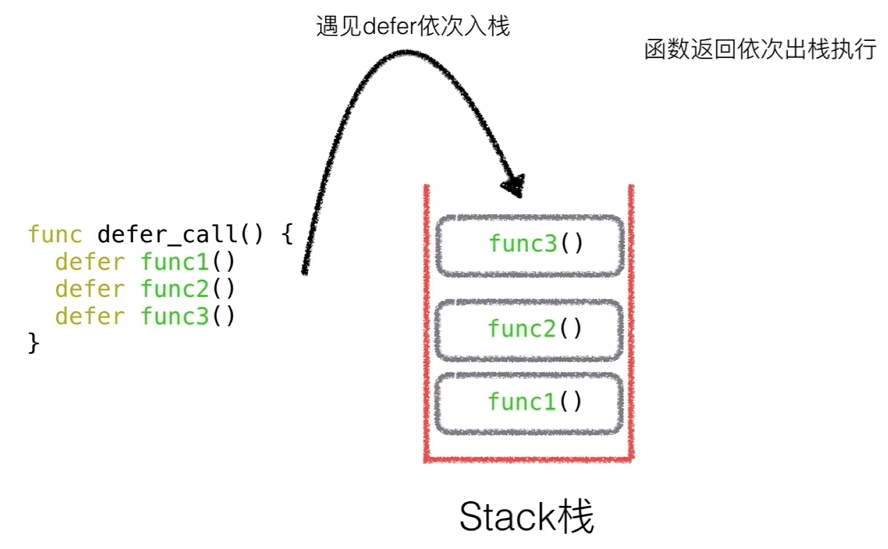 最终的执行顺序应该是func3 -> func2 -> func1。
值得注意的是,当defer和return同时存在时,也是先执行return再执行defer。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
func returnFunc() int {
	fmt.Println("this is returnFunc")
	return 0
}
func deferFunc() {
	fmt.Println("this is deferFunc")
}
func test() int {
	defer deferFunc()
	return returnFunc()
}
|
执行函数test后,输出的结果是:
1
2
|
this is returnFunc
this is deferFunc
|
第二部分
数组的定义
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
|
// 固定长度数组在函数中的参数类型必须一致,且传参是以复制的形式
func test1(myArray [5]int) {
	fmt.Printf("myArray = %v\n", myArray) // %v 表示输出:详细信息
}

func main() {
	//定长数组
	var myArray [5]int

	fmt.Println("myArray =", myArray) // 默认全0:[0 0 0 0 0]

	myArray1 := [10]int{1, 2, 3, 4, 5}
	fmt.Println("myArray1 =", myArray1) // 未赋值的位置全0:[1 2 3 4 5 0 0 0 0 0]

	// for循环写法
	for i := 0; i < len(myArray); i++ {
		fmt.Printf("myArray[%d]=%d", i, myArray[i])
	}
	fmt.Printf("\n")
	for index, value := range myArray1 {
		fmt.Printf("myArray[%d]=%d", index, value)
	}
	fmt.Printf("\n")
	// _ 用于表示匿名变量,不会被使用
	for _, value := range myArray1 {
		fmt.Printf("myArray1[%d]=%d", value, value)
	}
	fmt.Printf("\n")

	// 变长数组
	arr := make([]int, 10) // 默认全0
	fmt.Printf("arr=%v\n", arr)

	// 查看数组的数据类型
	fmt.Printf("myArray types = %T\n", myArray)   // 数据类型为[5]int
	fmt.Printf("myArray1 types = %T\n", myArray1) // 数据类型为[10]int\

	test1(myArray)
}
|
输出:
1
2
3
4
5
6
7
8
9
|
myArray = [0 0 0 0 0]
myArray1 = [1 2 3 4 5 0 0 0 0 0]
myArray[0]=0myArray[1]=0myArray[2]=0myArray[3]=0myArray[4]=0
myArray[0]=1myArray[1]=2myArray[2]=3myArray[3]=4myArray[4]=5myArray[5]=0myArray[6]=0myArray[7]=0myArray[8]=0myArray[9]=0
myArray1[1]=1myArray1[2]=2myArray1[3]=3myArray1[4]=4myArray1[5]=5myArray1[0]=0myArray1[0]=0myArray1[0]=0myArray1[0]=0myArray1[0]=0
arr=[0 0 0 0 0 0 0 0 0 0]
myArray types = [5]int
myArray1 types = [10]int
myArray = [0 0 0 0 0]
|
数组的复制
浅拷贝
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
|
    arr1 := []int{1, 2, 3, 4}
    fmt.Printf("arr1=%v\n", arr1)

    arr2 := arr1
    fmt.Printf("arr2=%v\n", arr2)

    arr1[0] = 999
    fmt.Printf("arr1=%v\n", arr1)
    fmt.Printf("arr2=%v\n", arr2)

    fmt.Printf("%p\n", arr1)
    fmt.Printf("%p\n", arr2)
|
输出:
1
2
3
4
5
6
|
arr1=[1 2 3 4]
arr2=[1 2 3 4]
arr1=[999 2 3 4]
arr2=[999 2 3 4]
0xc0000141e0
0xc0000141e0
|
深拷贝(copy)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
|
    arr1 := []int{1, 2, 3, 4}
    fmt.Printf("arr1=%v\n", arr1)

    arr2 := make([]int, 3)
    copy(arr2, arr1)
    fmt.Printf("arr2=%v\n", arr2)
    arr3 := make([]int, 10)
    copy(arr3, arr1)
    fmt.Printf("arr3=%v\n", arr3)

    arr1[0] = 999
    fmt.Printf("arr1=%v\n", arr1)
    fmt.Printf("arr2=%v\n", arr2)
    fmt.Printf("arr3=%v\n", arr3)

    fmt.Printf("%p\n", arr1)
    fmt.Printf("%p\n", arr2)
    fmt.Printf("%p\n", arr3)
|
输出:
1
2
3
4
5
6
7
8
9
|
arr1=[1 2 3 4]
arr2=[1 2 3]
arr3=[1 2 3 4 0 0 0 0 0 0]
arr1=[999 2 3 4]
arr2=[1 2 3]
arr3=[1 2 3 4 0 0 0 0 0 0]
0xc0000141e0
0xc000010150
0xc0000121e0
|
参数为数组的函数写法及修改的情况
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
|
func test1(arr1 []int) {
    arr1 = append(arr1, 10)    // 无法得到append后的数组
}
func test2(arr1 []int) []int {
    arr1 = append(arr1, 10)    // 通过返回值接收,可以得到append后的数组
    return arr1
}
func test3(arr1 []int) {
    arr1[0] = 1                   // 可以得到修改后的数组,因此是通过引用传递的参数
}
func main() {
    arr1 := make([]int, 6)

    test1(arr1)
    fmt.Printf("arr1 = %d\n", arr1)

    arr1 = test2(arr1)
    fmt.Printf("arr1 = %d\n", arr1)

    test3(arr1)
    fmt.Printf("arr1 = %d\n", arr1)
}
|
输出:
1
2
3
|
arr1 = [0 0 0 0 0 0]
arr1 = [0 0 0 0 0 0 10]
arr1 = [1 0 0 0 0 0 10]
|
切片slice的尺寸和容量,以及判空
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
|
func main() {
    slice1 := []int{1, 2, 3, 4, 5}
    fmt.Printf("slice1=%v, size=%d, cap=%d\n", slice1, len(slice1), cap(slice1))

    slice2 := make([]int, 4)
    fmt.Printf("slice2=%v, size=%d, cap=%d\n", slice2, len(slice2), cap(slice2)) // 默认状态下cap等于size

    slice3 := make([]int, 3, 5) // make(dataType,size,cap)
    fmt.Printf("slice3=%v, size=%d, cap=%d\n", slice3, len(slice3), cap(slice3)) // 指定状态下cap大于等于size

    slice1 = append(slice1, 9)
    fmt.Printf("slice1=%v, size=%d, cap=%d\n", slice1, len(slice1), cap(slice1)) // cap不足时,cap翻倍,与cpp的vector类似

    // 判断一个slice是否为0
    var slice []int
    if slice == nil {
       fmt.Printf("slice is nil\n")
    } else {
       fmt.Printf("slice is %v\n", slice)
    }
}
|
输出:
1
2
3
4
5
|
slice1=[1 2 3 4 5], size=5, cap=5
slice2=[0 0 0 0], size=4, cap=4
slice3=[0 0 0], size=3, cap=5
slice1=[1 2 3 4 5 9], size=6, cap=10
slice is nil
|
切片截取(设置上下限)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
|
func main() {
    slice1 := []int{1, 2, 3, 4, 5}

    fmt.Printf("slice1[0:3] = %d\n", slice1[0:3]) // 左闭右开的区间
    fmt.Printf("slice1[:3] = %d\n", slice1[:3])   // 左边不填默认为0
    fmt.Printf("slice1[1:] = %d\n", slice1[1:])   // 右边不填默认为len(slice)

    slice2 := slice1[0:3]
    fmt.Printf("slice2 = %d\n", slice2)
}
|
输出:
1
2
3
4
|
slice1[0:3] = [1 2 3]
slice1[:3] = [1 2 3]
slice1[1:] = [2 3 4 5]
slice2 = [1 2 3]
|
map的声明、赋值和遍历
第一种声明方式:先声明,再make
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
|
    // 声明myMap1是一种map类型,key是int,value是string
    var myMap1 map[int]string
    if myMap1 == nil {
       fmt.Printf("mymap1 is nil\n")
       myMap1 = make(map[int]string, 10)
    }

    myMap1[1] = "Beijing"
    myMap1[2] = "Shanghai"
    myMap1[3] = "Guangzhou"
    myMap1[4] = "Shenzhen"
    myMap1[5] = "Iceland"

    fmt.Println(myMap1)

    for k, v := range myMap1 {
       fmt.Println(k, v)
    }
|
输出:
1
2
3
4
5
6
7
|
mymap1 is nil
map[1:Beijing 2:Shanghai 3:Guangzhou 4:Shenzhen 5:Iceland]
3 Guangzhou
1 Beijing
2 Shanghai
4 Shenzhen
5 Iceland
|
第二种声明方式:直接make
1
2
3
4
5
6
7
8
|
    myMap2 := make(map[int]string)
    myMap2[1] = "Beijing"
    myMap2[2] = "Shanghai"
    myMap2[3] = "Guangzhou"
    myMap2[4] = "Shenzhen"
    myMap2[5] = "Iceland"

    fmt.Println(myMap2)
|
输出:
1
|
map[1:Beijing 2:Shanghai 3:Guangzhou 4:Shenzhen 5:Iceland]
|
第三种声明方式:声明、赋值同时进行
1
2
3
4
5
6
7
8
9
|
	myMap3 := map[int]string{
		1: "Beijing",
		2: "Shanghai",
		3: "Guangzhou",
		4: "Shenzhen",
		5: "Iceland",
	}

	fmt.Println(myMap3)
|
输出:
1
|
map[1:Beijing 2:Shanghai 3:Guangzhou 4:Shenzhen 5:Iceland]
|
map的增删改查
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
|
        myMap := map[int]string{
           1: "Beijing",
           2: "Shanghai",
           3: "Guangzhou",
           4: "Shenzhen",
           5: "Iceland",
        }
        fmt.Println(myMap)

        // 添加
        myMap[6] = "NewYork"
        fmt.Println(myMap)

        // 删除
        delete(myMap, 3)
        fmt.Println(myMap)

        // 修改
        myMap[2] = "Tokyo"
        fmt.Println(myMap)

        // 遍历
        for key, value := range myMap {
           fmt.Println(key, value)
        }
|
输出
1
2
3
4
5
6
7
8
9
|
map[1:Beijing 2:Shanghai 3:Guangzhou 4:Shenzhen 5:Iceland]
map[1:Beijing 2:Shanghai 3:Guangzhou 4:Shenzhen 5:Iceland 6:NewYork]
map[1:Beijing 2:Shanghai 4:Shenzhen 5:Iceland 6:NewYork]
map[1:Beijing 2:Tokyo 4:Shenzhen 5:Iceland 6:NewYork]
4 Shenzhen
5 Iceland
6 NewYork
1 Beijing
2 Tokyo
|
第三部分
struct基本定义与使用
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
|
// 声明一种新的数据类型
type myInt int

// 定义一个结构体
type Book struct {
    title  string
    author string
}

func main() {
    var a myInt = 66
    fmt.Println(a)

    var book1 Book
    book1.title = "Go Programming Language"
    book1.author = "www.golang.com"
    fmt.Printf("%v\n", book1)
    fmt.Printf("book1.title:%s, book1.author:%s\n", book1.title, book1.author)
}
|
输出
1
2
3
|
66
{Go Programming Language www.golang.com}
book1.title:Go Programming Language, book1.author:www.golang.com
|
类的表示与封装
值得注意的是,Go与cpp不同,cpp是显式定义类的成员类型(public、private),而Go是通过首字母是否大写来表示是否是public。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
|
// 如果类名首字母大写,表示其他包也能够访问
type Hero struct {
    // 如果说类的属性首字母大写,表示该属性是对外能够访问的(public),否则只能在类的内部使用(private)
    Name  string
    Ad    int
    Level int
}

// hero Hero表示当前函数绑定在调用这个函数的Hero对象中,其实也就是一个参数,所以最好传指针进去
// 相当于cpp中类里的成员函数
func (hero *Hero) GetName() string {
    fmt.Println("Name:", hero.Name)
    return hero.Name
}

func (hero *Hero) Show() {
    fmt.Println("Hero:", hero.Name)
    fmt.Println("Ad:", hero.Ad)
    fmt.Println("Level:", hero.Level)
}

//  func (hero Hero) SetName(newName string) {
//     //hero 是调用该方法的对象的一个副本(浅拷贝)
//     hero.Name = newName
//  }

// 最好是使用hero *Hero来绑定
func (hero *Hero) SetName(newName string) {
    //this 是调用该方法的对象的一个副本(浅拷贝)
    hero.Name = newName
}

func main() {
    // 创建一个对象
    hero := Hero{Name: "Spider-Man", Ad: 5, Level: 1}

    hero.Show()

    fmt.Println(hero.GetName())
    hero.SetName("wxz")
    fmt.Println(hero.GetName())
}
|
输出
1
2
3
4
5
6
7
|
Hero: Spider-Man
Ad: 5
Level: 1
Name: Spider-Man
Spider-Man
Name: wxz
wxz
|
继承的语法
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
|
type Human struct {
    name string
    sex  string
}

func (h *Human) Eat() {
    fmt.Printf("Human.Eat()...\n")
}

func (h *Human) Walk() {
    fmt.Printf("Human.Walk()...\n")
}

// ================================
// 子类
type Superman struct {
    Human // Superman类继承了Human类的属性和方法
    level int
}

// 重写父类的方法
func (s *Superman) Walk() {
    fmt.Printf("Superman.Walk()...\n")
}

//func (s *Superman) Eat() {
//  fmt.Printf("Superman.Eat()...\n")
//}

func (s *Superman) Show() {
    fmt.Println(s.name)
    fmt.Println(s.sex)
    fmt.Println(s.level)
}

func main() {
    h := Human{"zhang3", "male"}
    h.Eat()
    h.Walk()

    //s := Superman{Human{"lisi", "male"}, 5}
    var s Superman
    s.name = "lisi"
    s.sex = "male"
    s.level = 5

    s.Show() // 子类的方法
    s.Eat()  // 父类的方法
    s.Walk() // 子类的方法
}
|
输出
1
2
3
4
5
6
7
|
Human.Eat()...
Human.Walk()...
lisi
male
5
Human.Eat()...
Superman.Walk()...
|
面向对象多态的实现与基本要素
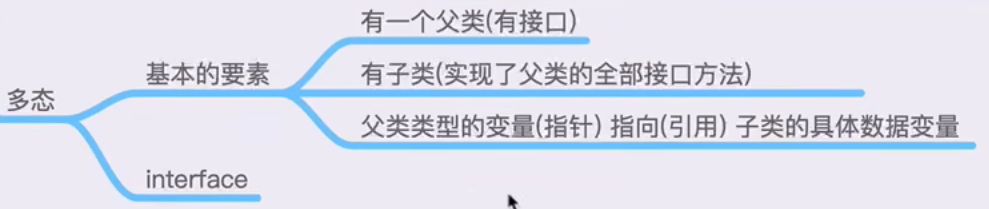 先定义一下接口和具体的类,接口的本质是一个指针。
1
2
3
4
5
|
type Animal interface {
    Sleep()
    GetColor() string
    GetType() string
}
|
具体的类必须要重写接口中所有的方法,如果没有重写完全的话,接口的指针就无法指向具体的类。
cat类:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
|
type Cat struct {
    Color string
}

func (cat *Cat) Sleep() {
    fmt.Printf("Cat is sleeping...\n")
}
func (cat *Cat) GetColor() string {
    return cat.Color
}
func (cat *Cat) GetType() string {
    return "Cat"
}
|
dog类:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
|
type Dog struct {
    Color string
}

func (dog *Dog) Sleep() {
    fmt.Printf("Dog is sleeping...\n")
}
func (dog *Dog) GetColor() string {
    return dog.Color
}
func (dog *Dog) GetType() string {
    return "Dog"
}
|
具体用法
1
2
3
4
5
6
7
8
9
|
func main() {
    // 父类对象指针指向子类指针,调用的方法是子类的方法
    var animal Animal
    animal = &Cat{"red"}
    animal.Sleep()

    animal = &Dog{"yellow"}
    animal.Sleep()
}
|
输出:
1
2
|
Cat is sleeping...
Dog is sleeping...
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
|
// 注意,这边的Animal接口类本质是一个指针,所有传参时应该穿指针进去
func ShowAnimal(animal Animal) {
    animal.Sleep()
    fmt.Println(animal.GetColor())
    fmt.Println(animal.GetType())
}

func main() {
    // 可以定义具体的类然后取地址
    cat := Cat{"red"}
    dog := Dog{"yellow"}
    ShowAnimal(&cat)
    fmt.Printf("==============\n")
    ShowAnimal(&dog)
    fmt.Printf("==============\n")

    // 也可以直接定义类的指针然后传指针
    catP := &Cat{"red"}
    dogP := &Dog{"yellow"}
    ShowAnimal(catP)
    fmt.Printf("==============\n")
    ShowAnimal(dogP)
}
|
输出:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
|
Cat is sleeping...
red
Cat
==============
Dog is sleeping...
yellow
Dog
==============
Cat is sleeping...
red
Cat
==============
Dog is sleeping...
yellow
Dog
|
interface空接口万能类型与类型断言机制
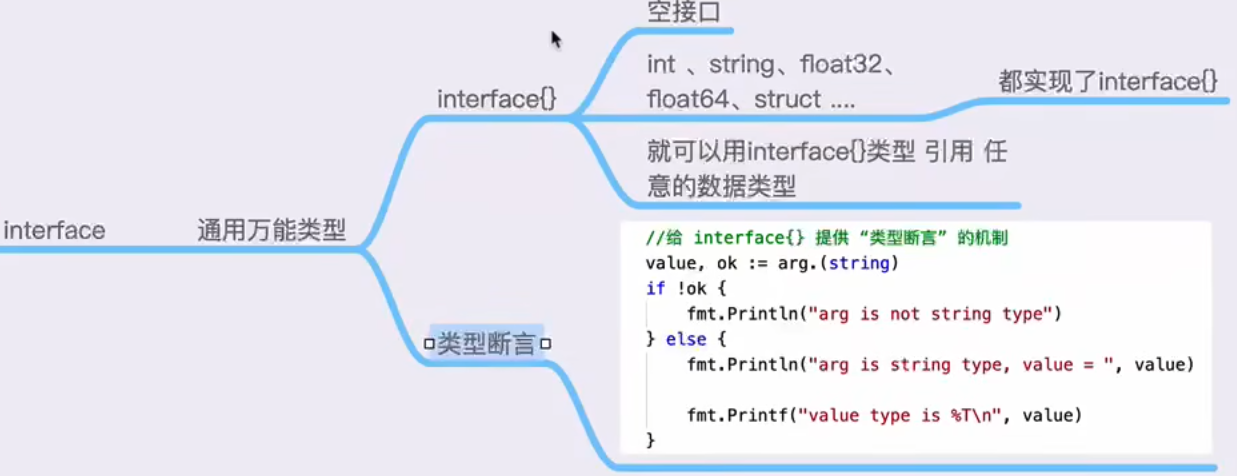
interface空接口
interface{}是万能数据类型
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
|
// interface{}是万能数据类型
func myFunc(arg interface{}) {
	fmt.Println("myFunc is called...")
	fmt.Println(arg)
	fmt.Println("type of arg: ", reflect.TypeOf(arg))
	// 或者是
	// fmt.Printf("type of d: %T\n", arg)
}
func main() {
	myFunc(1)
	myFunc("Hello World")
	myFunc(true)
}
|
输出:
1
2
3
4
5
6
7
8
9
|
myFunc is called...
1
type of arg:  int
myFunc is called...
Hello World
type of arg:  string
myFunc is called...
true
type of arg:  bool
|
类型断言机制
interface{}提供“类型断言”的机制,用于区分此时引用的底层数据类型到底是什么
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
|
// interface{}是万能数据类型
func myFunc(arg interface{}) {
	value, ok := arg.(int)
	if !ok {
		fmt.Println("arg is not int type")
	} else {
		fmt.Println("arg is int type, value is: ", value)
	}
}

func main() {
	myFunc(1)
	myFunc("Hello World")
	myFunc(true)
}
|
输出:
1
2
3
|
arg is int type, value is:  1
arg is not int type
arg is not int type
|
变量内置的pair结构详细说明
在 Go 中,一个接口变量(interface variable)在运行时内部可以看作是一个pair:(Type, Value)
- Type(动态类型):这是接口实际持有的具体类型(例如 *Book)。
- Value (动态值):这是持有具体数据的指针或值的副本。
- 定义接口与结构体
1
2
3
4
5
6
7
8
|
type Reader interface { ReadBook() }
type Writer interface { WriteBook() }
type Book struct {}

// *Book 实现了 Reader 接口
func (b *Book) ReadBook() { fmt.Println("Read a book.") }
// *Book 实现了 Writer 接口
func (b *Book) WriteBook() { fmt.Println("Write a book.") }
|
这里 *Book(Book 的指针类型)同时实现了 Reader 和 Writer 两个接口的全部方法。这意味着 *Book 类型的变量既可以赋值给 Reader,也可以赋值给 Writer。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
|
func main() {
	// b: pair<type:Book, value:book{}地址>
	b := &Book{"To Live"}

	// r: pair<type: , value: >
	var r Reader
	fmt.Println(reflect.TypeOf(r), r)
	// r: pair<type:Book, value:book{}地址>
	r = b
	fmt.Println(reflect.TypeOf(r), r)
	r.ReadBook()

	// w: pair<type: , value: >
	var w Writer
	fmt.Println(reflect.TypeOf(w), w)
	// w: pair<type:Book, value:book{}地址>
	w = r.(Writer)
	fmt.Println(reflect.TypeOf(w), w)
	w.WriteBook()
}
|
输出:
1
2
3
4
5
6
|
<nil> <nil>
*main.Book &{To Live}
Read a book.
<nil> <nil>
*main.Book &{To Live}
Write a book.
|
从上面的输出可以看出,接口类在未赋值时的pair为(nil,nil)。我们可以把 r 和 w 想象成两个不同的“窗口”,它们看着同一个“房间”(具体的 Book 对象):
b (具体指针):
r (Reader 接口):
- 动态类型: *Book
- 动态值: 指向 b
- 能力: 只能看见 ReadBook()
w (Writer 接口):
- (通过 r.(Writer) 转换而来)
- 动态类型: *Book (和 r 一样!)
- 动态值: 指向 b (和 r 一样!)
- 能力: 只能看见 WriteBook()
反射reflect机制用法
- 反射基本类型
- reflect.TypeOf() 用于获取变量的类型
- reflect.ValueOf() 用于获取变量的值
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
|
// interface{}作为万能类型,类似模板
func reflectNum(arg interface{}) {
	fmt.Println("type : ", reflect.TypeOf(arg))
	fmt.Println("value : ", reflect.ValueOf(arg))
}
func main() {
	var num float64 = 3.1415926

	reflectNum(num)
}
|
输出:
1
2
|
type :  float64
value :  3.1415926
|
- 反射复杂类型
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
|
type User struct {
	Id   int
	Name string
	Age  int
}

func (u *User) Call() {
	fmt.Println("user is called ..")
	fmt.Printf("%v\n", u)
}
func (u User) Display() {
	fmt.Println("user is displayed ..")
	fmt.Printf("%v\n", u)
}

func DoFiledAndMethod(input interface{}) {
	//获取input的type
	inputType := reflect.TypeOf(input)
	fmt.Println("inputType : ", inputType)

	//获取input的value
	inputValue := reflect.ValueOf(input)
	fmt.Println("inputValue : ", inputValue)

	//通过type获取里面的字段
	//1. 获取interface的reflect.Type,通过Type得到NumField,进行遍历
	//2. 得到每个field,数据类型
	//3. 通过field有一个Interface()方法得到对应的value
	for i := 0; i < inputType.NumField(); i++ {
		field := inputType.Field(i)
		value := inputValue.Field(i).Interface()

		// 变量名 变量类型:变量的值
		fmt.Printf("%s %s: %v\n", field.Name, field.Type, value)
	}

	//通过type获取里面的方法,调用
	fmt.Println(inputType.NumMethod())
 	// 这里得到的是1,因为Call方法是绑定在*User类型上的,而本方法中reflect.TypeOf()传的是User类型,所以不会计算Call方法

 	for i := 0; i < inputType.NumMethod(); i++ {
		method := inputType.Method(i)
		fmt.Printf("%s %s: %v\n", method.Name, method.Type, method.Func)
	}

}
func main() {
	user := User{1, "wxz", 22}

	DoFiledAndMethod(user)
}
|
输出:
1
2
3
4
5
6
7
|
inputType :  main.User
inputValue :  {1 wxz 22}
Id int: 1
Name string: wxz
Age int: 22
1
Display func(main.User): 0x7ff7b08a24e0
|
结构体标签
相当于注释
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
|
type Resume struct {
	Name string `info:"name" doc:"我的名字"`
	Sex  string `info:"sex"`
}

func findTag(str interface{}) {
	//t := reflect.TypeOf(str).Elem() // Elem()表示当前结构体的所有元素,其作用是获取指针指向的元素,或者容器(如 Map、Slice、Array、Chan)里的元素类型。
	t := reflect.TypeOf(str)

	for i := 0; i < t.NumField(); i++ {
		taginfo := t.Field(i).Tag.Get("info")
		tagdoc := t.Field(i).Tag.Get("doc")
		fmt.Println("info:", taginfo, " doc:", tagdoc)
	}
}
func main() {
	var re Resume
	re = Resume{"wxz", "male"}

	findTag(re)
}
|
输出:
1
2
|
info: name  doc: 我的名字
info: sex  doc:
|
结构体标签在json中的应用
前置准备(导包,创建结构体):
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
import (
	"encoding/json"
	"fmt"
)

type Movie struct {
	Title  string   `json:"title"`
	Year   int      `json:"year"`
	Price  int      `json:"rmb"`
	Actors []string `json:"actors"`
}
|
- 编码的过程 结构体—> json
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
|
movie := Movie{"喜剧之王", 2000, 10, []string{"xingye", "zhangbozhi"}}

	// 编码的过程  结构体---> json
	jsonStr, err := json.Marshal(movie)

	if err != nil {
		fmt.Println("json marshal error:", err)
		return
	}

	// 这边输出的字段的名称就是上面在结构体中写的标签
	fmt.Println("jsonStr =", string(jsonStr))
	// 或者 fmt.Printf("jsonStr = %s\n", string(jsonStr))
|
输出如下,可以复制到json在线解析的网站中验证:
1
|
jsonStr = {"title":"喜剧之王","year":2000,"rmb":10,"actors":["xingye","zhangbozhi"]}
|
- 解码的过程 jsonstr—> 结构体
1
2
3
4
5
6
7
8
9
|
	//jsonStr = {"title":"喜剧之王","year":2000,"rmb":10,"actors":["xingye","zhangbozhi"]}
	my_movie := Movie{}
	err = json.Unmarshal(jsonStr, &my_movie)
	if err != nil {
		fmt.Println("json unmarshal error:", err)
		return
	}
	fmt.Printf("%#v\n", my_movie)
	fmt.Printf("%v\n", my_movie)
|
输出:
1
2
|
main.Movie{Title:"喜剧之王", Year:2000, Price:10, Actors:[]string{"xingye", "zhangbozhi"}}
{喜剧之王 2000 10 [xingye zhangbozhi]}
|
第四部分
goroutine基本模型和调度设计策略
在go中把协程co-routine做了一些修改,包括内存占用和名字(goroutine)。
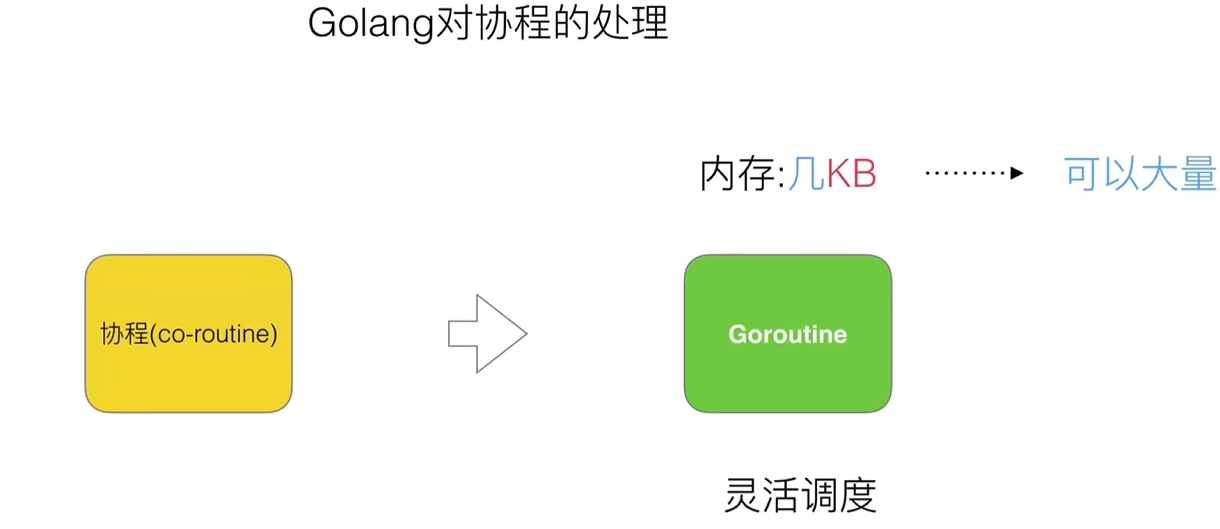
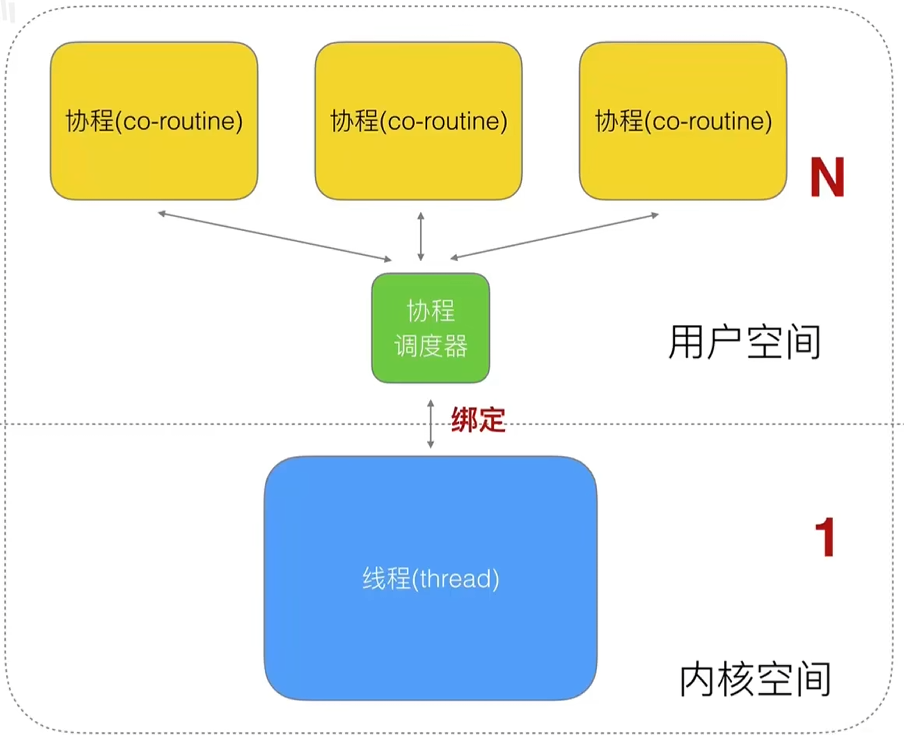
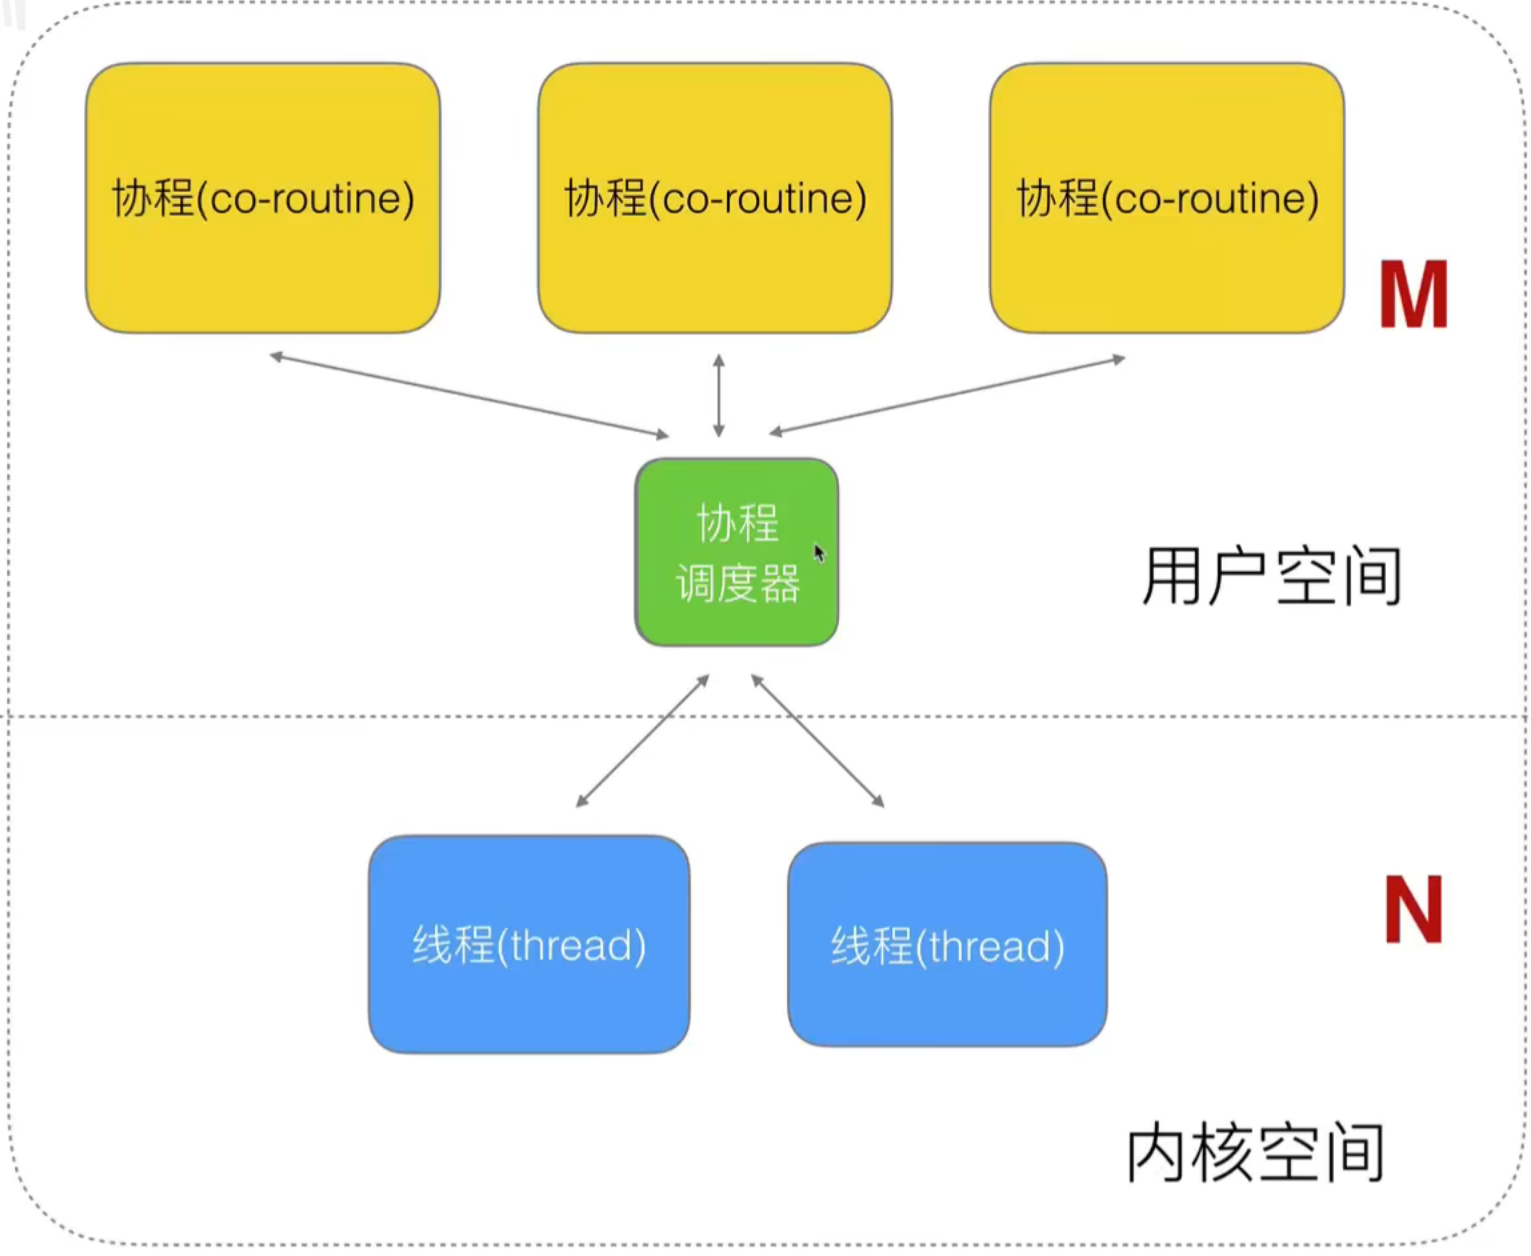
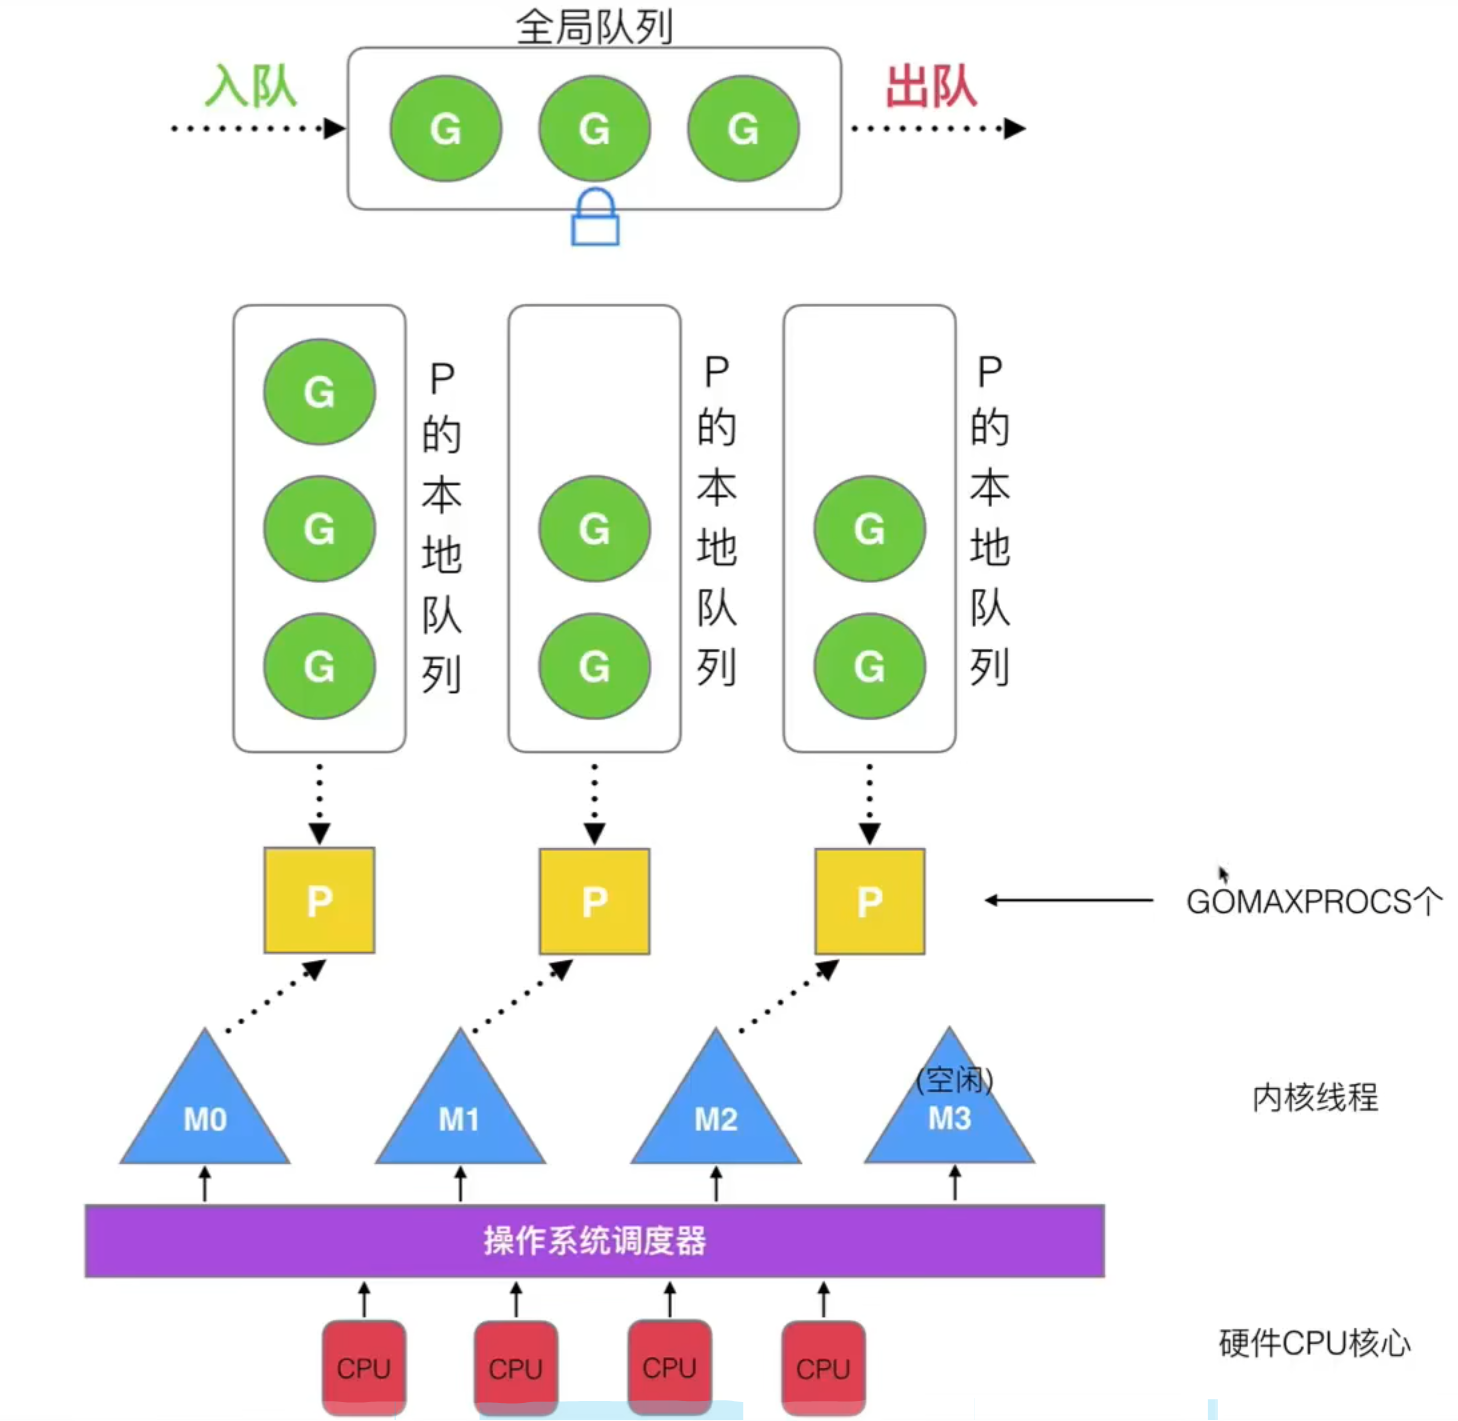
最大支持GOMAXPROCS个goroutine并行
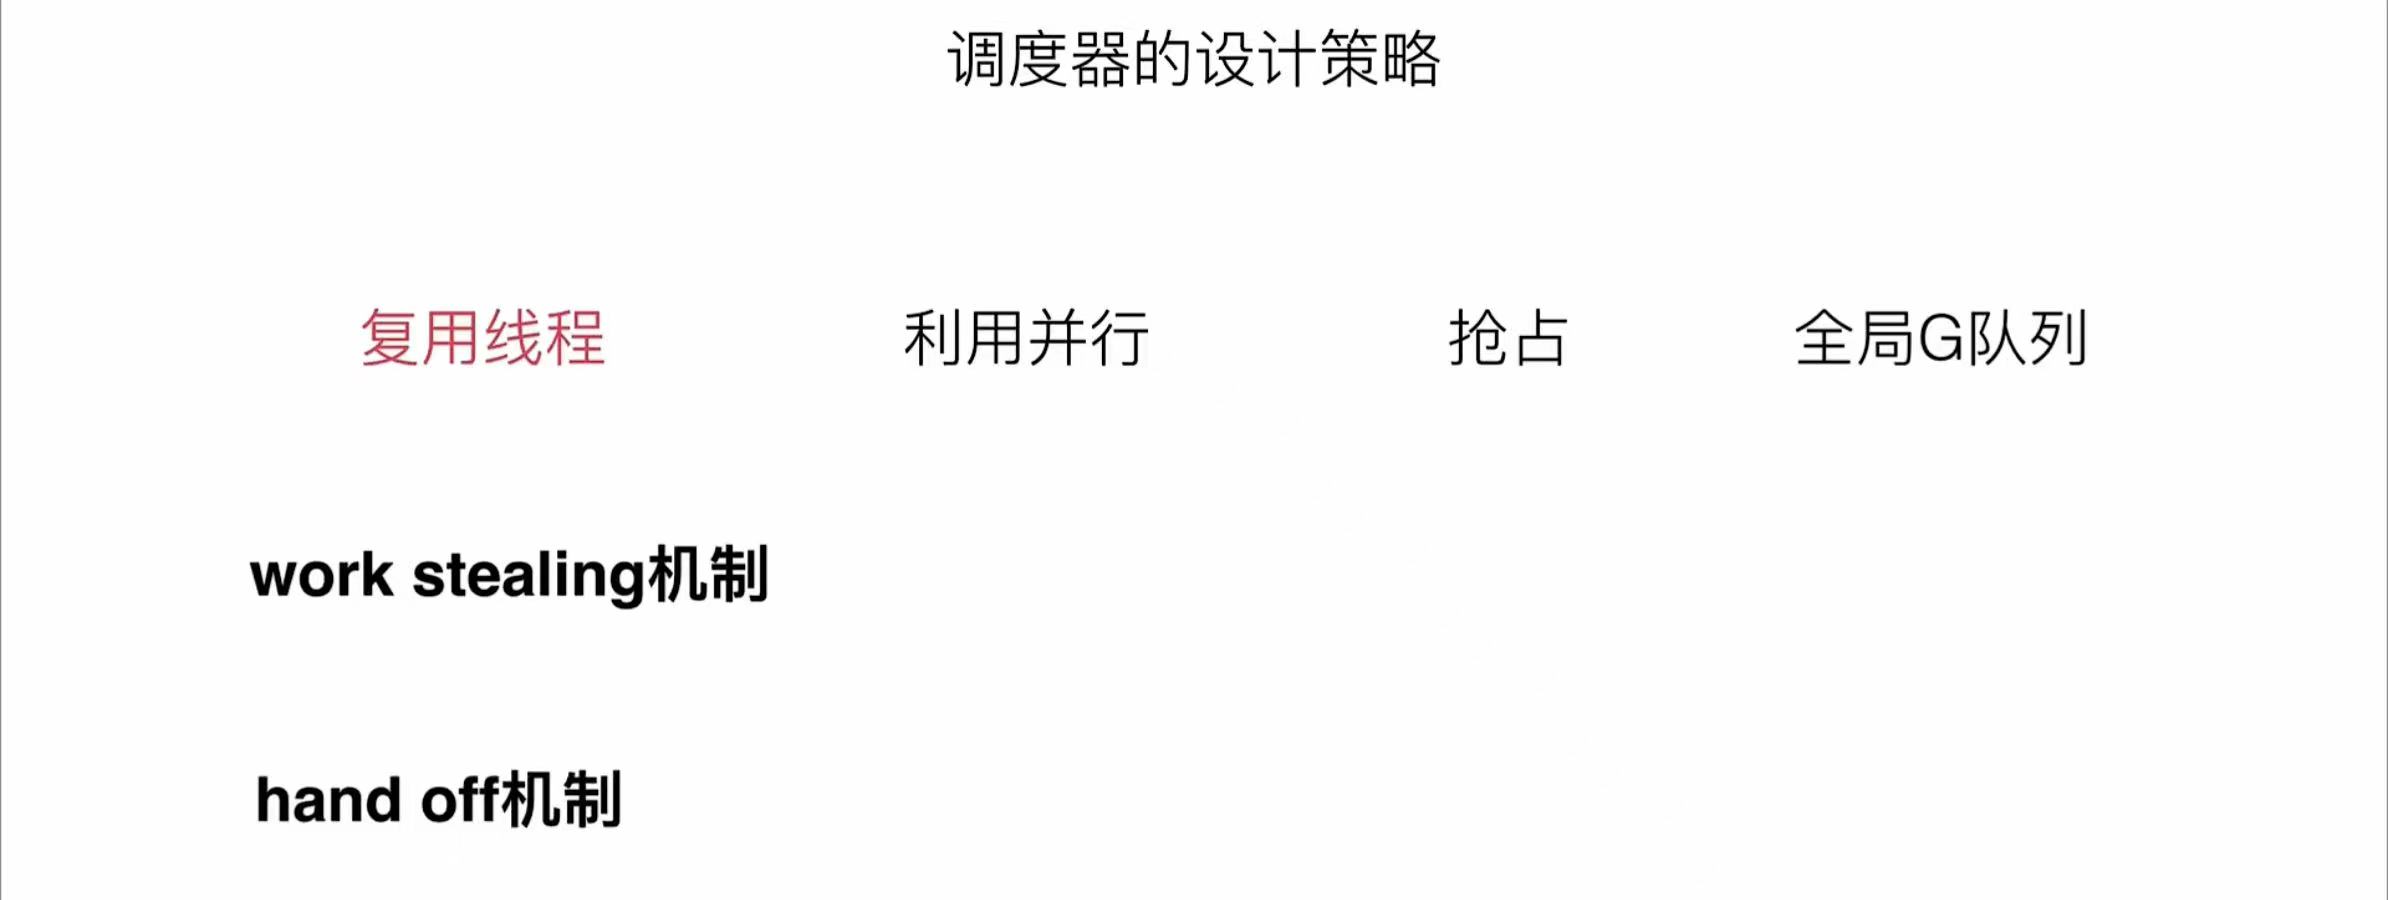
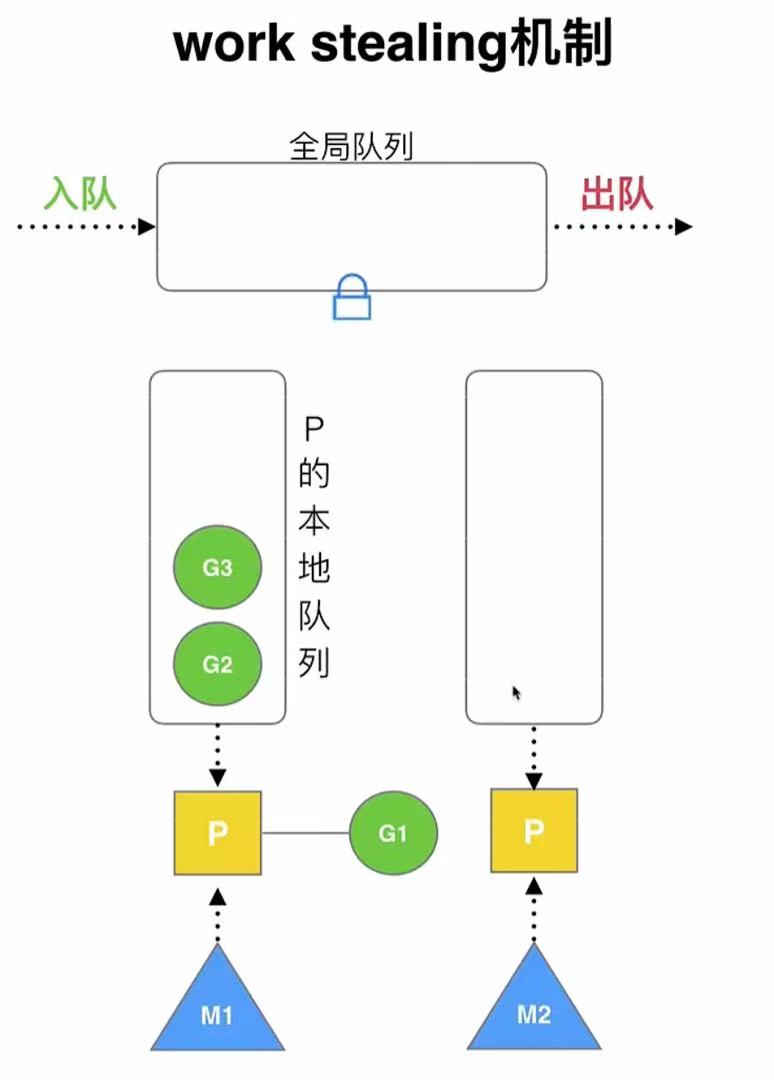
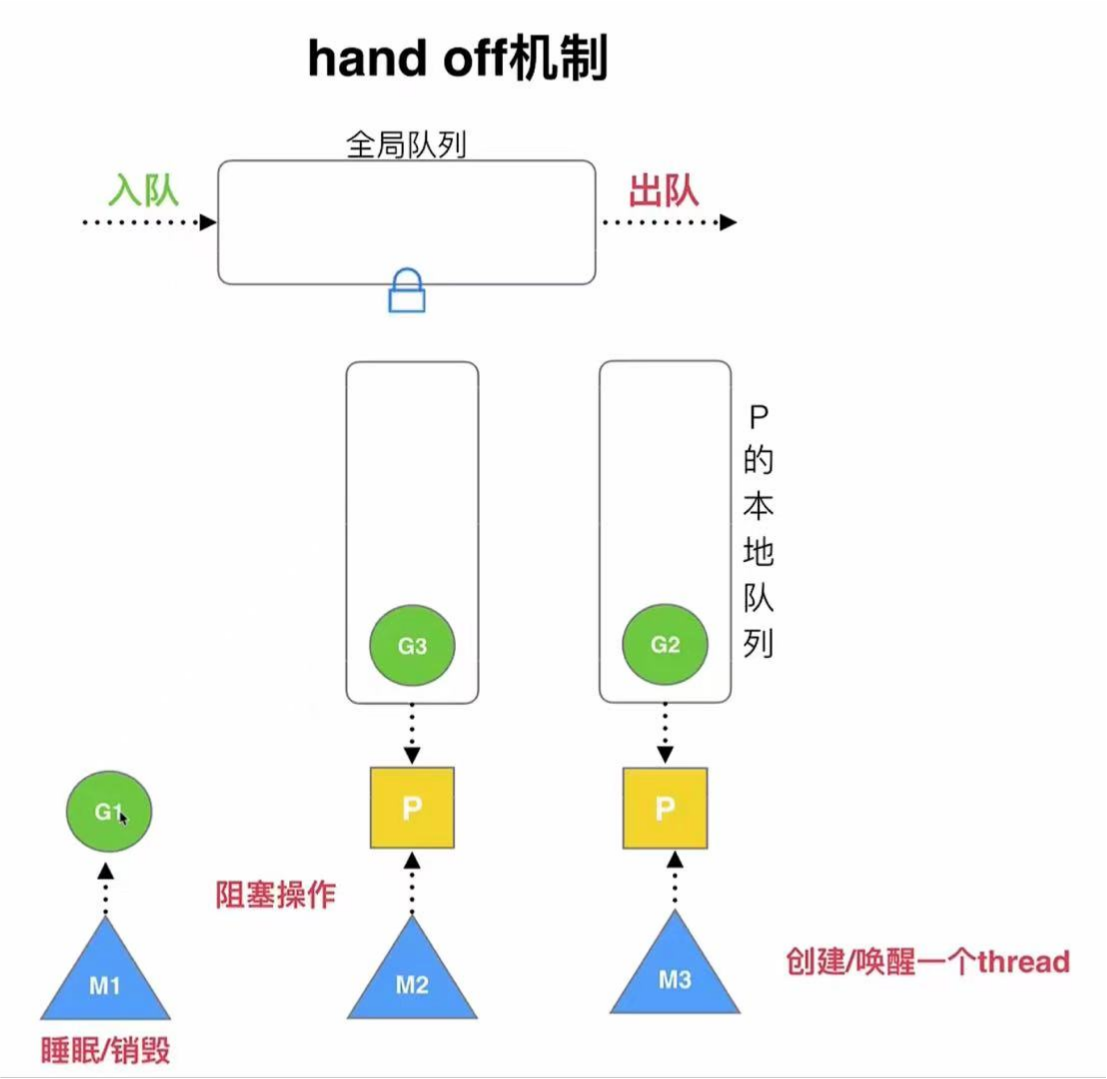
创建goroutine
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
|
// 子goroutine
func newTask() {
	i := 0
	for { // 死循环
		i++
		fmt.Printf("new Goroutine : i = %d\n", i)
		time.Sleep(1 * time.Second)
	}
}

// 主goroutine
func main() {
	// go关键字:创建一个go程,去执行newTask() 流程
	go newTask()

	i := 0
	for { // 死循环
		i++
		fmt.Printf("main Goroutine : i = %d\n", i)
		time.Sleep(1 * time.Second)
	}
}
|
输出:
1
2
3
4
5
6
7
8
|
main Goroutine : i = 1
new Goroutine : i = 1
new Goroutine : i = 2
main Goroutine : i = 2
new Goroutine : i = 3
main Goroutine : i = 3
...
...
|
也可以用匿名函数创建goroutine
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
|
// 主goroutine
func main() {

	// 用go创建承载一个形参为空,返回值为空的一个函数
	go func() {
		defer fmt.Println("A.defer")

		func() {
			defer fmt.Println("B.defer")
			// 退出当前goroutine
			runtime.Goexit()
			fmt.Println("B")
		}()

		fmt.Println("A")
		//// 退出当前goroutine
		//runtime.Goexit()

	}() // 最后这对括号用于传参

	go func(a int, b int) bool {
		fmt.Println("a = ", a, "b = ", b)
		return true
	}(10, 20)

	for {
		time.Sleep(1 * time.Second)
	}
}
|
输出:
1
2
3
4
5
|
B
B.defer
A
A.defer
a =  10 b =  20
|
其中,下面这条语句用于退出当前goroutine
channel的基本定义和使用
无缓冲channel
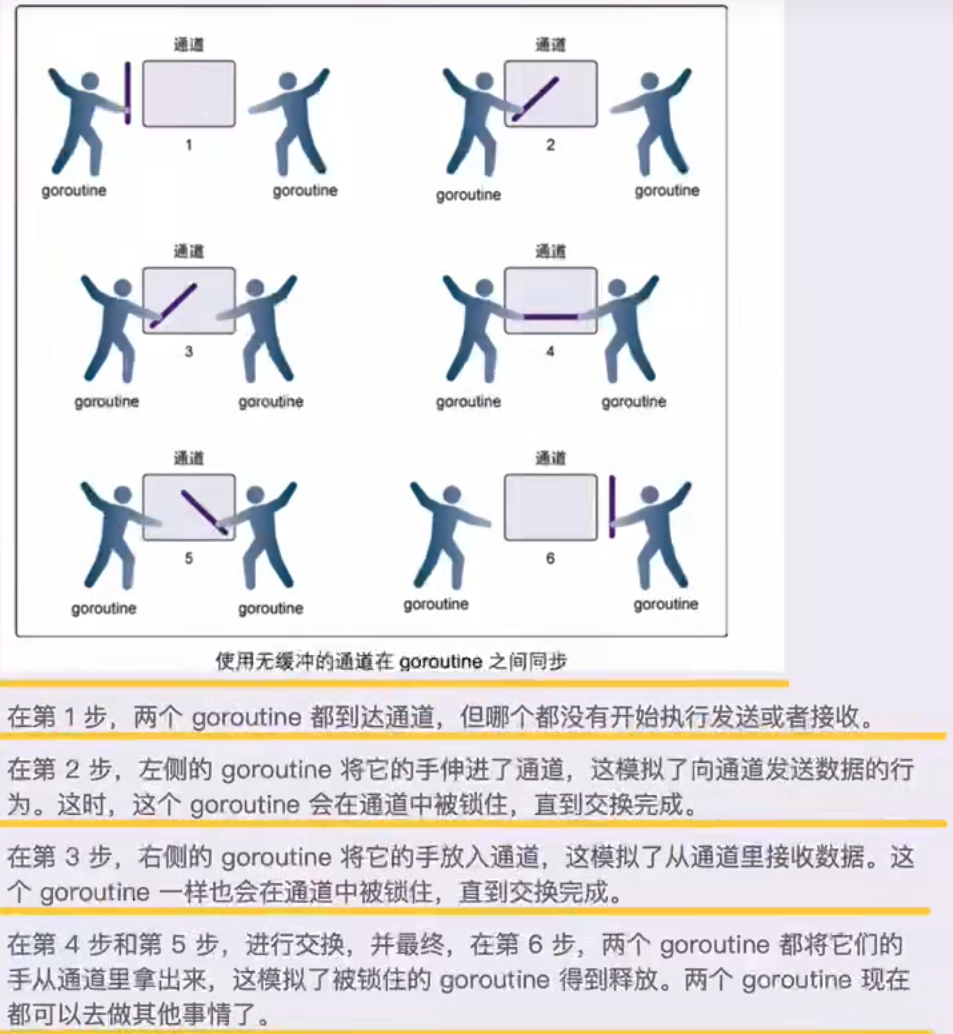
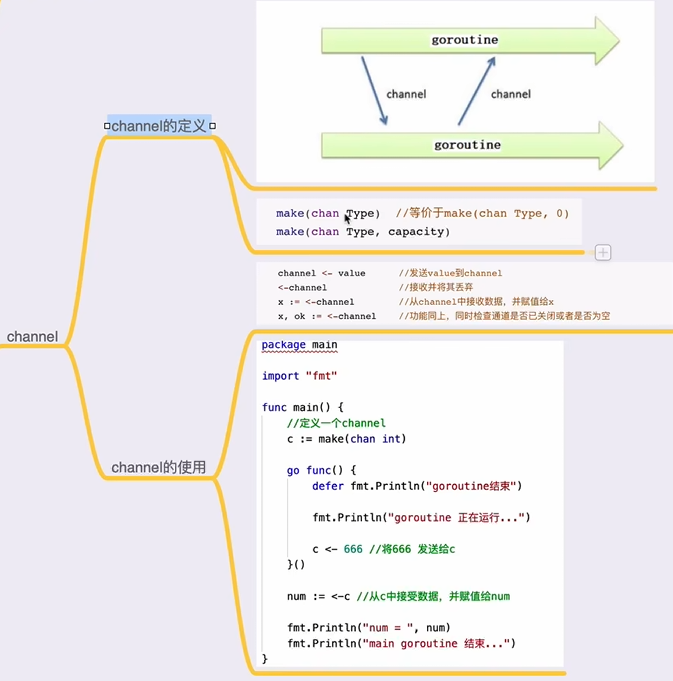
无缓冲的channel若只有写没有读,则写go程会阻塞;如果只有读没有写,则读go程会阻塞。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
|
	// 定义一个无缓冲区的channel,channel就是一个数据结构,且能够保证goroutine间的同步和互斥
	c := make(chan int)

	go func() {
		defer fmt.Println("goroutine结束")

		fmt.Println("goroutine 正在运行...")

		c <- 666 // 将666发送给c
	}()

	num := <-c // 从c中接收数据,并赋值给num

	fmt.Println("num =", num)
	fmt.Println("main goroutine 结束...")
|
输出:
1
2
3
4
|
goroutine 正在运行...
goroutine结束
num = 666
main goroutine 结束...
|
有缓冲channel
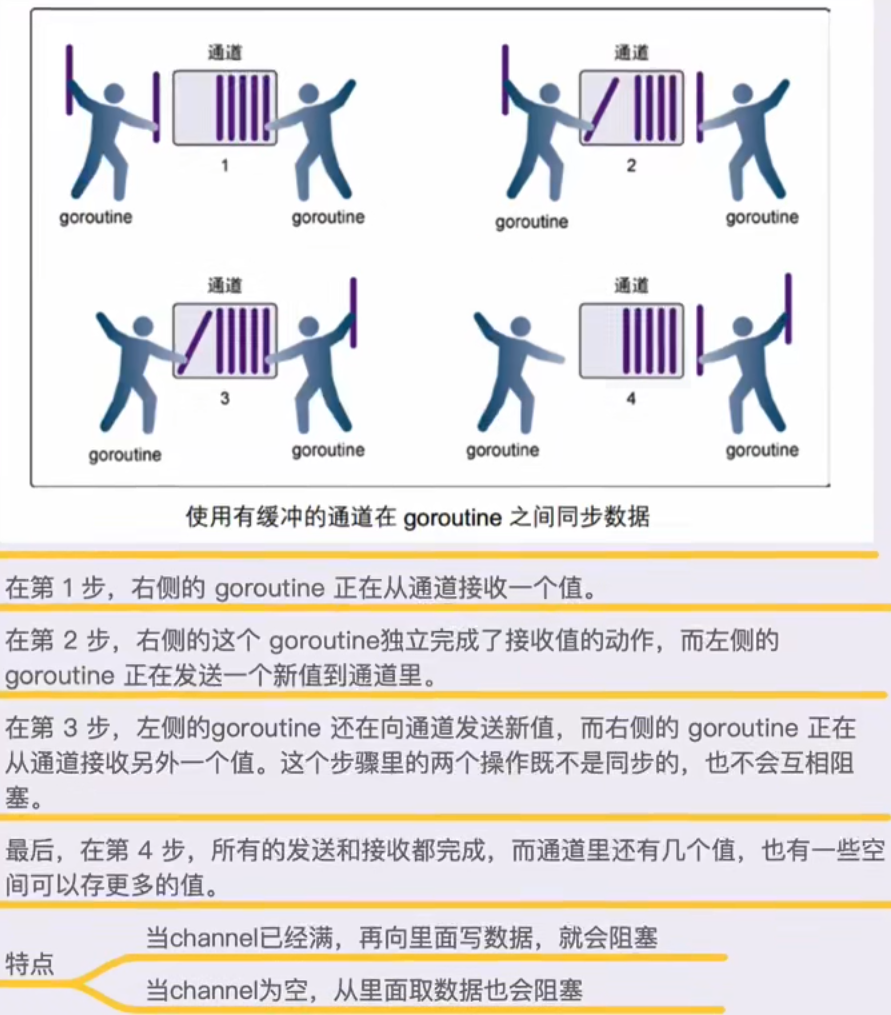
有缓冲的channel只有当缓冲区满且还在写入时,写go程才会阻塞;只有当缓冲区空且还在读取时,读go程才会阻塞。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
|
c := make(chan int, 3) // 带有3个缓冲区的channel

	fmt.Println("len(c) =", len(c), "cap(c) =", cap(c))

	go func() {
		defer fmt.Println("子go程结束")

		for i := 0; i < 4; i++ {
			c <- i
			fmt.Println("子go程正在运行,发送的元素 =", i, " len(c) =", len(c), ", cap(c) =", cap(c))
		}
	}()

	time.Sleep(2 * time.Second)

	for i := 0; i < 4; i++ {
		num := <-c // 从c中接收数据,并赋值给num
		fmt.Println("num =", num)
	}

	fmt.Println("main 结束")
|
- 当channel满,若继续写数据,则会阻塞。
- 当channel空,若继续读数据,也会阻塞。
输出:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
len(c) = 0 cap(c) = 3
子go程正在运行,发送的元素 = 0  len(c) = 1 , cap(c) = 3
子go程正在运行,发送的元素 = 1  len(c) = 2 , cap(c) = 3
子go程正在运行,发送的元素 = 2  len(c) = 3 , cap(c) = 3
num = 0
num = 1
num = 2
num = 3
main 结束
子go程正在运行,发送的元素 = 3  len(c) = 2 , cap(c) = 3
子go程结束
|
channel的关闭特点
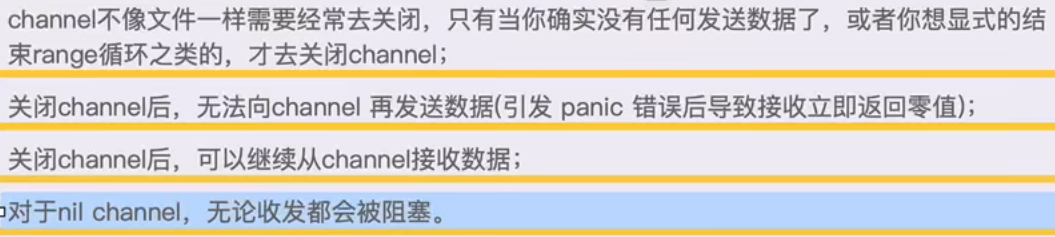 close关键字可以关闭一个channel,channel关闭后只能读不能写,且向未make的channel(nil channel)收发数据都会被阻塞
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
|
	c := make(chan int)

	go func() {
		for i := 0; i < 5; i++ {
			c <- i
		}

		// close关键字可以关闭一个channel,channel关闭后只能读不能写,且向未make的channel(nil channel)收发数据都会被阻塞
		close(c)
	}()

	for {
		// ok 如果为true表示channel没有关闭,如果为false表示channel已经关闭
		if data, ok := <-c; ok { // if的条件是 ok
			fmt.Println(data)
		} else {
			break
		}
	}

	fmt.Println("Main finished...")
|
输出:
1
2
3
4
5
6
|
0
1
2
3
4
Main finished...
|
channel与range
类似C++中的for(auto i:arr)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
|
	c := make(chan int)

	go func() {
		for i := 0; i < 5; i++ {
			c <- i
		}

		// close关键字可以关闭一个channel,channel关闭后只能读不能写,且向未make的channel(nil channel)收发数据都会被阻塞
		close(c)
	}()

	/*
	for {
		// ok 如果为true表示channel没有关闭,如果为false表示channel已经关闭
		if data, ok := <-c; ok { // if的条件是 ok
			fmt.Println(data)
		} else {
			break
		}
	}
	*/
    // 上面这段代码可以替换为下面这段代码

	// 可以使用range来迭代不断操作channel
	for data := range c {
		fmt.Println(data)
	}

	fmt.Println("Main finished...")
|
输出相同:
1
2
3
4
5
6
|
0
1
2
3
4
Main finished...
|
channel与select
单流程下的一个go只能监控一个channel的状态,通过select可以监控多个channel的状态
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
|
func fibonacci(c chan int, quit chan int) {
	x, y := 1, 1

	for {
		select {
		case c <- x: // 如果c可写,则此case就会进来
			x, y = y, x+y
		case <-quit: // 如果quit可读,则此case就会进来
			fmt.Println("quit")
			return
		}
	}
}

func main() {
	c := make(chan int)
	quit := make(chan int)

	// sub go
	go func() {
		for i := 0; i < 6; i++ {
			fmt.Println(<-c)
		}

		quit <- 0
	}()

	// main go,channel传参传的都是引用
	fibonacci(c, quit)
}
|
输出:
1
2
3
4
5
6
7
|
1
1
2
3
5
8
quit
|
第五部分
什么是Go Modules?
Go modules是Go语言的依赖解决方案,发布于Go1.11,成长于Go1.12,丰富于Go1.13,正式于Go1.14,推荐在生产上使用。
Go modules目前集成在Go的工具链中,只要安装了Go,自然而然也就可以使用Go modules了,而Go modules的出现也解决了在Go1.11前的几个常见争议问题:
- Go语言长久以来的依赖管理问题。
- “淘汰”现有的GOPATH的使用模式。
- 同意社区中的其他的依赖管理工具(提供迁移功能)。
GOPATH的弊端
在 GOPATH 的 $GOPATH/src 下进行 .go 文件或源代码的存储,我们可以称其为 GOPATH 的模式,这个模式拥有一些弊端。
- A. 无版本控制概念。 在执行go get的时候,你无法传达任何的版本信息的期望,也就是说你也无法知道自己当前更新的是哪一个版本,也无法通过指定来拉取自己所期望的具体版本。
- B.无法同步一致第三方版本号。 在运行 Go 应用程序的时候,你无法保证其它人与你所期望依赖的第三方库是相同的版本,也就是说在项目依赖库的管理上,你无法保证所有人的依赖版本都一致。
- C.无法指定当前项目引用的第三方版本号。 没办法处理 v1、v2、v3 等等不同版本的引用问题,因为 GOPATH 模式下的导入路径都是一样的,都是github.com/foo/bar。
Go Modules模式
-
go mod命令
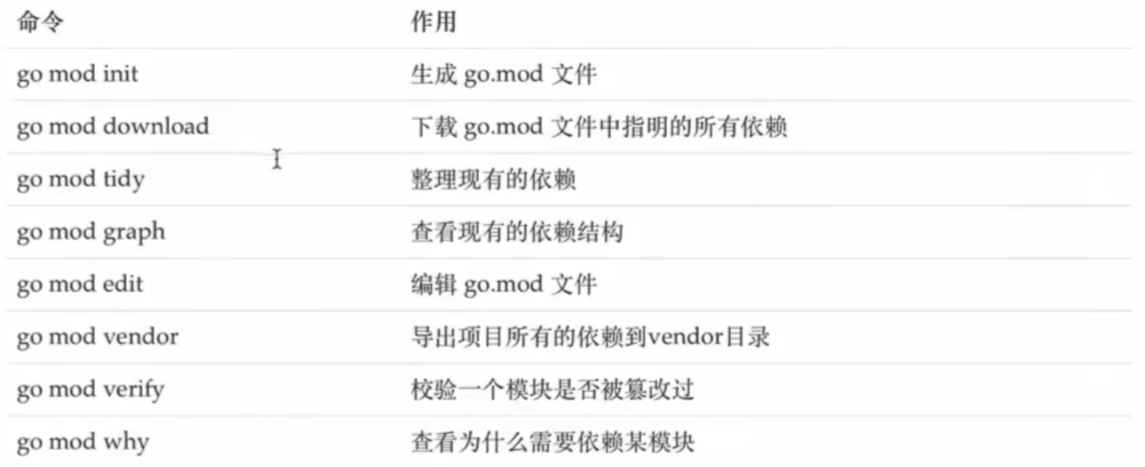
-
go mod环境变量
可以通过 go env 命令来进行查看
GO111MODULE
GO111MODULE
Go语言提供了 GO111MODULE这个环境变量来作为 Go modules 的开关,其允许设置以下参数:
- auto:只要项目包含了 go.mod 文件的话启用 Go modules,目前在 Go1.11 至 Go1.14 中仍然是默认值。
- on:启用 Go modules,推荐设置,将会是未来版本中的默认值。
- off:禁用 Go modules,不推荐设置。
可以在终端执行:go env -w GO111MODULE=on 来设置。
GOPROXY
这个环境变量主要是用于设置 Go 模块代理(Go module proxy),其作用是用于使 Go 在后续拉取模块版本时直接通过镜像站点来快速拉取。
GOPROXY 的默认值是:https://proxy.golang.org,direct
实际上 “direct” 是一个特殊指示符,用于指示 Go 回源到模块版本的源地址去抓取(比如 GitHub 等),场景如下:当值列表中上一个 Go 模块代理返回 404 或 410 错误时,Go 自动尝试列表中的下一个,遇见 “direct” 时回源,也就是回到源地址去抓取,而遇见 EOF 时终止并抛出类似 “invalid version: unknown revision…” 的错误。
GOSUMDB
它的值是一个 Go checksum database,用于在拉取模块版本时(无论是从源站拉取还是通过 Go module proxy 拉取)保证拉取到的模块版本数据未经过篡改,若发现不一致,也就是可能存在篡改,将会立即中止。
GOSUMDB 的默认值为:sum.golang.org,在国内也是无法访问的,但是 GOSUMDB 可以被 Go 模块代理所代理(详见:Proxying a Checksum Database)。
因此我们可以通过设置 GOPROXY 来解决,而先前我们所设置的模块代理 goproxy.cn 就能支持代理 sum.golang.org,所以这一个问题在设置 GOPROXY 后,你可以不需要过度关心。
另外若对 GOSUMDB 的值有自定义需求,其支持如下格式:
- 格式 1:<SUMDB_NAME>+<PUBLIC_KEY>。
- 格式 2:<SUMDB_NAME>+<PUBLIC_KEY> <SUMDB_URL>。
也可以将其设置为“off”,也就是禁止 Go 在后续操作中校验模块版本。
GONOPROXY/GONOSUMDB/GOPRIVATE
这三个环境变量都是用在当前项目依赖了私有模块,例如像是你公司的私有 git 仓库,又或是 github 中的私有库,都是属于私有模块,都是要进行设置的,否则会拉取失败。
更细致来讲,就是依赖了由 GOPROXY 指定的 Go 模块代理或由 GOSUMDB 指定 Go checksum database 都无法访问到的模块时的场景。
而一般建议直接设置 GOPRIVATE,它的值将作为 GONOPROXY 和 GONOSUMDB 的默认值,所以建议的最佳姿势是直接使用 GOPRIVATE。
并且它们的值都是一个以英文逗号 “,” 分割的模块路径前缀,也就是可以设置多个,例如:
1
|
$ go env -w GOPRIVATE="git.example.com,github.com/eddycjy/mquote"
|
设置后,前缀为 git.xxx.com 和 github.com/eddycjy/mquote 的模块都会被认为是私有模块。
如果不想每次都重新设置,我们也可以利用通配符,例如:
1
|
$ go env -w GOPRIVATE="*.example.com"
|
这样子设置的话,所有模块路径为 example.com 的子域名(例如:git.example.com)都将不经过 Go module proxy 和 Go checksum database,需要注意的是不包括 example.com 本身。
总结
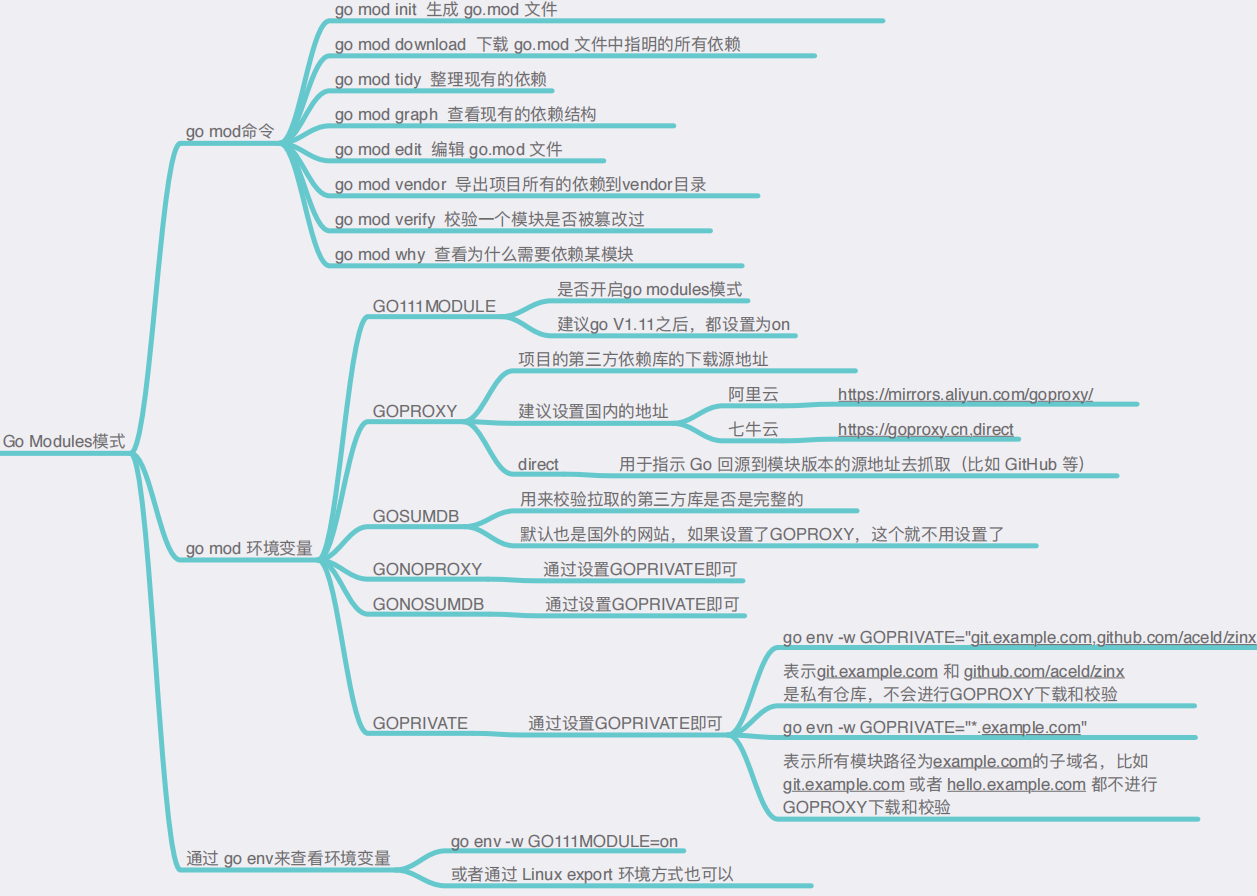
使用Go Modules初始化项目
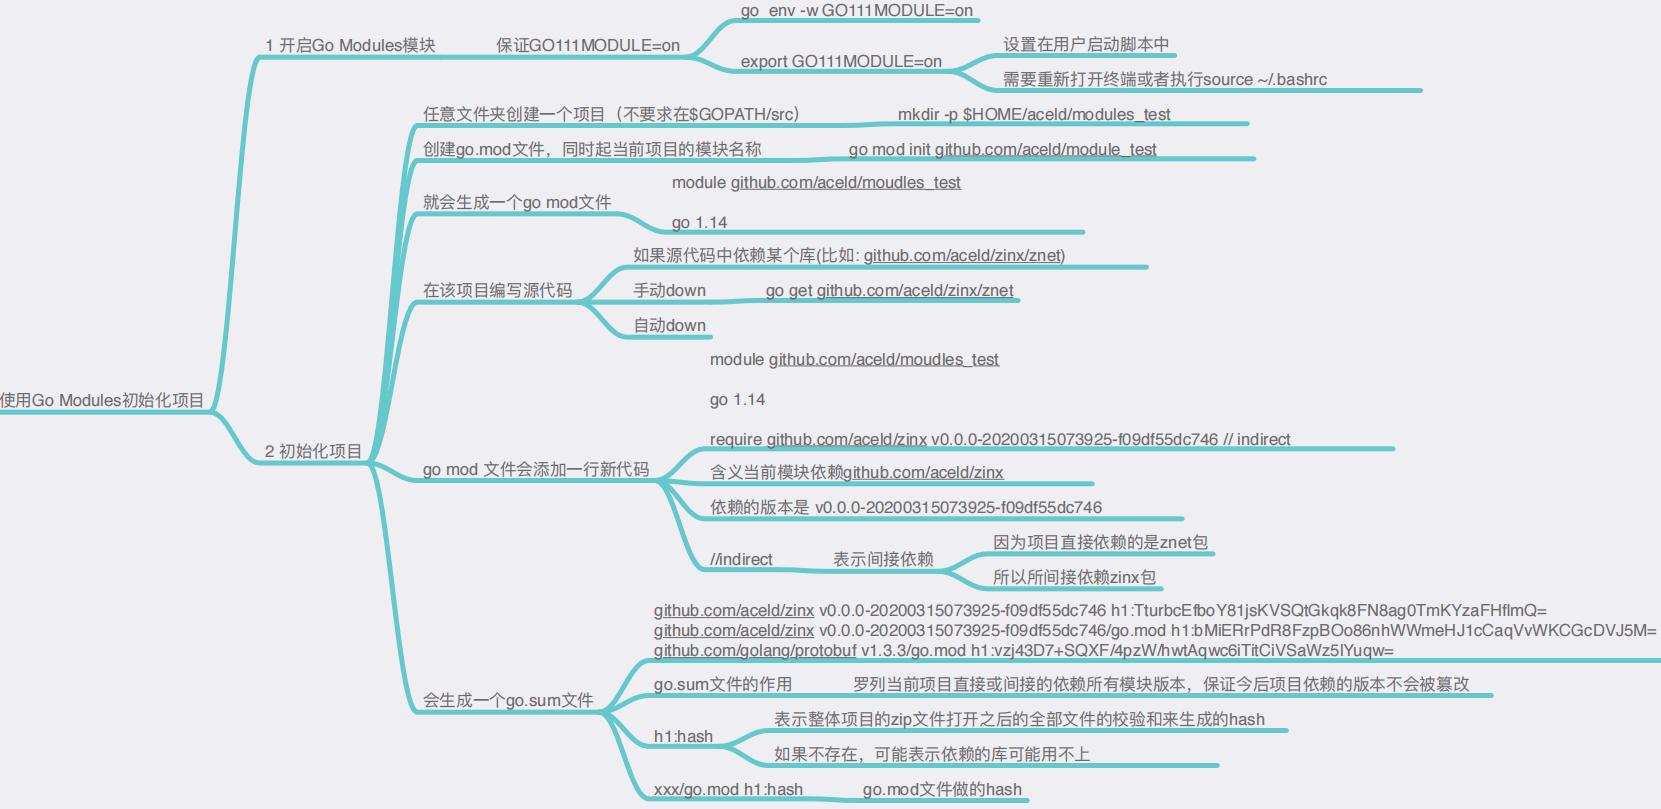
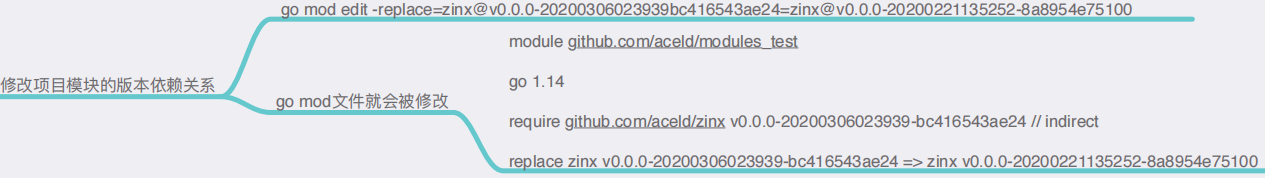
改变模块依赖关系