目标:这是一份面向初学者到进阶学习者的系统化 Markdown 学习文档,覆盖机器学习和深度学习中的经典算法,并重点深入讲解 CNN、ResNet、Transformer 的理论、结构设计、训练方式和代码实现。
为什么要学习经典算法
学习机器学习和深度学习时,很多人一开始就会被各种新模型、新论文、新框架吸引。但真正能建立长期能力的,不是“会调库”,而是对经典算法的理解。
经典算法的重要性主要体现在以下几个方面:
- 它们构成了现代 AI 的核心思想来源。
- 许多新模型本质上都是在经典模型上做改进。
- 如果不了解基础原理,后续调参、排错、建模都会很吃力。
- 面试、竞赛、项目实践都离不开这些基础。
你可以把整个学习路径理解为:
1
2
3
4
5
6
7
|
数学基础
  -> 机器学习基本思想
  -> 经典机器学习算法
  -> 神经网络基础
  -> CNN / RNN / Attention
  -> ResNet / Transformer
  -> 更复杂的大模型和应用系统
|
机器学习与深度学习总览
1. 什么是机器学习
机器学习(Machine Learning, ML)本质上是:让计算机从数据中学习规律,而不是手工编写规则。
传统编程是:
机器学习则更像:
1
2
|
输入数据 + 正确答案 -> 学到规则(模型)
学到的规则 + 新数据 -> 新的预测结果
|
2. 什么是深度学习
深度学习(Deep Learning, DL)是机器学习的一个分支,它使用多层神经网络自动学习复杂特征表示。
简单理解:
- 机器学习通常依赖人工设计特征。
- 深度学习倾向于让模型自己从原始数据中学特征。
例如图像分类任务:
- 传统机器学习:你可能先人工提取边缘、颜色直方图、纹理等特征,再交给分类器。
- 深度学习:直接把原始像素输入网络,让网络自己学低层边缘、中层纹理、高层语义。
3. 两者关系
1
2
3
|
人工智能 AI
└── 机器学习 ML
    └── 深度学习 DL
|
4. 常见任务类型
监督学习
数据带标签,例如:
无监督学习
数据没有标签,例如:
半监督学习
少量有标签数据 + 大量无标签数据。
强化学习
智能体和环境交互,通过奖励信号学习策略。
什么是奖励信号?例如:
机器学习的基础概念
这一部分非常关键。很多人后面学不动,不是因为模型太难,而是因为这些底层概念没有真正弄懂。
1. 数据集、特征、标签
- 样本(sample):一条数据。
- 特征(feature):描述样本的信息。
- 标签(label):样本的目标结果。
例如房价预测:
2. 训练集、验证集、测试集
- 训练集:用于训练模型参数。
- 验证集:用于调参、选择模型。
- 测试集:用于最终评估泛化性能。
典型划分:
1
2
|
训练集 : 验证集 : 测试集 = 7 : 1.5 : 1.5
或 8 : 1 : 1
|
3. 模型、参数、超参数
模型
模型是一个函数:
$$
\hat{y} = f(x)
$$
其中:
- $x$ 是输入
- $\hat{y}$ 是预测输出
- $f$ 是模型
参数
参数是在训练中学出来的,例如线性回归的权重、神经网络中的权重矩阵。
超参数
超参数是训练前人为指定的,例如:
- 学习率
- batch size
- 网络层数
- 正则化系数
4. 损失函数
损失函数衡量模型预测结果和真实结果之间的差距。
回归常见损失
均方误差(MSE):
$$
L = \frac{1}{n}\sum_{i=1}^{n}(y_i - \hat{y}_i)^2
$$
分类常见损失
交叉熵损失(Cross Entropy):
$$
L = -\sum_i y_i \log \hat{y}_i
$$
5. 优化目标
训练模型就是找到一组参数,使损失最小:
$$
\theta^* = \arg\min_{\theta} L(\theta)
$$
6. 欠拟合与过拟合
欠拟合
模型太简单,无法学到数据规律。
表现:
过拟合
模型把训练集记住了,但泛化能力差。
表现:
7. 偏差与方差
偏差(Bias)
模型假设过强,表达能力不足。
方差(Variance)
模型对训练数据过于敏感。
理想目标是:在偏差和方差之间找到平衡。
8. 常见评估指标
回归
- MAE(Mean Absolute Error):表示平均绝对误差。
- MSE(Mean Squared Error):表示均方误差。
- RMSE(Root Mean Squared Error):表示均方根误差。
- $R^2$(决定系数):表示模型的拟合优度。
分类
- Accuracy(准确率):表示分类正确的样本占总样本的比例。
- Precision(精确率):表示预测为正例的样本中实际为正例的比例。
- Recall(召回率):表示实际为正例的样本中被正确预测的比例。
- F1-score(F1分数):表示精确率和召回率的调和平均。
- ROC-AUC(ROC曲线下面积):表示模型在不同阈值下的分类性能。
对于类别不平衡问题,不能只看 Accuracy。
9. 数据预处理
机器学习中,数据质量往往比模型复杂度更重要。
常见处理包括:
- 缺失值处理
- 异常值处理
- 标准化
- 归一化
- 类别编码
- 特征选择
标准化:把数据变成均值为 0,标准差为 1 的分布
$$
x’ = \frac{x - \mu}{\sigma}
$$
归一化:把数据缩放到 [0, 1] 区间
$$
x’ = \frac{x - x_{min}}{x_{max} - x_{min}}
$$
经典机器学习算法
这一部分先建立“传统机器学习脑图”,后面再进入神经网络世界。
1. 线性回归
线性回归用于预测连续值。
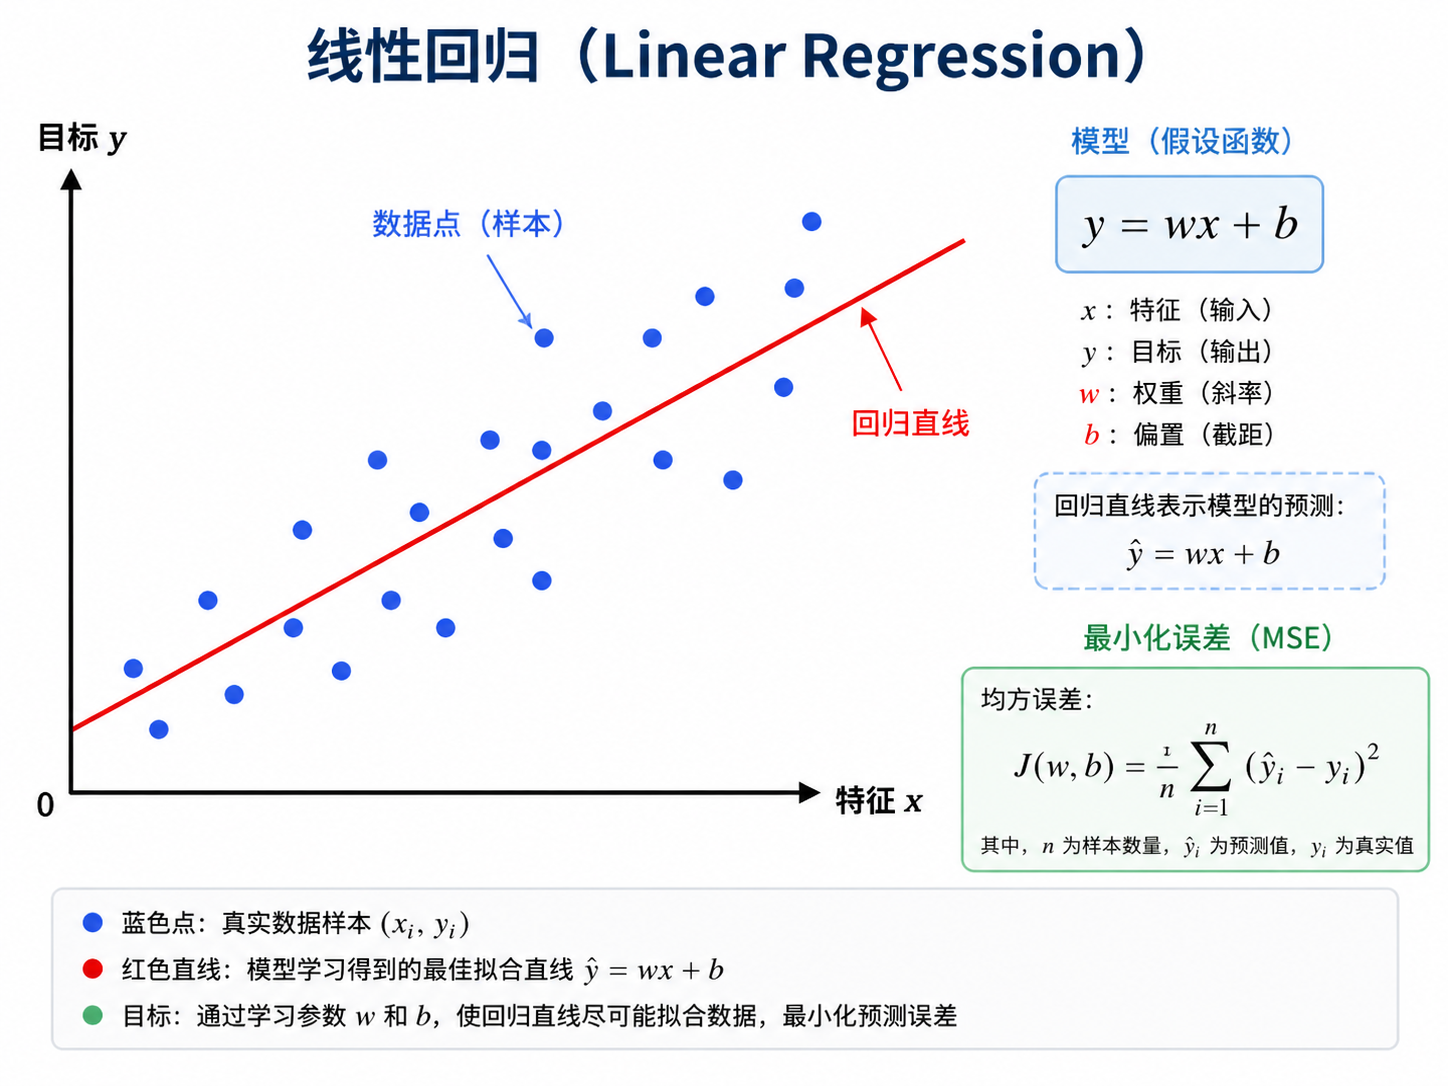
模型形式:
$$
\hat{y} = w^Tx + b
$$
核心思想:
- 假设输出和输入特征是线性关系。
- 用最小二乘或梯度下降拟合参数。
优点
缺点
示例代码
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
|
import numpy as np
from sklearn.linear_model import LinearRegression

X = np.array([[1], [2], [3], [4], [5]])
y = np.array([2, 4, 6, 8, 10])

model = LinearRegression()
model.fit(X, y)

print("weight:", model.coef_)
print("bias:", model.intercept_)
print("pred:", model.predict([[6]]))
|
model = LinearRegression() 这行代码创建了一个线性回归模型对象。model.fit(X, y) 这行代码使用训练数据 X 和标签 y 来训练模型,学习出权重和偏置。最后,model.predict([[6]]) 这行代码使用训练好的模型来预测输入 6 的输出。
2. 逻辑回归
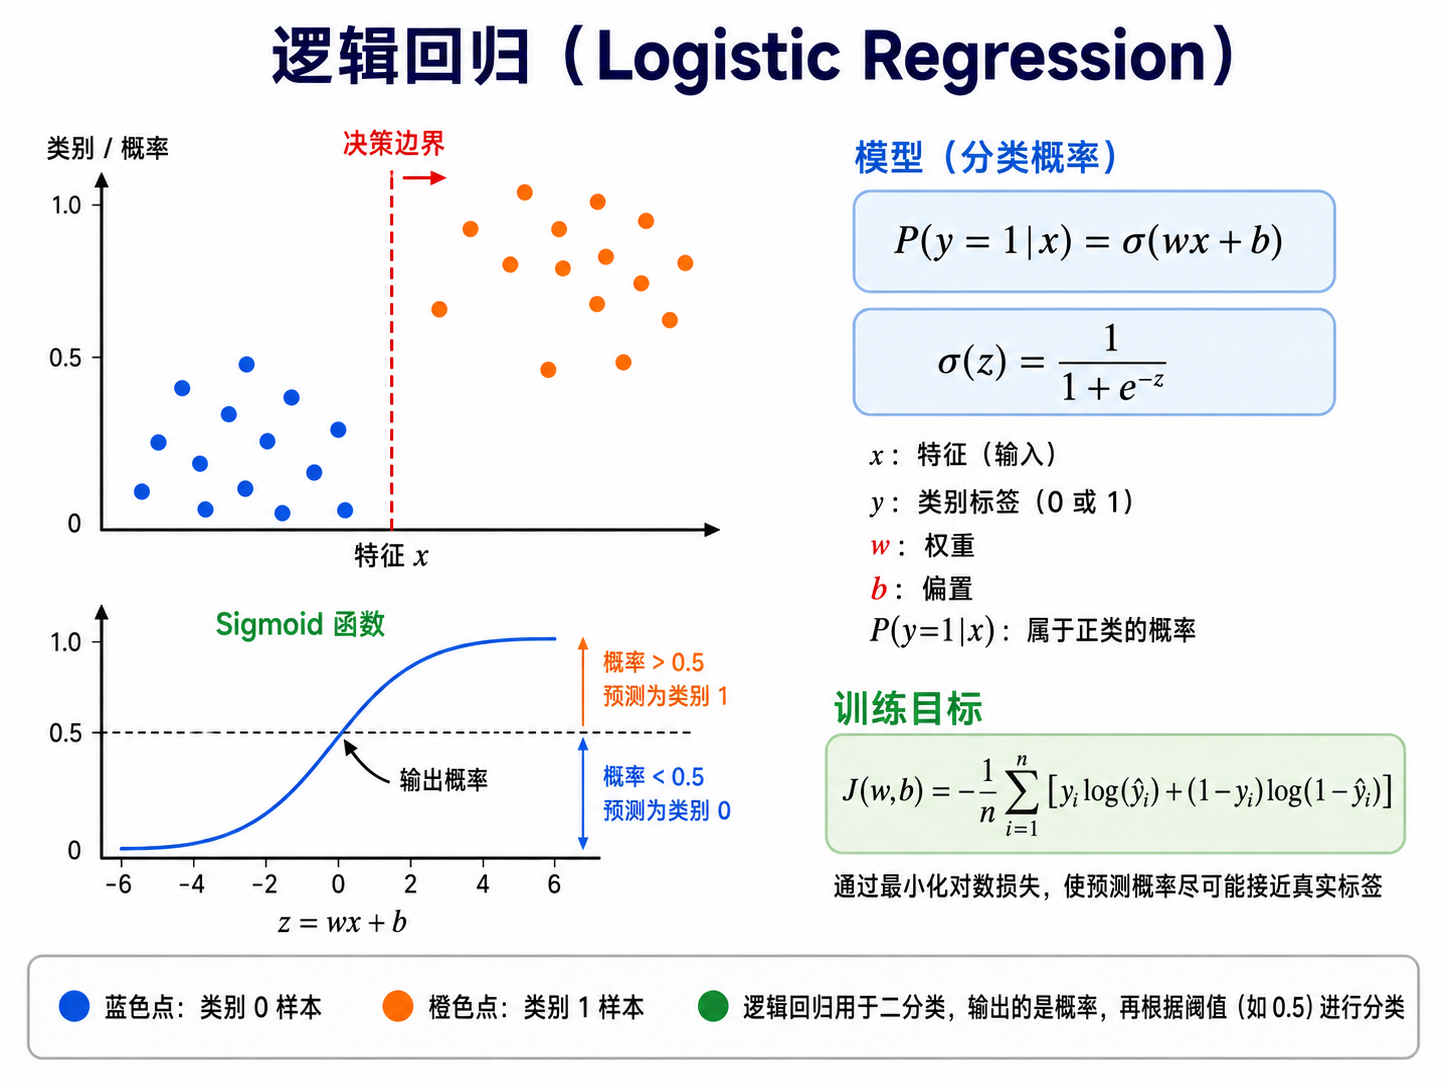
虽然名字叫“回归”,但逻辑回归通常用于分类。
它先做线性变换:
$$
z = w^Tx + b
$$
再通过 sigmoid 映射为概率:
$$
\sigma(z) = \frac{1}{1 + e^{-z}}
$$
输出可以解释为样本属于正类的概率。
优点
- 简洁、高效、可解释。
- 对很多结构化数据任务依然有效。
示例代码
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
from sklearn.linear_model import LogisticRegression
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

clf = LogisticRegression(max_iter=500)
clf.fit(X_train, y_train)

print("test accuracy:", clf.score(X_test, y_test))
|
X, y = load_iris(return_X_y=True) 这行代码加载了 Iris 数据集,并将特征存储在 X 中,标签存储在 y 中。train_test_split 这行代码将数据集划分为训练集和测试集,其中 test_size=0.2 表示测试集占总数据的 20%。
clf = LogisticRegression(max_iter=500) 创建了一个逻辑回归模型对象,并设置最大迭代次数为 500。clf.fit(X_train, y_train) 使用训练数据来训练模型。最后,clf.score(X_test, y_test) 这行代码评估模型在测试集上的准确率。
补充:iris 数据集是一个经典的多分类数据集,包含 150 个样本,每个样本有 4 个特征(花萼长度、花萼宽度、花瓣长度、花瓣宽度),分为 3 个类别(Setosa、Versicolor、Virginica)。逻辑回归在这个数据集上表现不错,因为它可以通过线性决策边界来区分不同类别。
3. 决策树
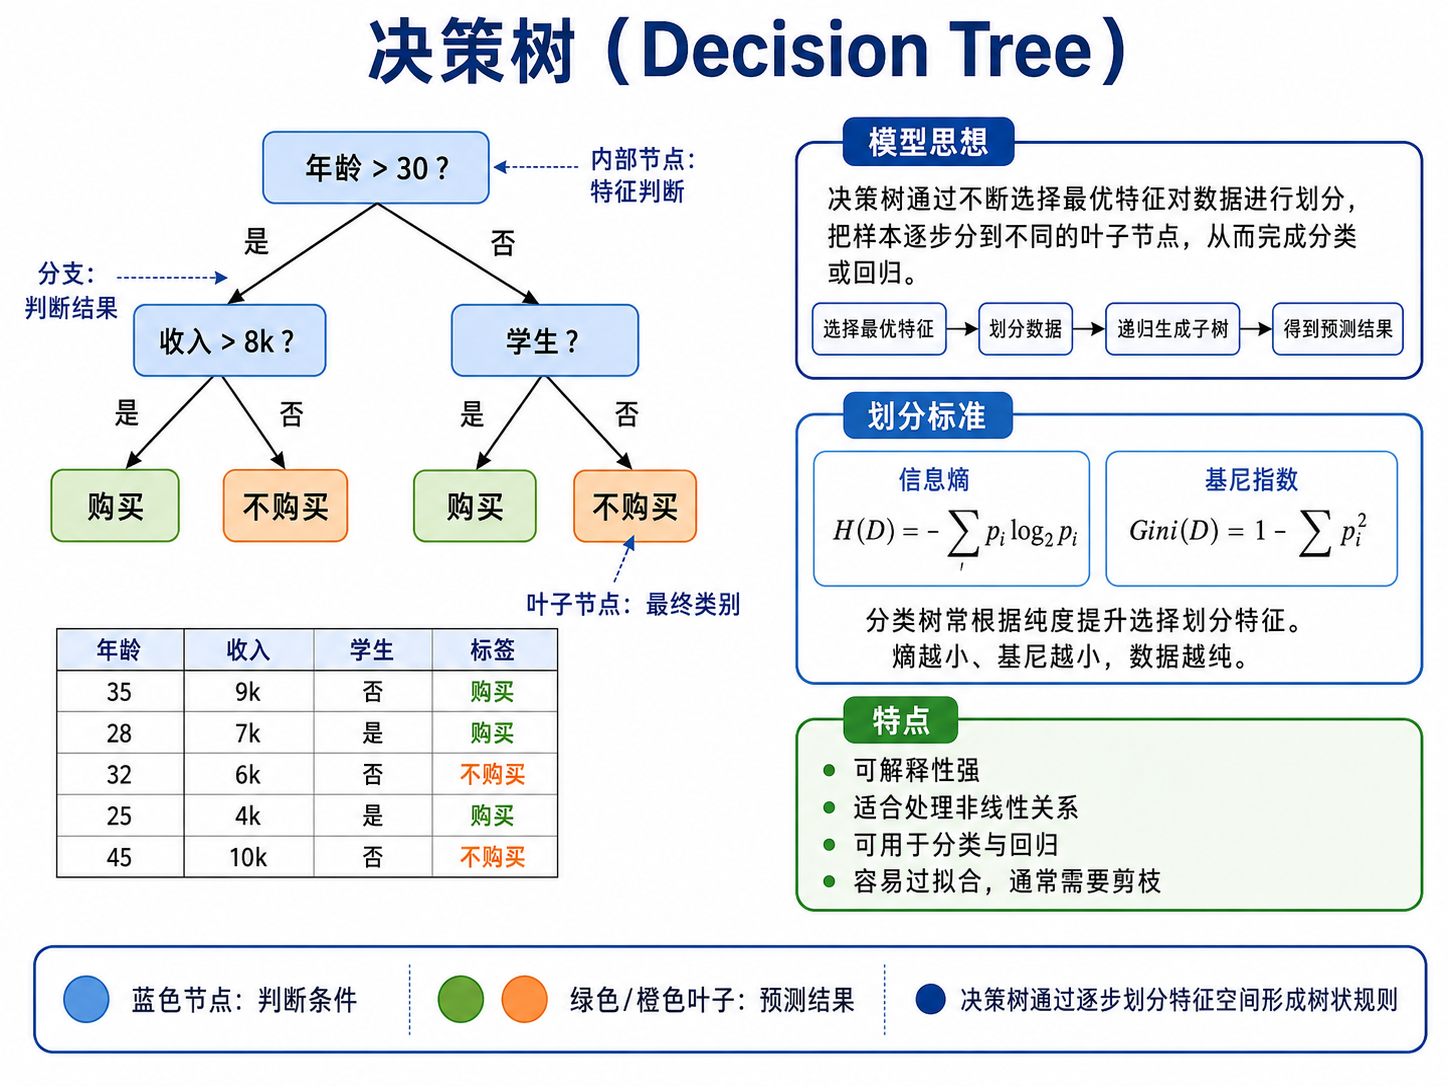
决策树通过一系列“如果…那么…”规则进行划分。
例如:
1
2
|
如果年龄 < 30 且 收入 > 10k,则购买
否则不购买
|
核心思想
通过选择最优特征进行划分,使每个子节点尽量“纯”。
常见划分指标:
优点
缺点
示例代码
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
from sklearn.tree import DecisionTreeClassifier
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split

X, y = load_wine(return_X_y=True)   # 加载葡萄酒数据集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

tree = DecisionTreeClassifier(max_depth=4, random_state=42)
tree.fit(X_train, y_train)

print("accuracy:", tree.score(X_test, y_test))
|
tree = DecisionTreeClassifier(max_depth=4, random_state=42) 这行代码创建了一个决策树分类器对象,并设置最大深度为 4,以防止过拟合。tree.fit(X_train, y_train) 使用训练数据来训练决策树模型。最后,tree.score(X_test, y_test) 这行代码评估模型在测试集上的准确率。
4. 随机森林
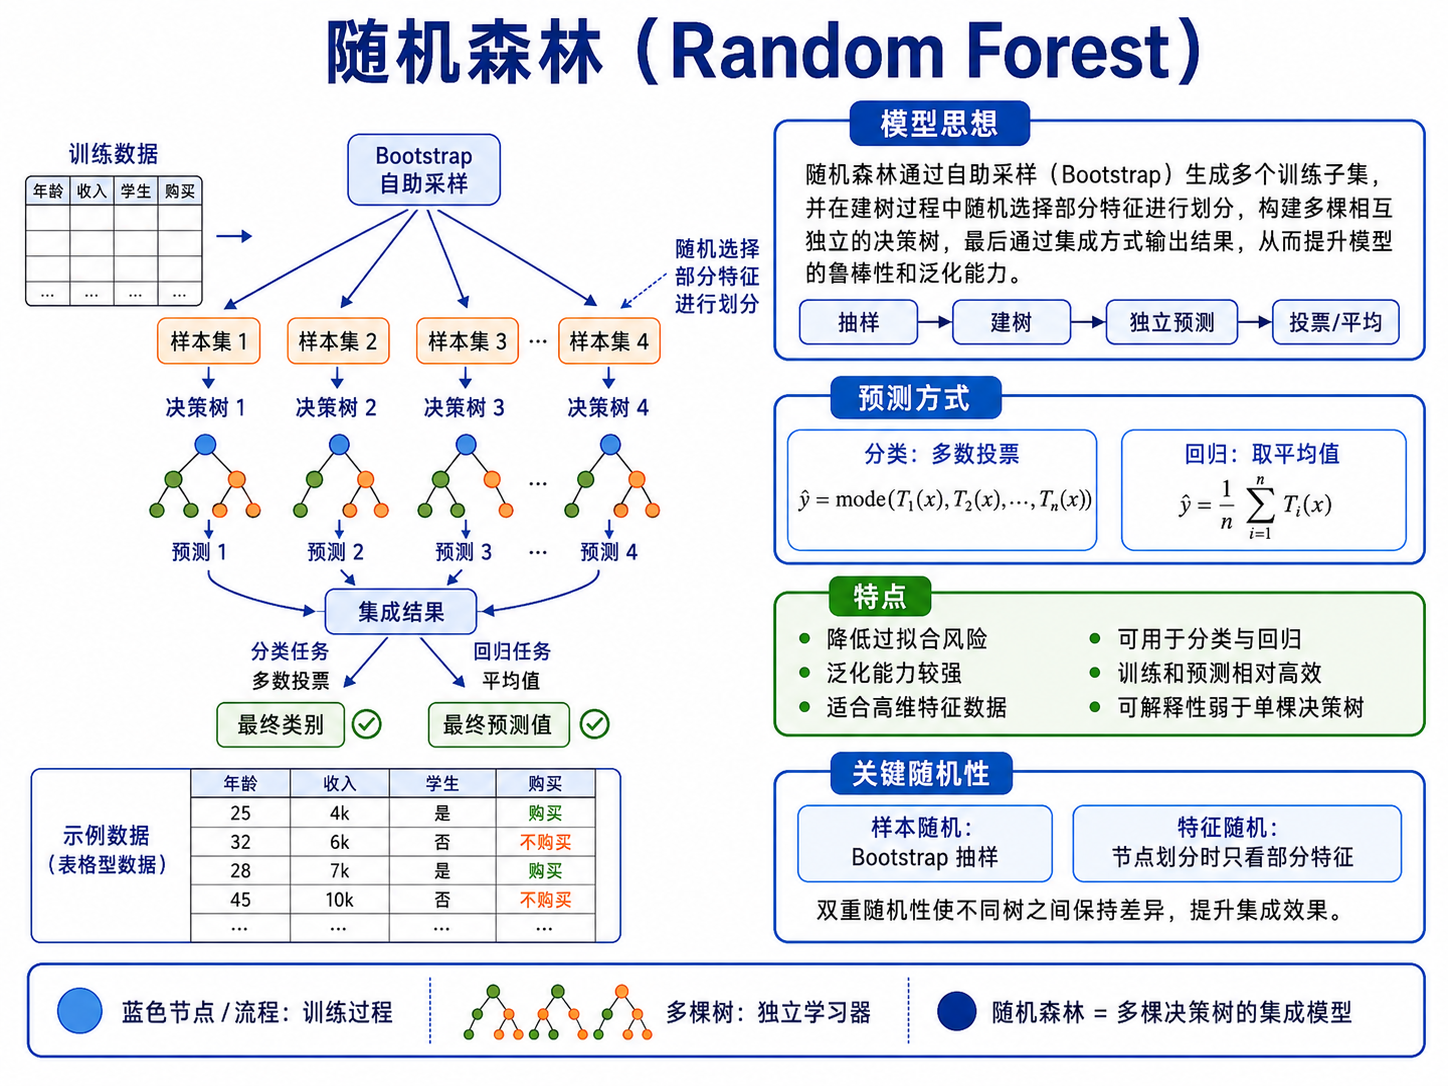
随机森林是多个决策树的集成。
核心思想:
- 对数据进行有放回抽样(Bootstrap)。
- 每棵树训练时只看部分特征。
- 最终通过投票或平均得到输出。
优点
- 比单棵树更稳健
- 抗过拟合能力更强
- 在结构化数据上表现常常很好
示例代码
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
|
from sklearn.ensemble import RandomForestClassifier
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split

X, y = load_breast_cancer(return_X_y=True)  # 加载乳腺癌数据集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

rf = RandomForestClassifier(n_estimators=200, max_depth=6, random_state=42)
rf.fit(X_train, y_train)

print("accuracy:", rf.score(X_test, y_test))
|
5. 支持向量机 SVM
SVM 的核心思想是找到一个分类超平面,使两类样本之间的间隔最大。
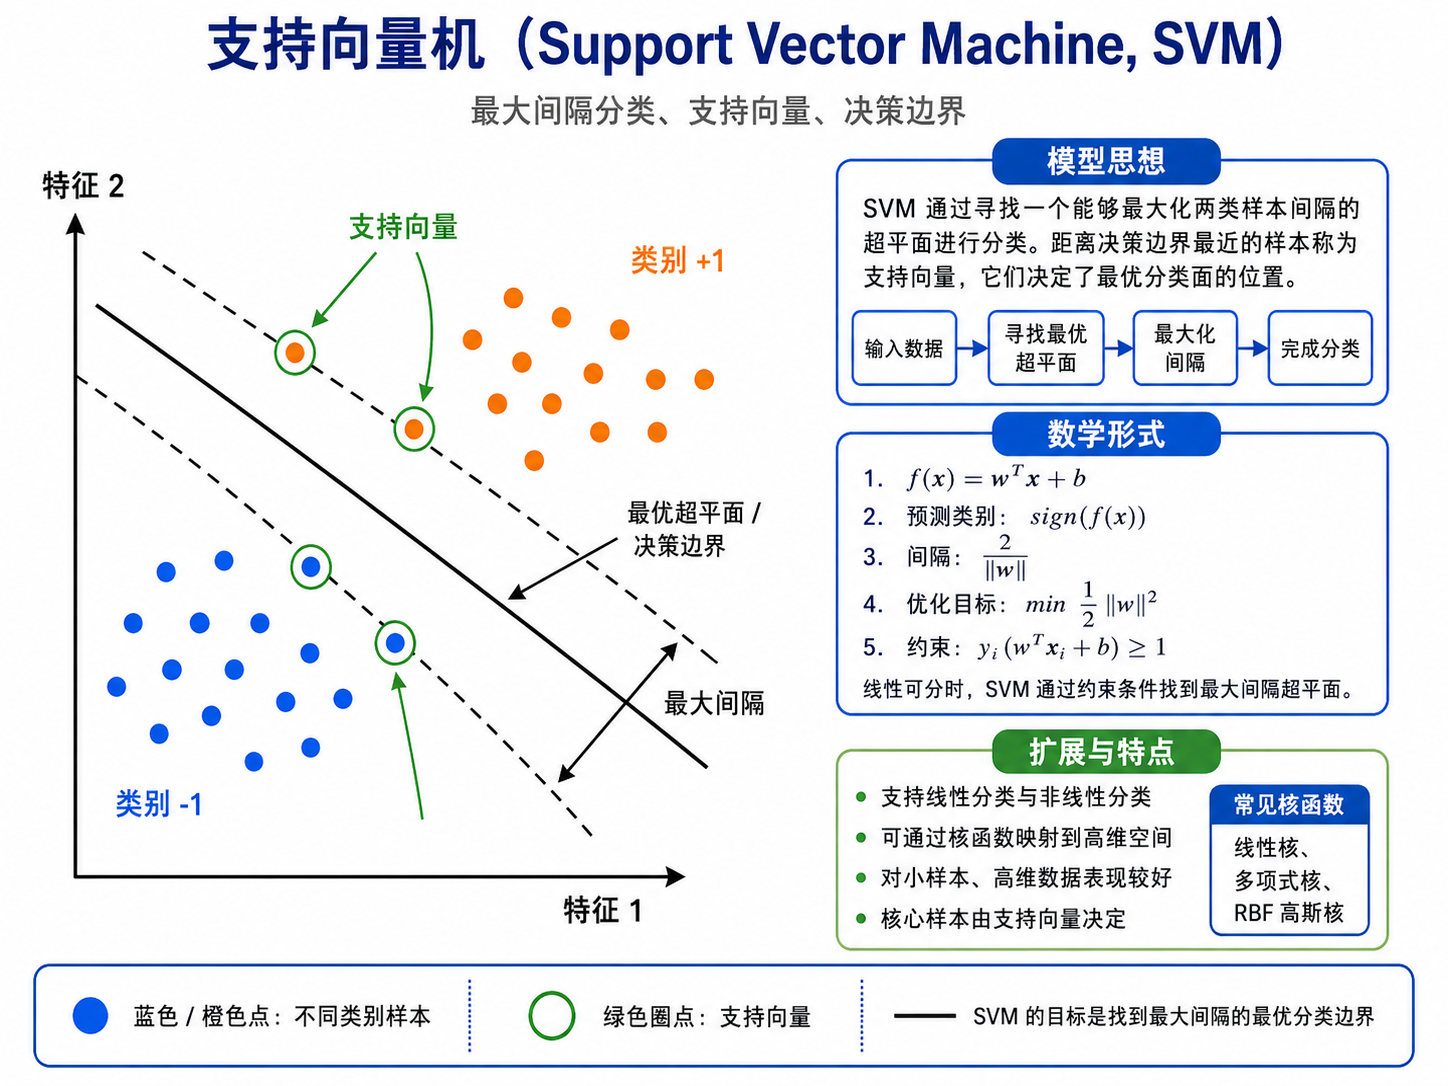
对于线性可分情况:
$$
w^Tx + b = 0
$$
SVM 希望最大化 margin,也就是两类样本之间的距离。
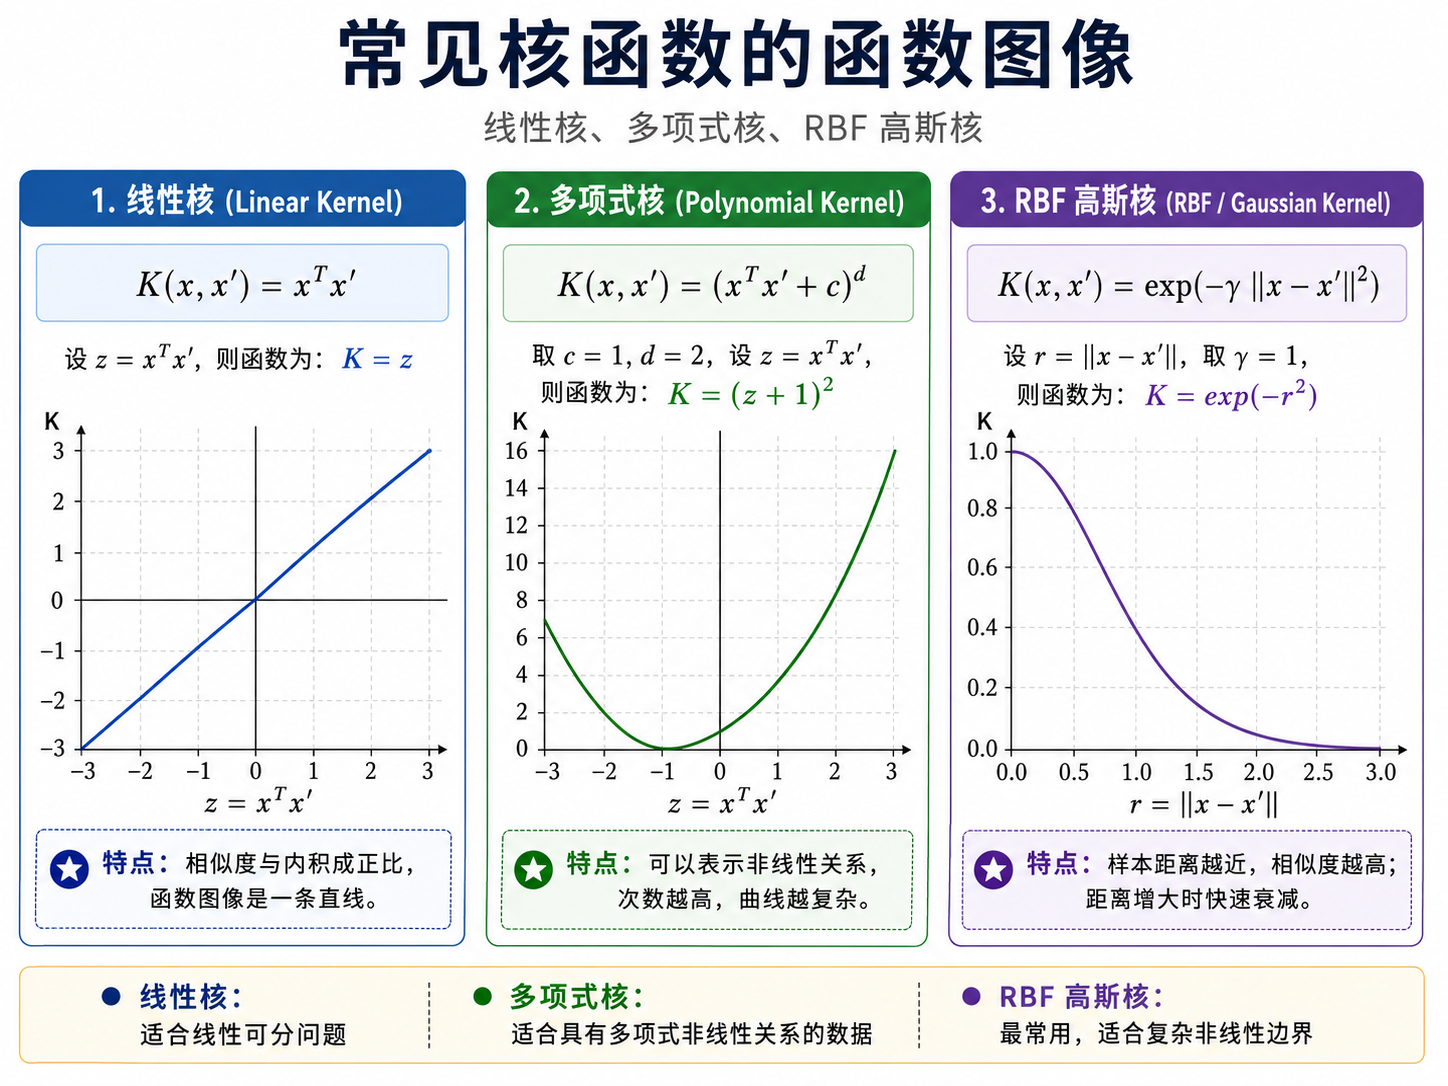
对于线性不可分情况,可以借助核函数映射到高维空间。
常见核函数:
优点
缺点
6. KNN(K Nearest Neighbors)
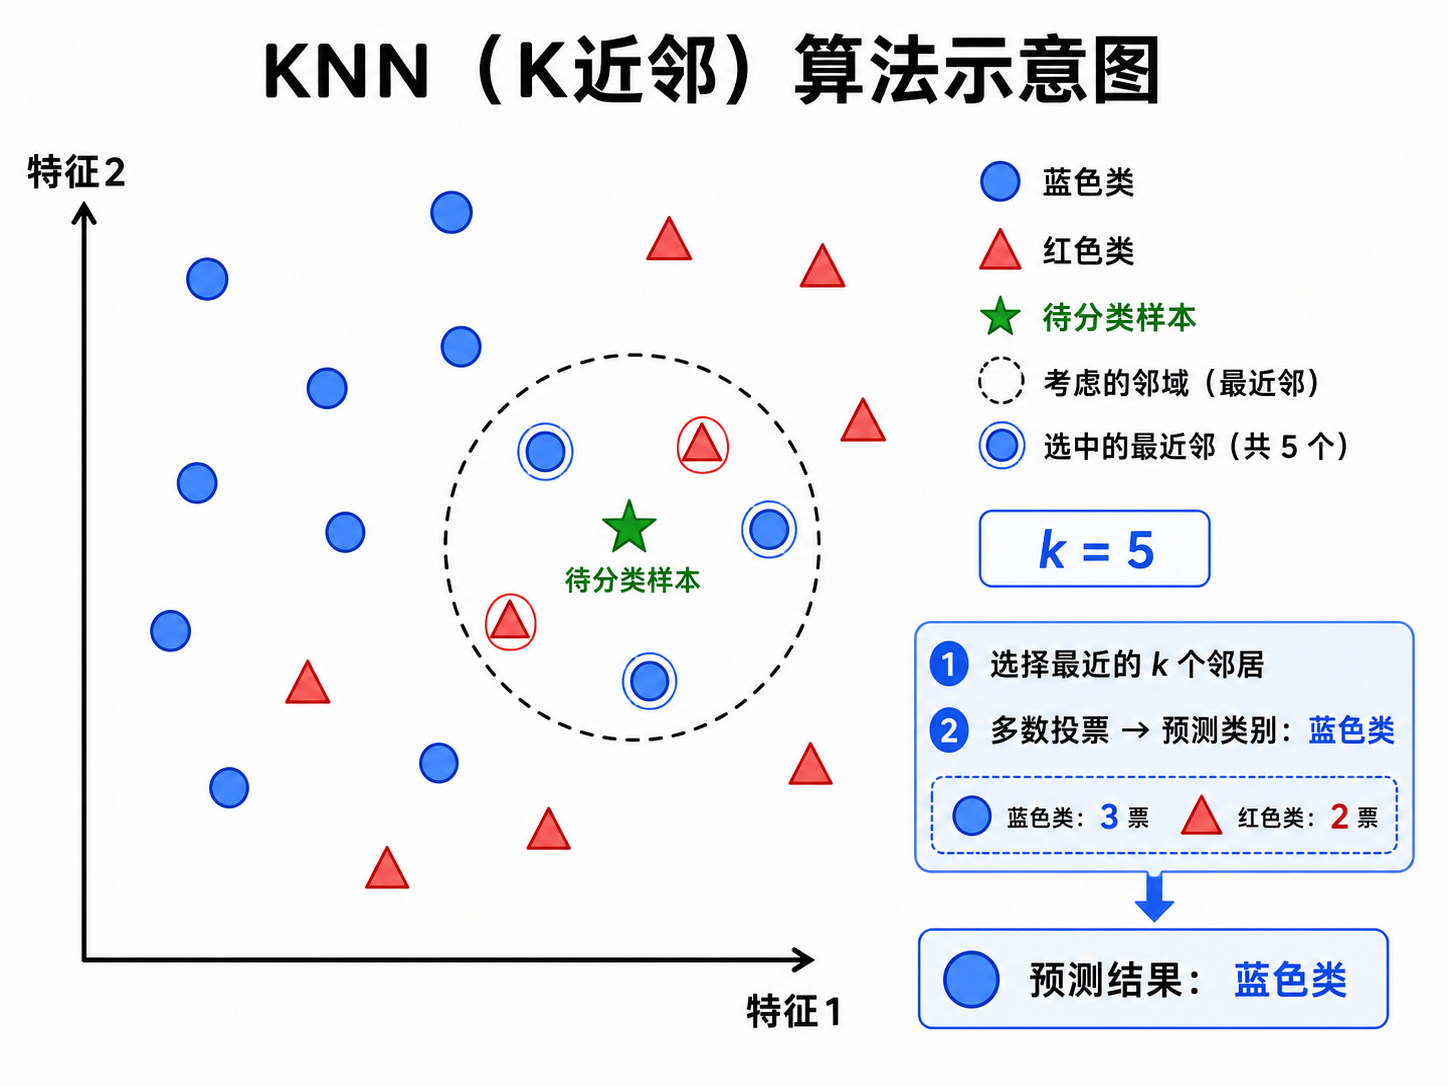
K 近邻是一种非常直观的算法。
预测时:
- 找到离当前样本最近的 K 个训练样本。
- 看这些邻居的标签。
- 多数投票或平均。
特点
7. K-Means 聚类
K-Means 是经典无监督聚类算法。
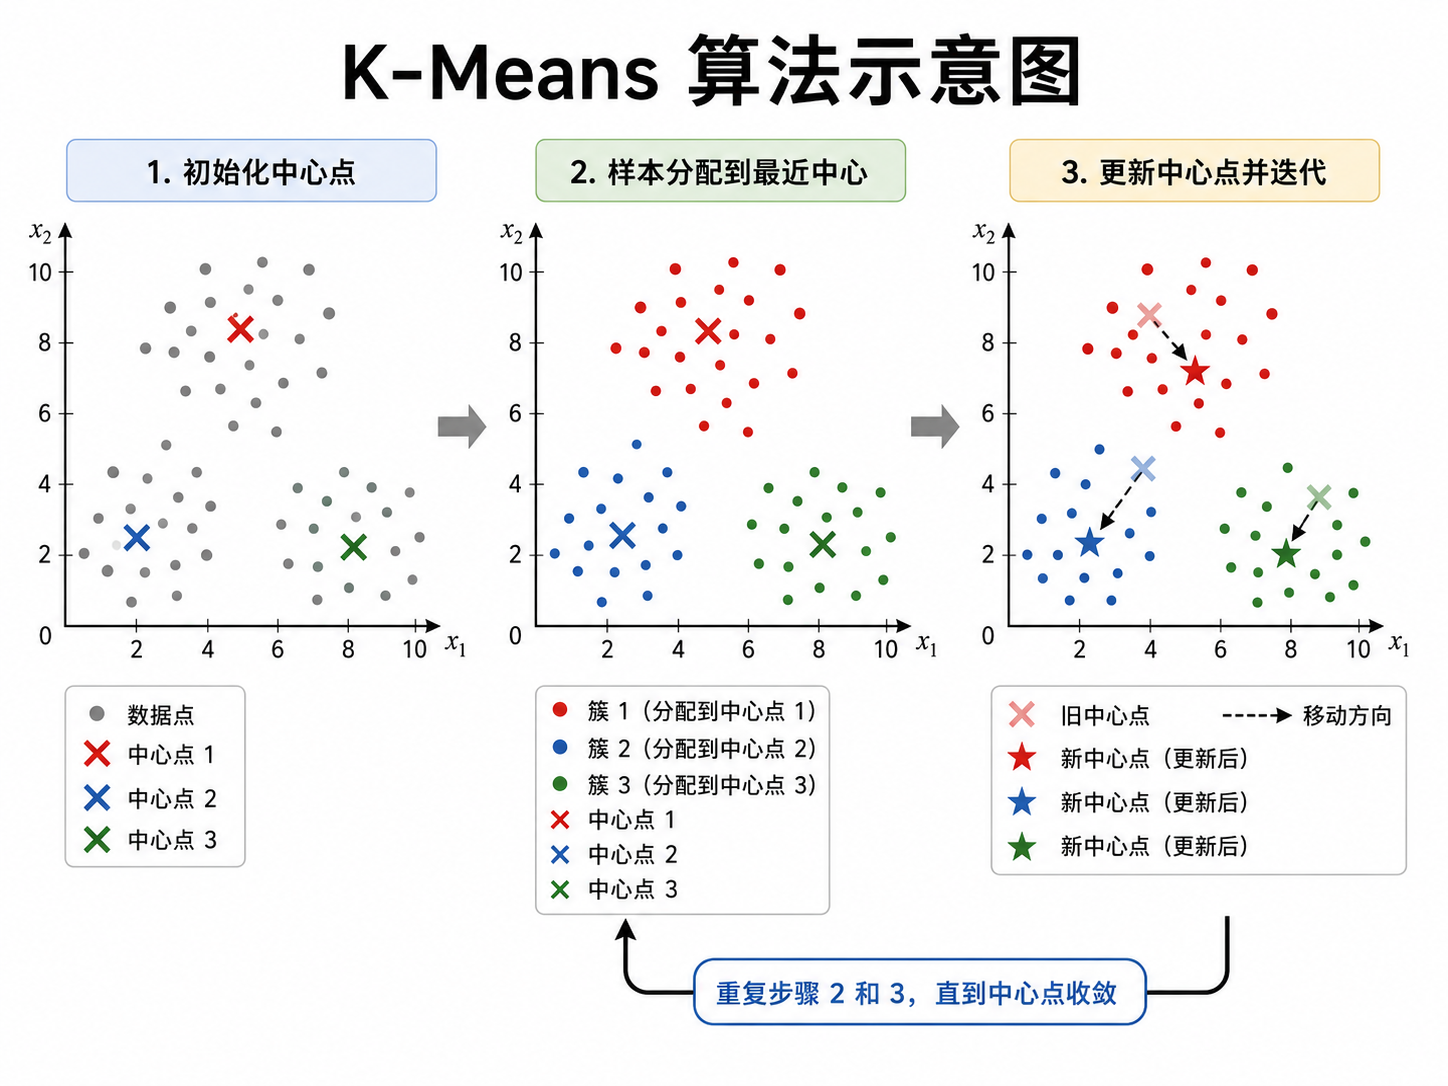
步骤:
- 初始化 K 个中心点。
- 将每个样本分配到最近中心。
- 更新每个簇中心为簇内均值。
- 重复直到收敛。
优化目标:
$$
\sum_{i=1}^{K}\sum_{x \in C_i} ||x - \mu_i||^2
$$
缺点
8. PCA 主成分分析
PCA 用于降维。
核心思想:
- 找到数据方差最大的方向作为主成分。
- 用较少维度保留大部分信息。
PCA 的价值:
9. 集成学习:Boosting
Boosting 通过串行训练多个弱学习器,不断纠正前一个模型的错误。
典型算法:
- AdaBoost
- GBDT
- XGBoost
- LightGBM
- CatBoost
如果你将来做表格数据任务,Boosting 系列模型几乎一定要学。
深度学习基础
要理解 CNN、ResNet、Transformer,必须先真正理解神经网络。
1. 感知机
感知机是最早的神经元模型之一。
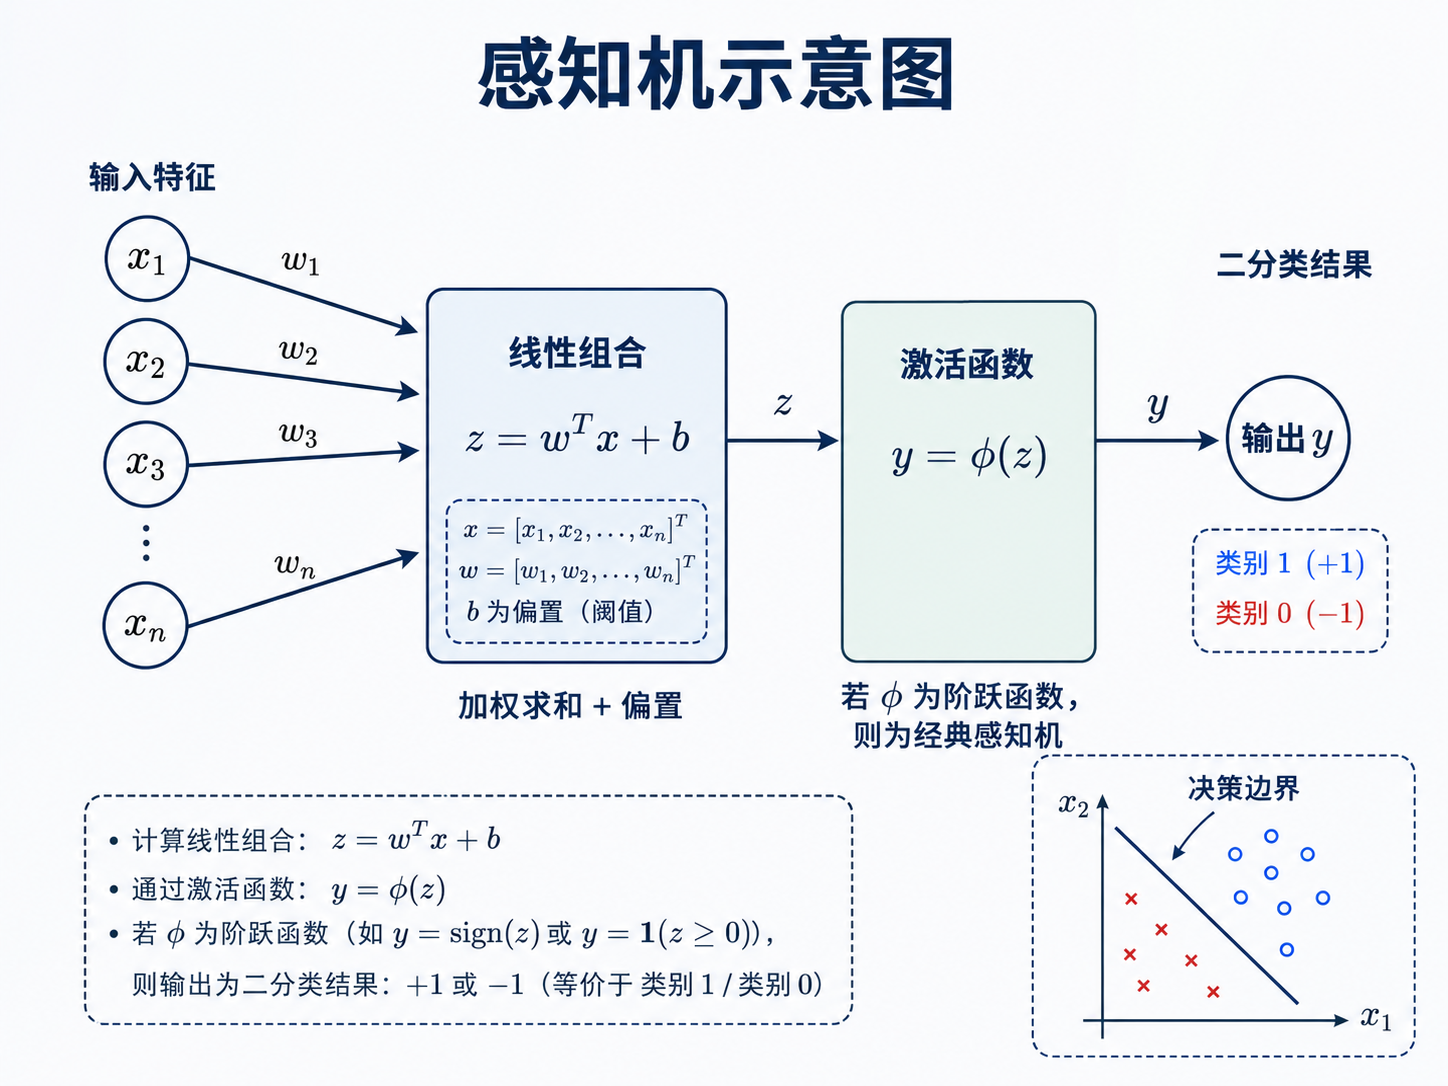
形式:
$$
z = w^Tx + b
$$
经过激活函数得到输出:
$$
y = \phi(z)
$$
如果 $\phi$ 是阶跃函数,就是早期感知机。
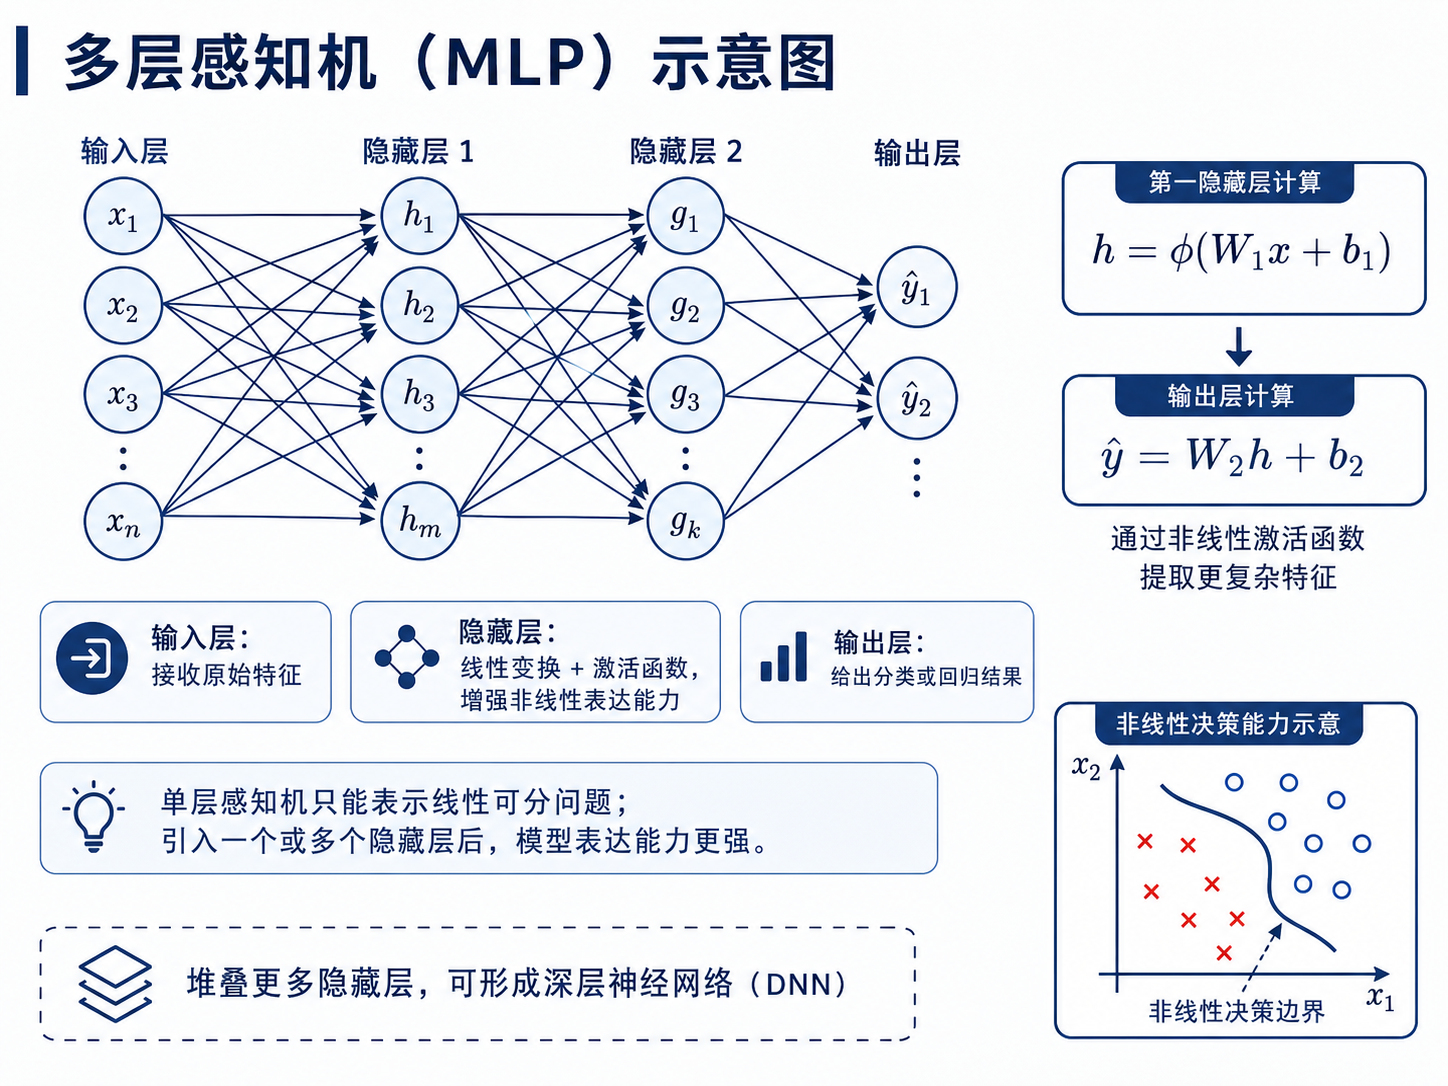
2. 多层感知机 MLP
单层线性模型能力有限,因此引入隐藏层:
$$
h = \phi(W_1x + b_1)
$$
$$
\hat{y} = W_2h + b_2
$$
如果堆叠更多层,就形成深层神经网络。
3. 激活函数
没有非线性激活函数,多层网络等价于单层线性模型。
Sigmoid
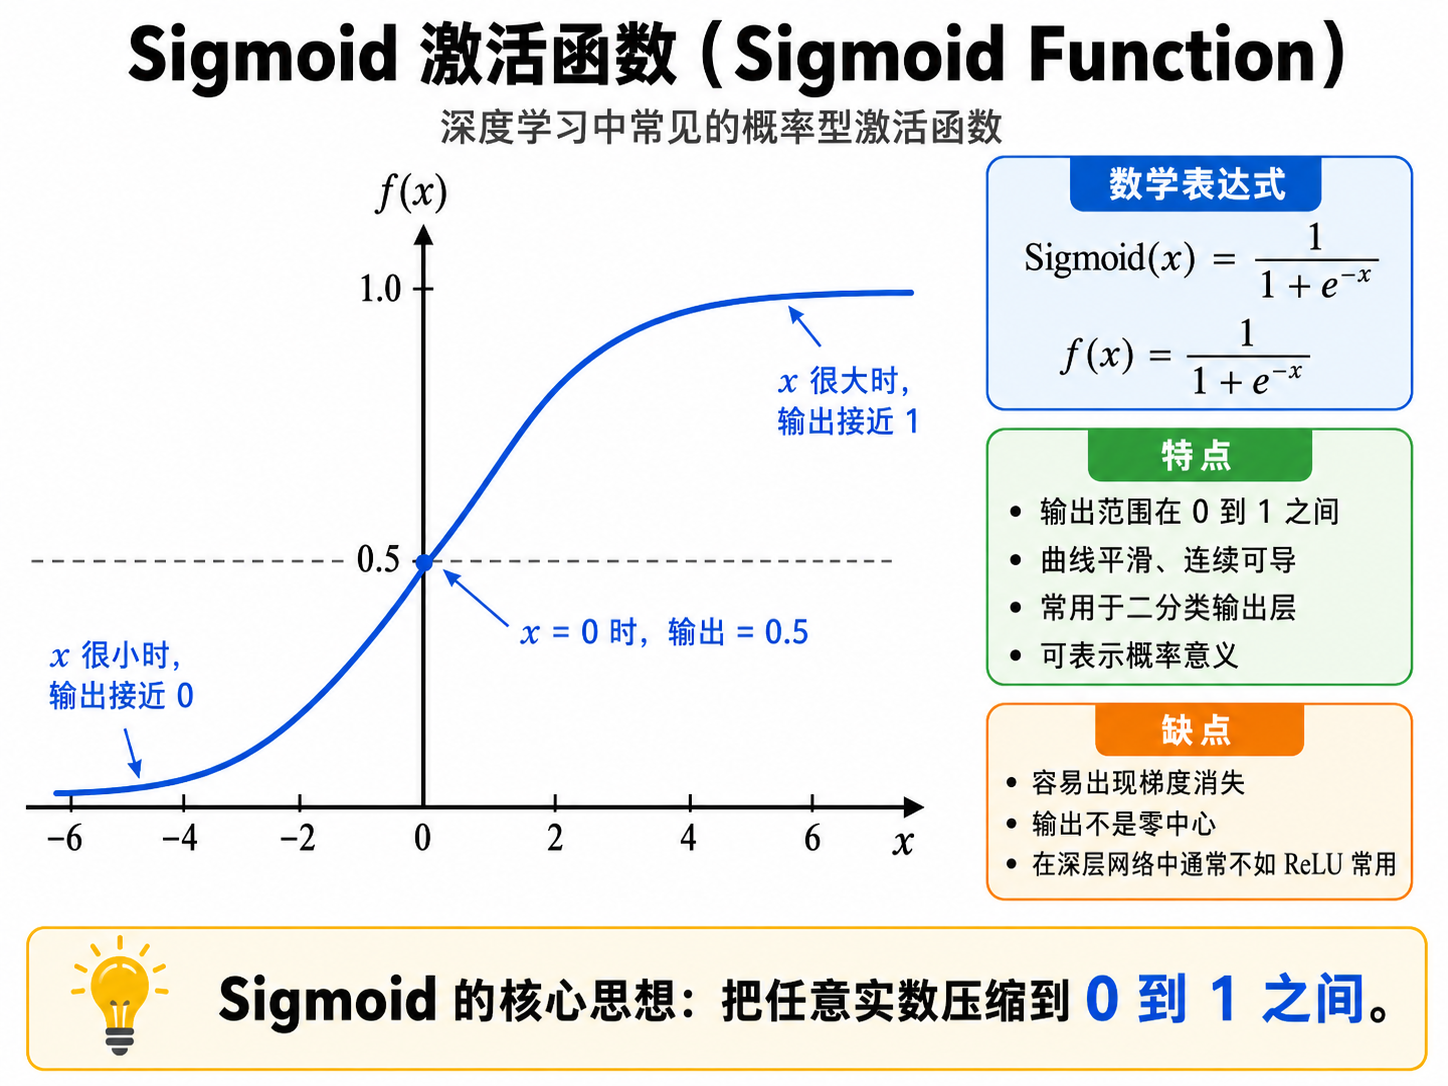
$$
\sigma(x) = \frac{1}{1+e^{-x}}
$$
优点:
缺点:
Tanh
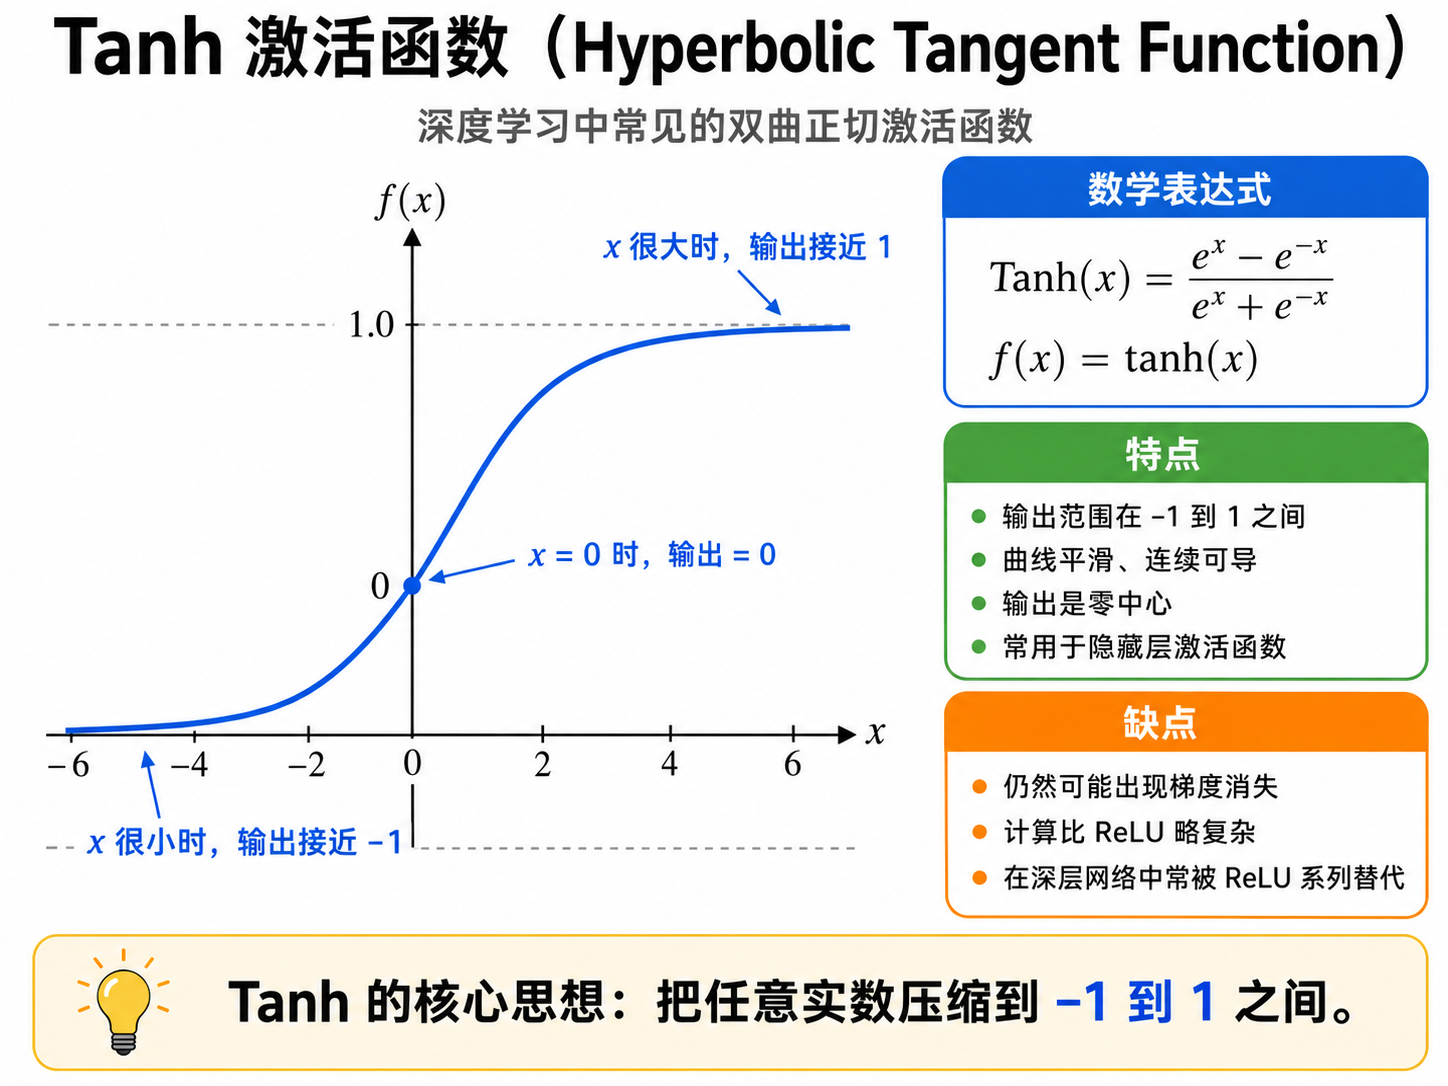
$$
\tanh(x) = \frac{e^x - e^{-x}}{e^x + e^{-x}}
$$
输出范围为 [-1, 1]。
ReLU
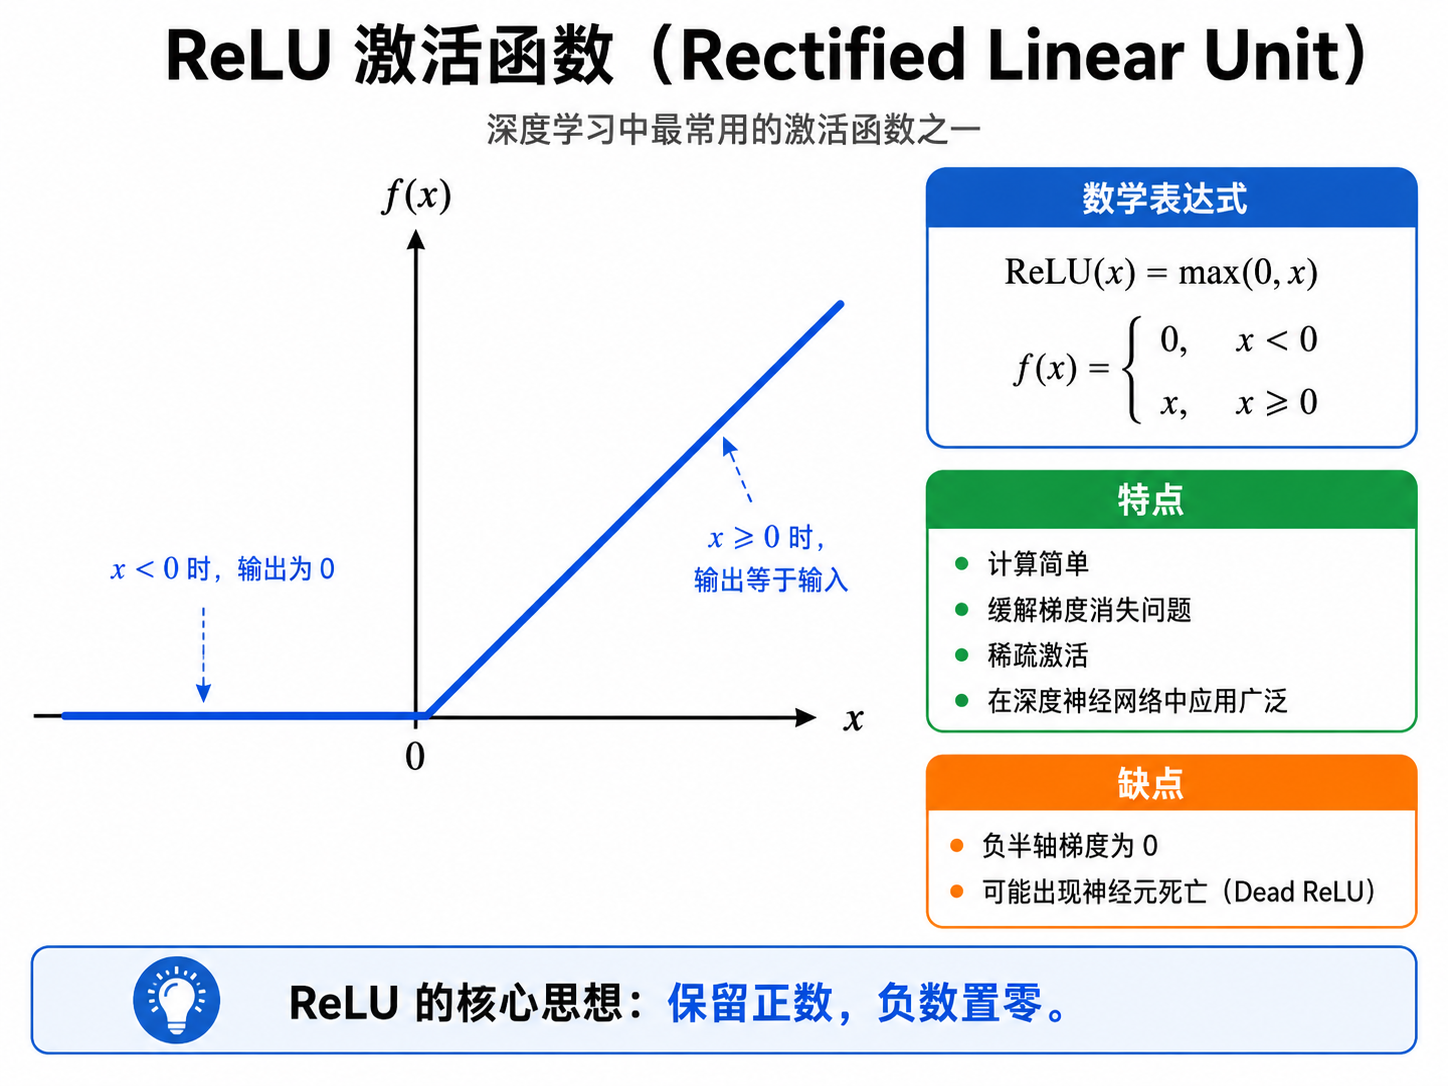
$$
\text{ReLU}(x)=\max(0, x)
$$
优点:
缺点:
GELU
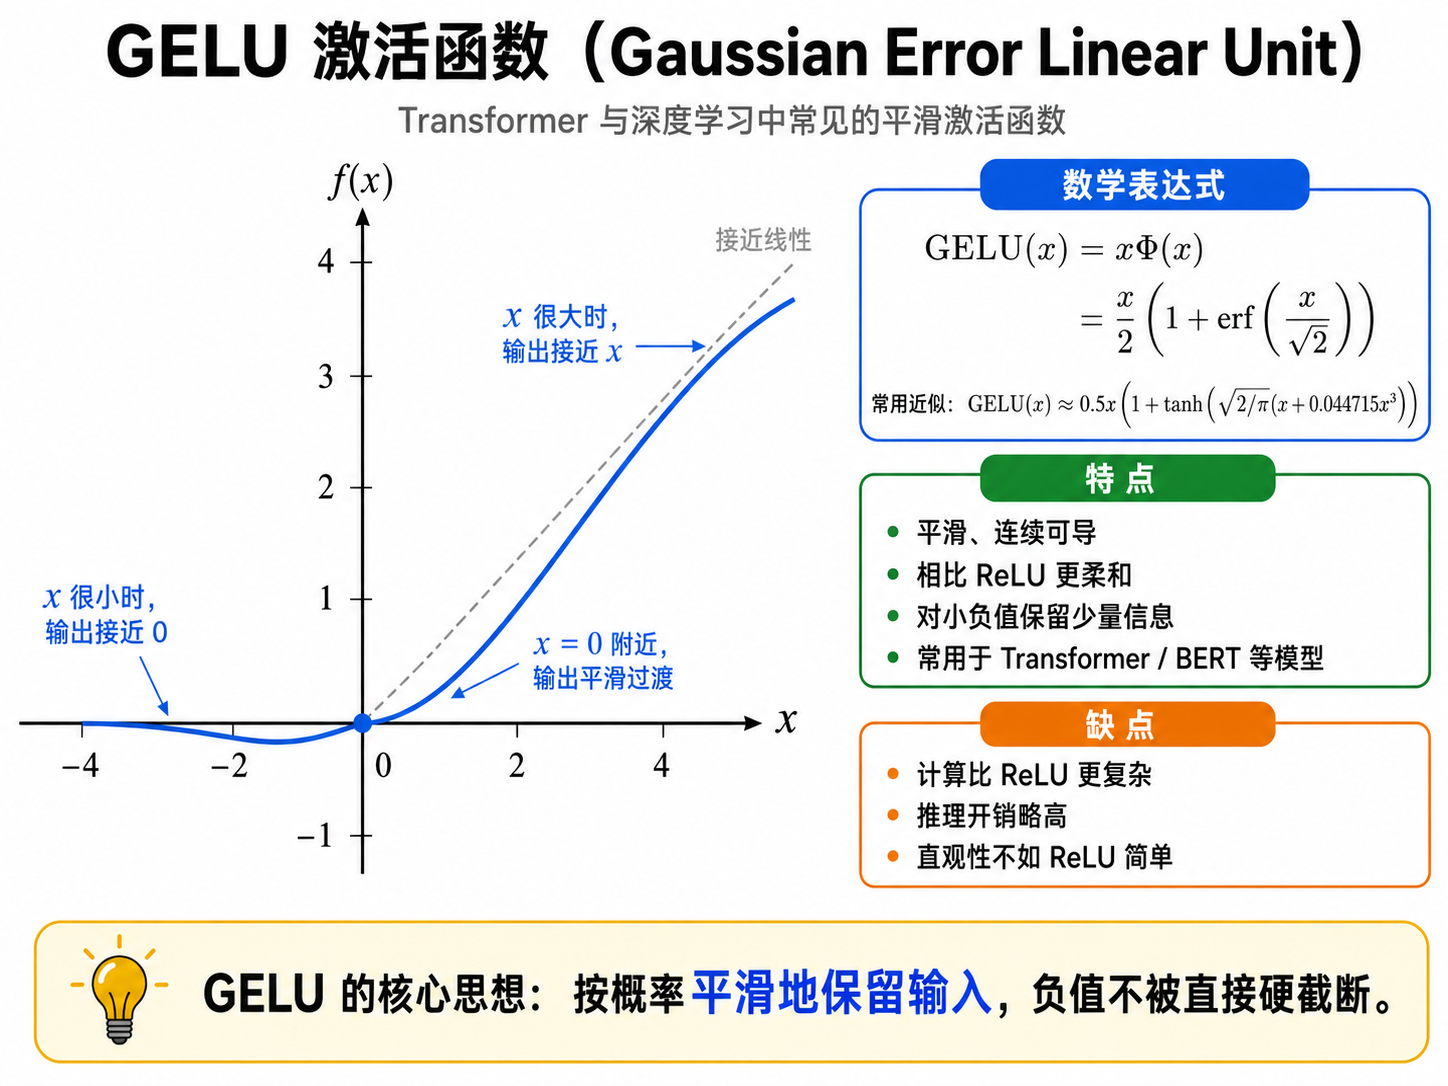
Transformer 中常见。
比 ReLU 更平滑。
4. 前向传播
前向传播就是输入数据逐层经过线性变换和激活,得到输出。
5. 反向传播
反向传播是深度学习训练的核心。
它通过链式法则计算损失对各层参数的梯度。
核心过程:
- 前向传播得到输出和损失。
- 从输出层向前一层层计算梯度。
- 用优化器根据梯度更新参数。
6. 梯度下降
参数更新公式:
$$
\theta \leftarrow \theta - \eta \nabla_\theta L
$$
其中:
- $\theta$ 是参数
- $\eta$ 是学习率
- $\nabla_\theta L$ 是梯度
三种常见形式
- Batch Gradient Descent:每次用整个训练集计算梯度,更新一次参数。
- Stochastic Gradient Descent:每次用一个样本计算梯度,更新一次参数。
- Mini-batch Gradient Descent:每次用一个小批量样本计算梯度,更新一次参数。
实际深度学习中通常使用 mini-batch。
7. 常见优化器
SGD(Stochastic Gradient Descent,随机梯度下降)
最基础的优化器。
Momentum(动量)
加入动量,减少震荡。
Adam(Adaptive Moment Estimation,自适应矩估计)
结合一阶矩和二阶矩估计,训练中最常用。
8. 正则化
为了防止过拟合,常见手段包括:
- L1 正则化:通过在损失函数中加入权重的绝对值之和,促使模型稀疏化。
- L2 正则化:通过在损失函数中加入权重的平方和,限制权重的大小。
- Dropout:在训练过程中随机将一部分神经元的输出设为 0,防止模型过度依赖某些特定的神经元。
- Data Augmentation(数据增强):通过对训练数据进行变换(如旋转、翻转、裁剪等),增加数据的多样性。
- Early Stopping(早停):在验证集上的性能不再提升时停止训练,防止模型在训练集上过拟合。
9. Batch Normalization(批归一化)
Batch Normalization 就是在神经网络中间层对特征做标准化,让数据分布更稳定,从而让模型训练更快、更稳。
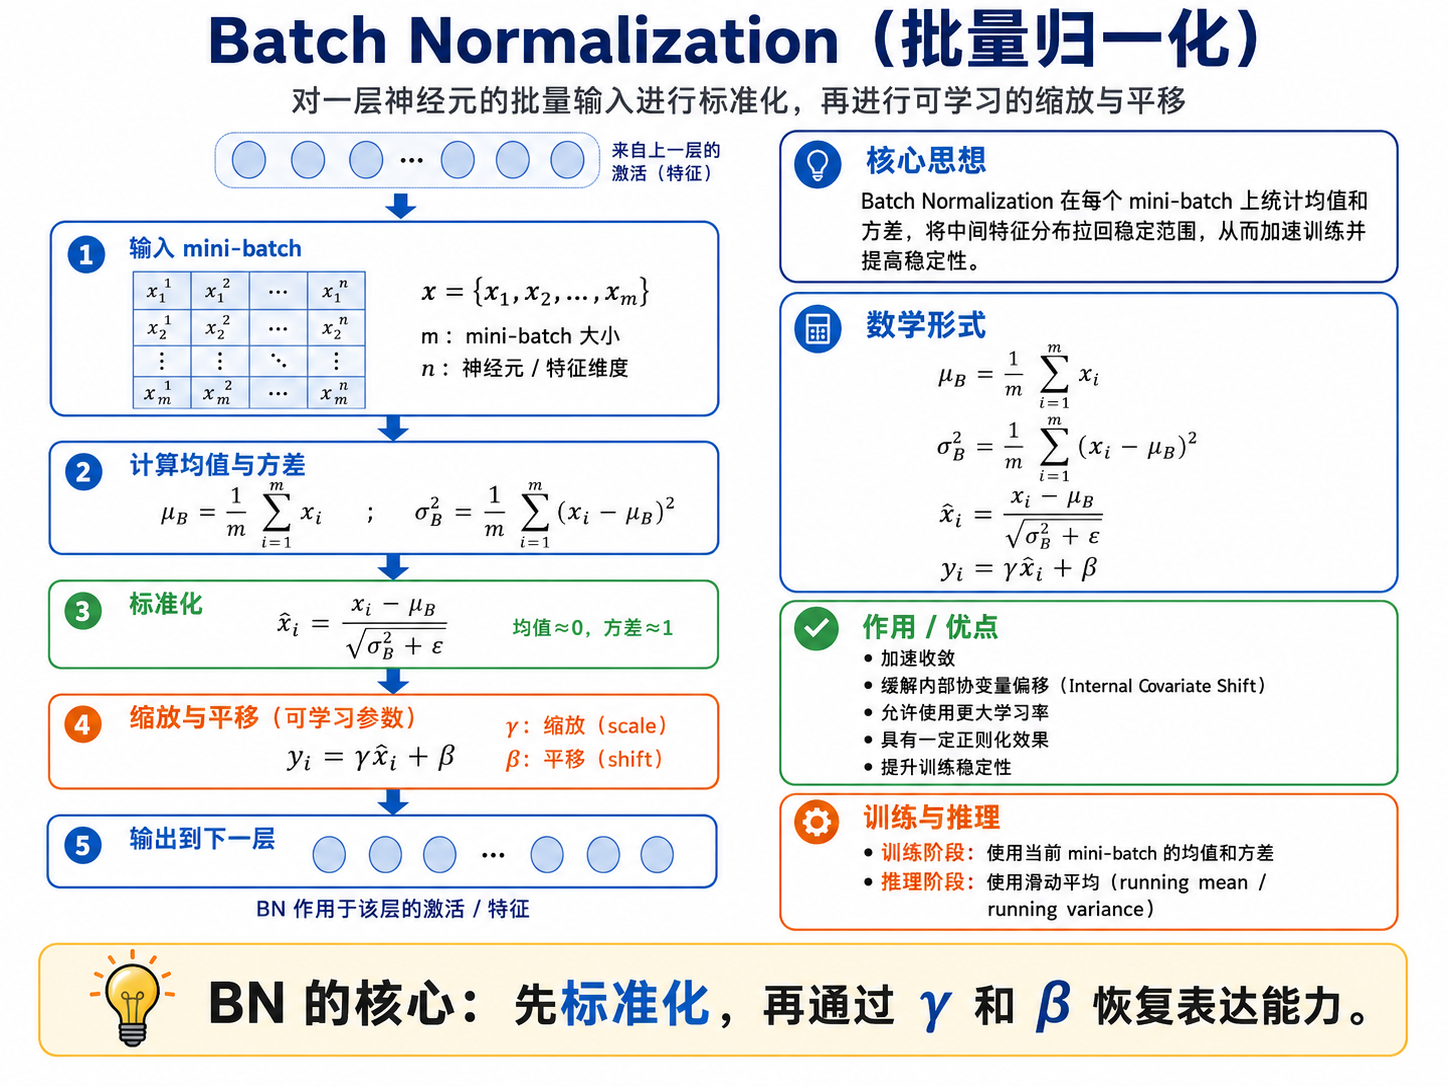
BN 的作用:
- 稳定训练
- 允许更大学习率
- 一定程度上起到正则化作用
10. 深度学习训练的一般流程
1
2
3
4
5
6
7
8
|
准备数据
  -> 构建 Dataset / DataLoader
  -> 定义模型
  -> 定义损失函数
  -> 定义优化器
  -> 训练循环
  -> 验证评估
  -> 保存模型
|
11. 一个最简单的神经网络例子
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
|
import torch
import torch.nn as nn
import torch.optim as optim

X = torch.tensor([[0.0, 0.0],
                  [0.0, 1.0],
                  [1.0, 0.0],
                  [1.0, 1.0]])
y = torch.tensor([[0.0], [1.0], [1.0], [0.0]])

model = nn.Sequential(
    nn.Linear(2, 8),
    nn.ReLU(),
    nn.Linear(8, 1),
    nn.Sigmoid()
)

criterion = nn.BCELoss()
optimizer = optim.Adam(model.parameters(), lr=0.01)

for epoch in range(5000):
    pred = model(X)
    loss = criterion(pred, y)

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

    if (epoch + 1) % 500 == 0:
        print(f"Epoch {epoch+1}, Loss: {loss.item():.4f}")

print("Predictions:")
print(model(X).detach())
|
这个例子实现了一个简单的 XOR 学习任务。它说明:
- 线性模型无法解决 XOR。
- 加入隐藏层和非线性激活后,网络能拟合非线性关系。
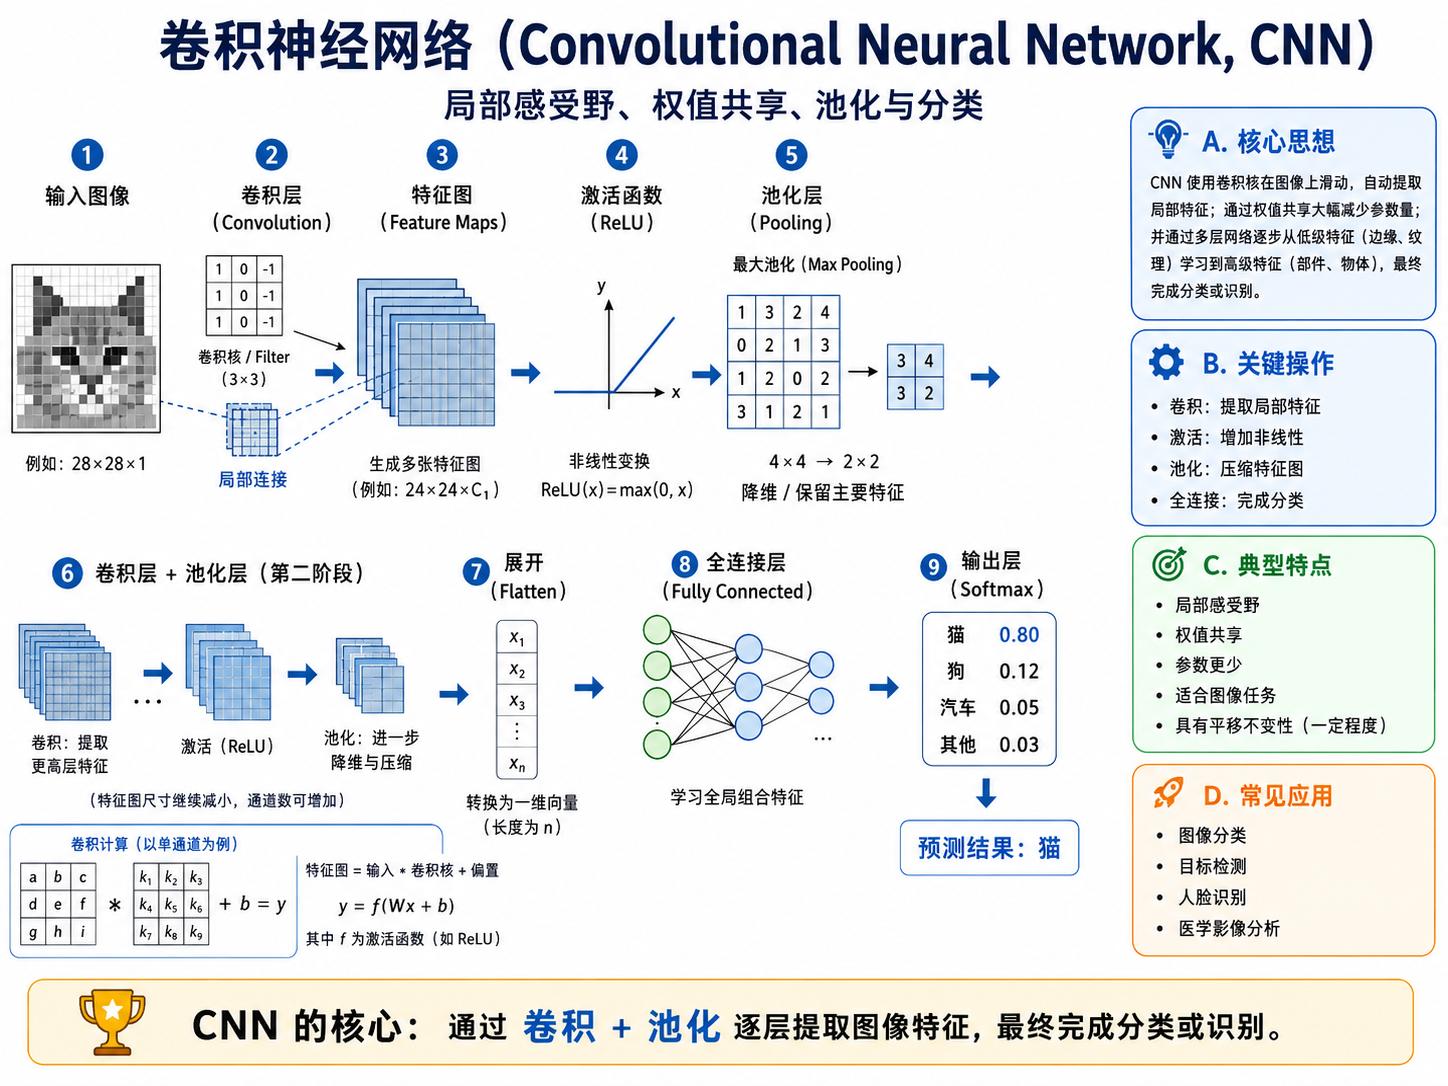
CNN:卷积神经网络
CNN 是图像任务的基础架构之一。即使在 Transformer 主导的今天,理解 CNN 仍然非常重要,因为它奠定了视觉建模的很多基本思想。
1. 为什么全连接网络不适合图像
假设输入一张 224 x 224 x 3 的彩色图片。
如果直接展平后送入全连接层,每个样本的参数就为:
$$
224 \times 224 \times 3 = 150528
$$
若隐藏层有 1000 个神经元,参数量大约是:
$$
150528 \times 1000
$$
这会导致参数量巨大,而且还丢失了图像的空间结构信息。
图像有几个天然特点:
- 局部区域往往比全局更重要。
- 同一种模式可能出现在不同位置。
- 邻近像素之间强相关。
CNN 正是围绕这些特点设计的。
2. CNN 的核心思想
CNN 的三大关键思想:
- 局部感受野(Local Receptive Field)
- 参数共享(Weight Sharing)
- 层次化特征学习(Hierarchical Feature Learning)
局部感受野
卷积核不会一次看整张图片,而是只看局部小区域,比如 3x3、5x5。
这样做的好处:
参数共享
同一个卷积核会在整张图上滑动。
这意味着:
- 无论边缘出现在左上角还是右下角,都用同一组参数检测
- 大幅减少参数量
层次化学习
浅层学到:
中层学到:
深层学到:
3. 卷积到底在做什么
给定输入特征图 $X$ 和卷积核 $K$,卷积操作可以写作:
$$
Y(i,j) = \sum_m \sum_n X(i+m, j+n)K(m,n)
$$
在深度学习框架中,通常实现的是“互相关”而不是严格数学意义上的翻转卷积,但工程上大家都习惯称为卷积。
4. 卷积层的关键超参数
卷积核大小 Kernel Size
常见:
现代网络中 3x3 最常见。
为什么卷积核的大小通常是奇数?因为这样可以有一个中心点,方便对称地处理边界。
步幅 Stride
卷积核每次移动多少格。
- stride = 1:细致扫描,可以保持空间尺寸。
- stride = 2:下采样,空间尺寸减半。
Padding
在边缘补 0,避免特征图过快缩小。
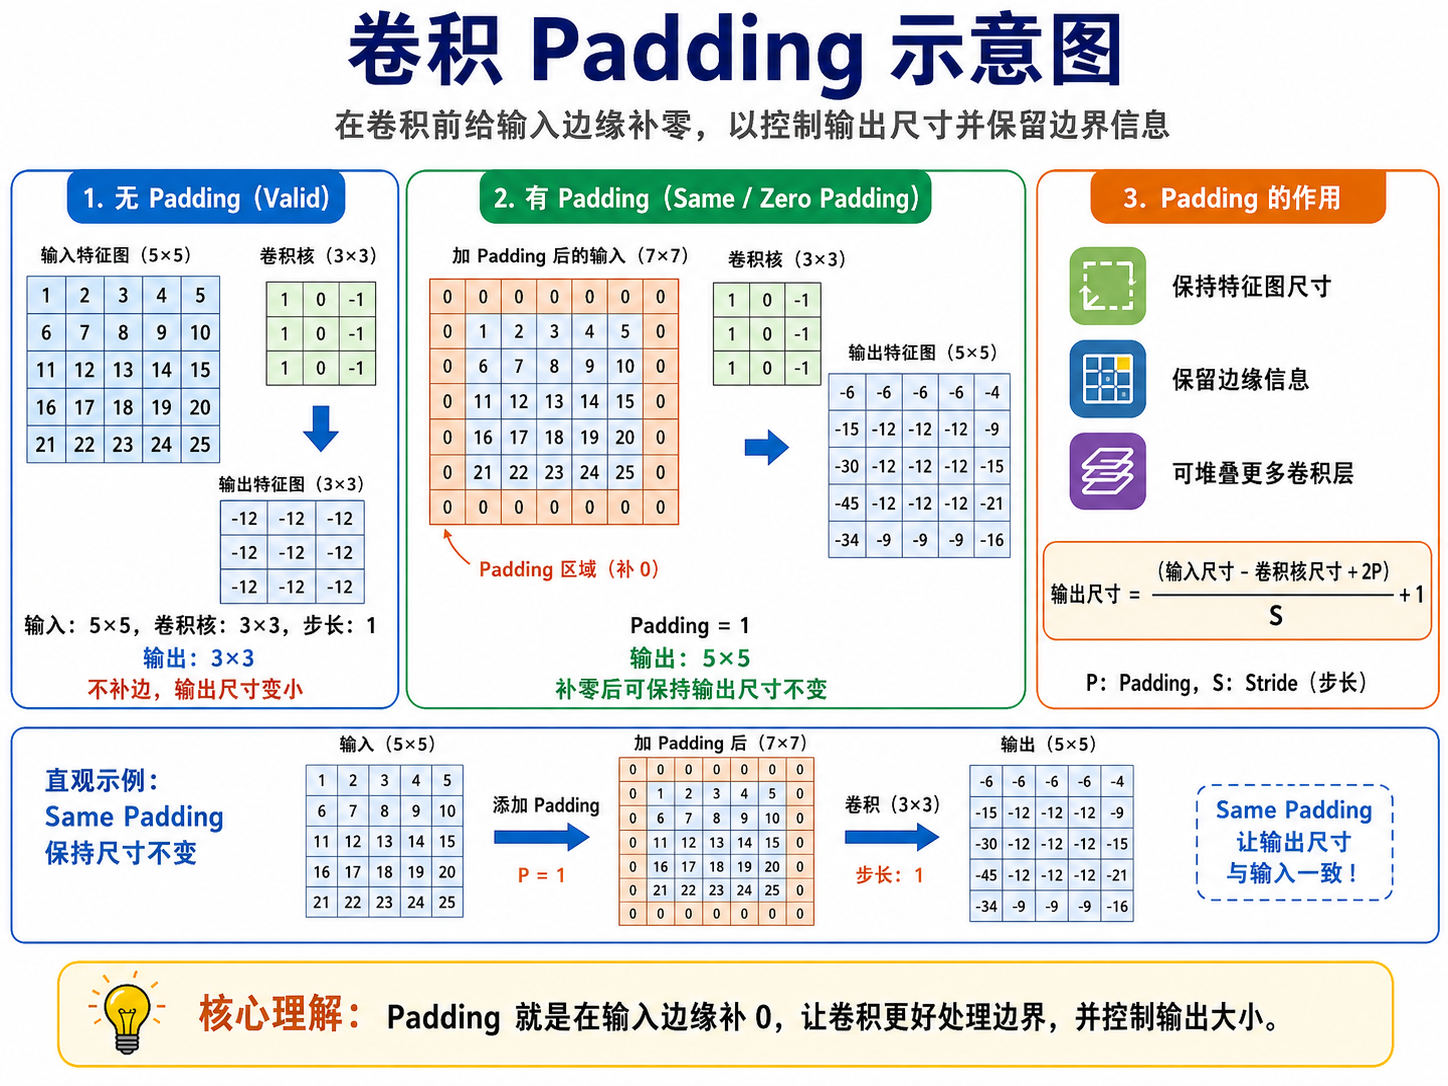
若输入高宽为 $H, W$,卷积核大小为 $K$,padding 为 $P$,stride 为 $S$,输出尺寸为:
$$
H_{out} = \left\lfloor \frac{H - K + 2P}{S} \right\rfloor + 1
$$
$$
W_{out} = \left\lfloor \frac{W - K + 2P}{S} \right\rfloor + 1
$$
后面的 +1 是因为卷积核的第一个位置也算一次。
输入通道与输出通道
彩色图像输入通常是 3 通道。
假设:
- 输入通道数为
C_in
- 输出通道数为
C_out
- 卷积核大小为
K x K
参数量为:
$$
C_{out} \times C_{in} \times K \times K + C_{out}
$$
5. 一个直观例子
输入:32 x 32 x 3
卷积层:16 个 3x3 卷积核,每个卷积核都会覆盖 3 个通道,stride=1,padding=1
输出:
因为 padding 保持了空间尺寸不变,而输出通道数由卷积核数量决定。
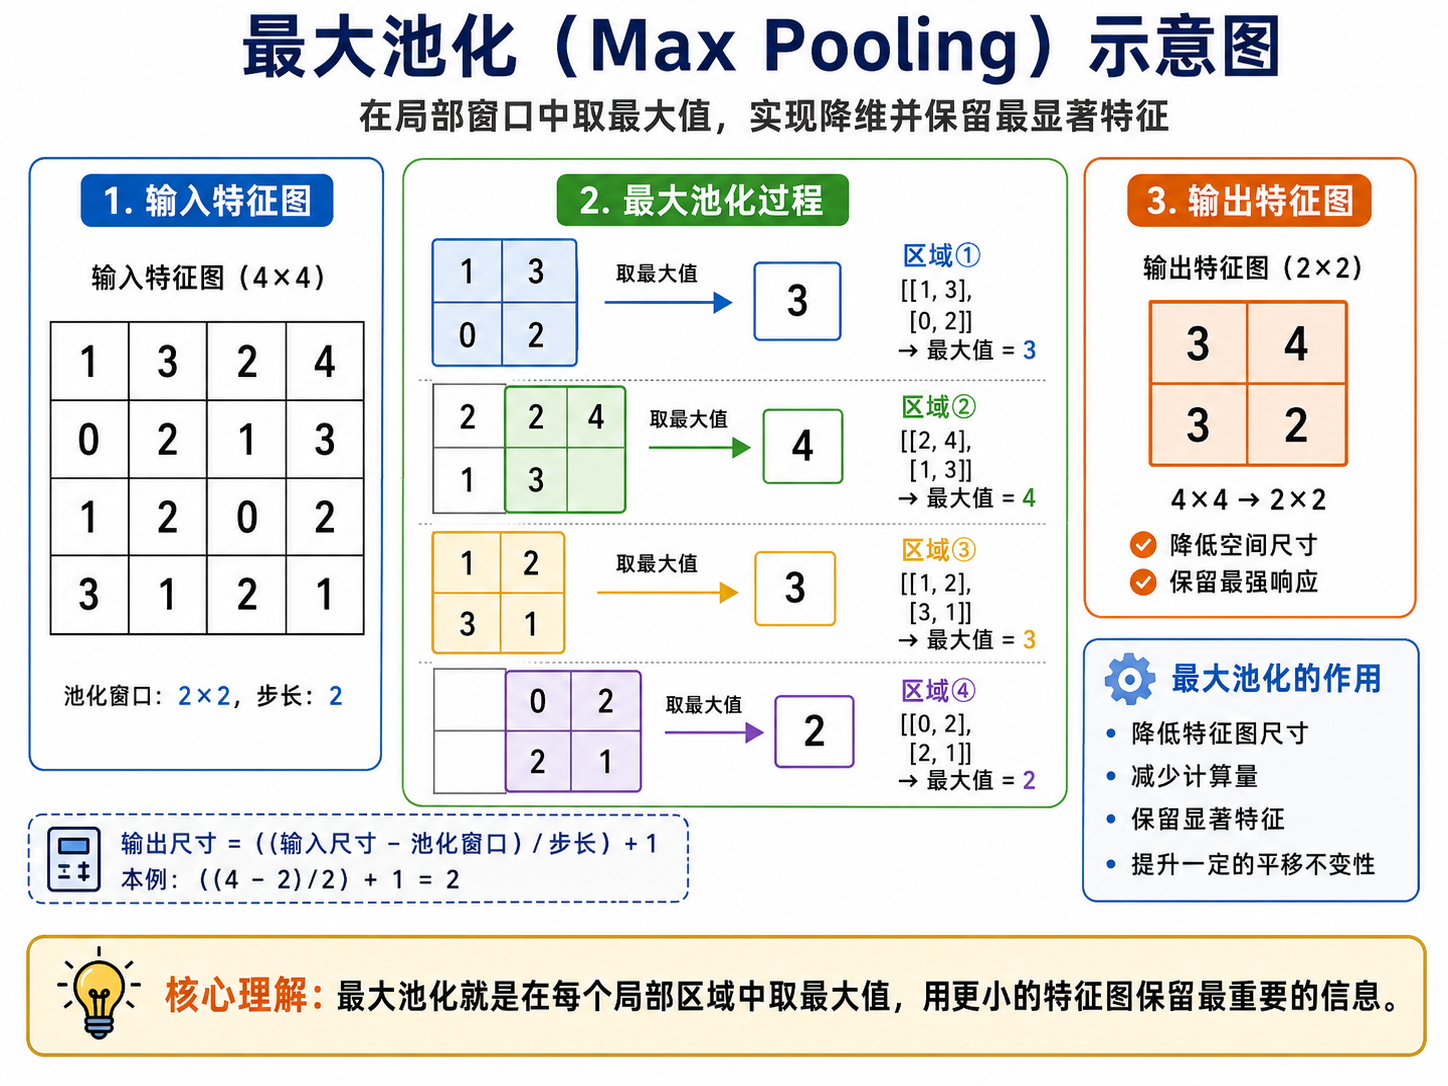
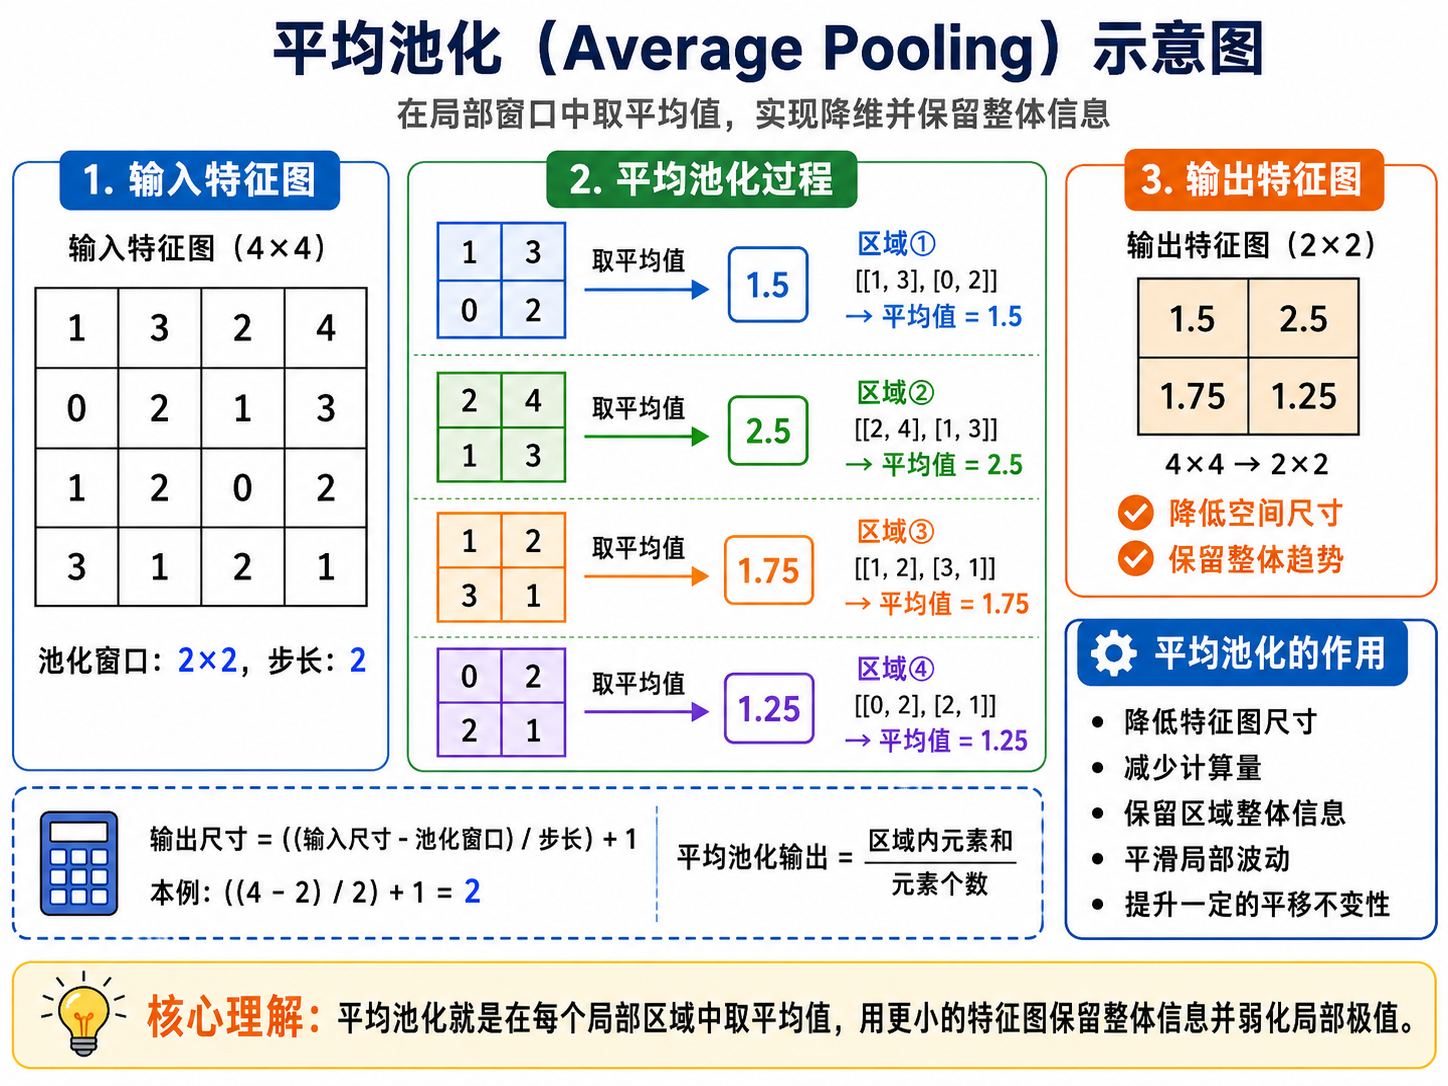
6. 池化层 Pooling
池化用于降低空间分辨率。
常见类型:
- Max Pooling(最大池化)
- Average Pooling(平均池化)
Max Pooling
从局部窗口中取最大值。
作用:
例如 2x2 最大池化,stride=2,会把宽高减半。
Average Pooling
从局部窗口中取平均值。
作用:
7. CNN 的典型结构
一个基础 CNN 往往是:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
|
输入
 -> 卷积
 -> 激活函数
 -> 卷积
 -> 激活函数
 -> 池化
 -> 多次重复
 -> 展平
 -> 全连接层
 -> 分类输出
|
8. 为什么 CNN 适合图像
CNN 对图像的优势来自归纳偏置(inductive bias):
- 假设图像局部结构重要
- 假设相同特征可在不同位置复用
这种先验在图像任务中非常合理,因此 CNN 在数据量不算极大的场景下经常训练更稳定。
9. 经典 CNN 家族简史
LeNet
最早成功的卷积网络之一,用于手写数字识别。
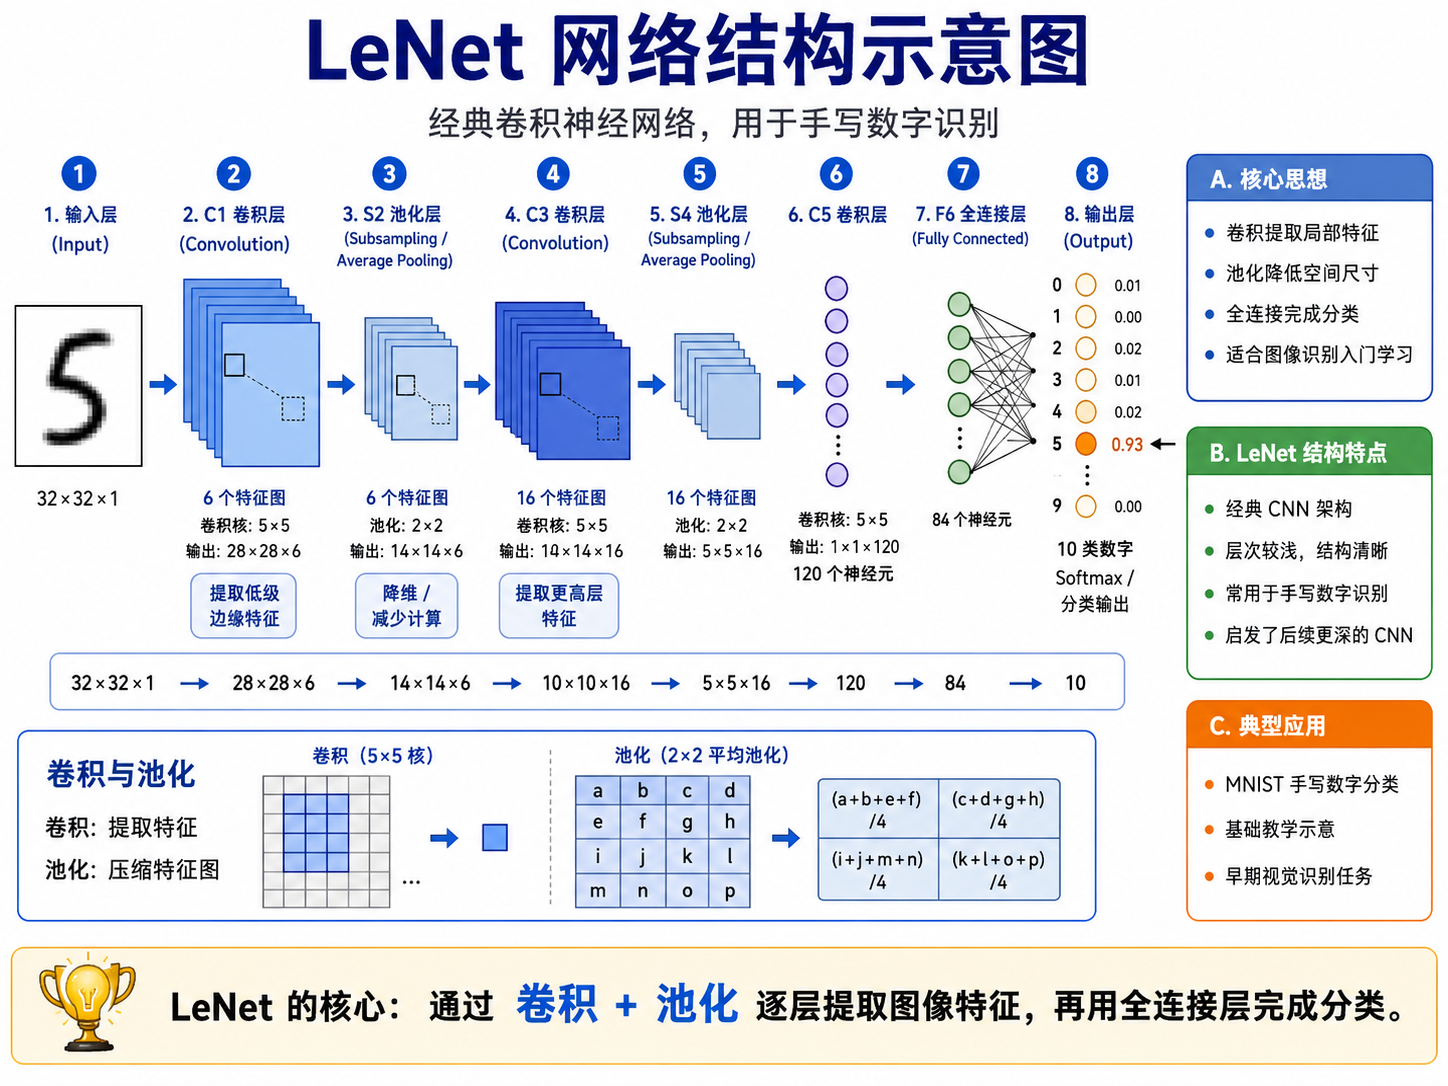
LeNet 的结构相对简单,主要由两层卷积和两层全连接组成。虽然在当时取得了不错的效果,但由于计算资源限制和数据集规模较小,LeNet 的影响力有限。
LeNet 的代码示例:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
|
import torch
import torch.nn as nn
import torch.nn.functional as F

class LeNet(nn.Module):
    # 定义网络结构,假设输入是 32x32x1 的灰度图像
    def __init__(self):
        super().__init__()
        self.conv1 = nn.Conv2d(1, 6, kernel_size=5) # 输入通道数为 1(灰度图),输出通道数为 6,卷积核大小为 5x5,得到 28x28x6 的特征图
        self.pool1 = nn.MaxPool2d(2, 2)
        self.conv2 = nn.Conv2d(6, 16, kernel_size=5) # 输入通道数为 6,输出通道数为 16,卷积核大小为 5x5,得到 14x14x16 的特征图
        self.pool2 = nn.MaxPool2d(2, 2)
        self.conv3 = nn.Conv2d(16, 120, kernel_size=5) # 输入通道数为 16,输出通道数为 120,卷积核大小为 5x5,得到 1x1x120 的特征图
        self.fc1 = nn.Linear(120, 84) # 输入维度为 120,输出维度为 84
        self.fc2 = nn.Linear(84, 10) # 输入维度为 84,输出维度为 10

    def forward(self, x):
        x = self.pool1(F.relu(self.conv1(x)))
        x = self.pool2(F.relu(self.conv2(x)))
        x = x.view(-1, 16 * 5 * 5)
        x = F.relu(self.conv3(x))
        x = F.relu(self.fc1(x))
        return self.fc2(x)
|
AlexNet
2012 年 ImageNet 大赛中爆火,推动深度学习重新进入主流。
关键贡献:
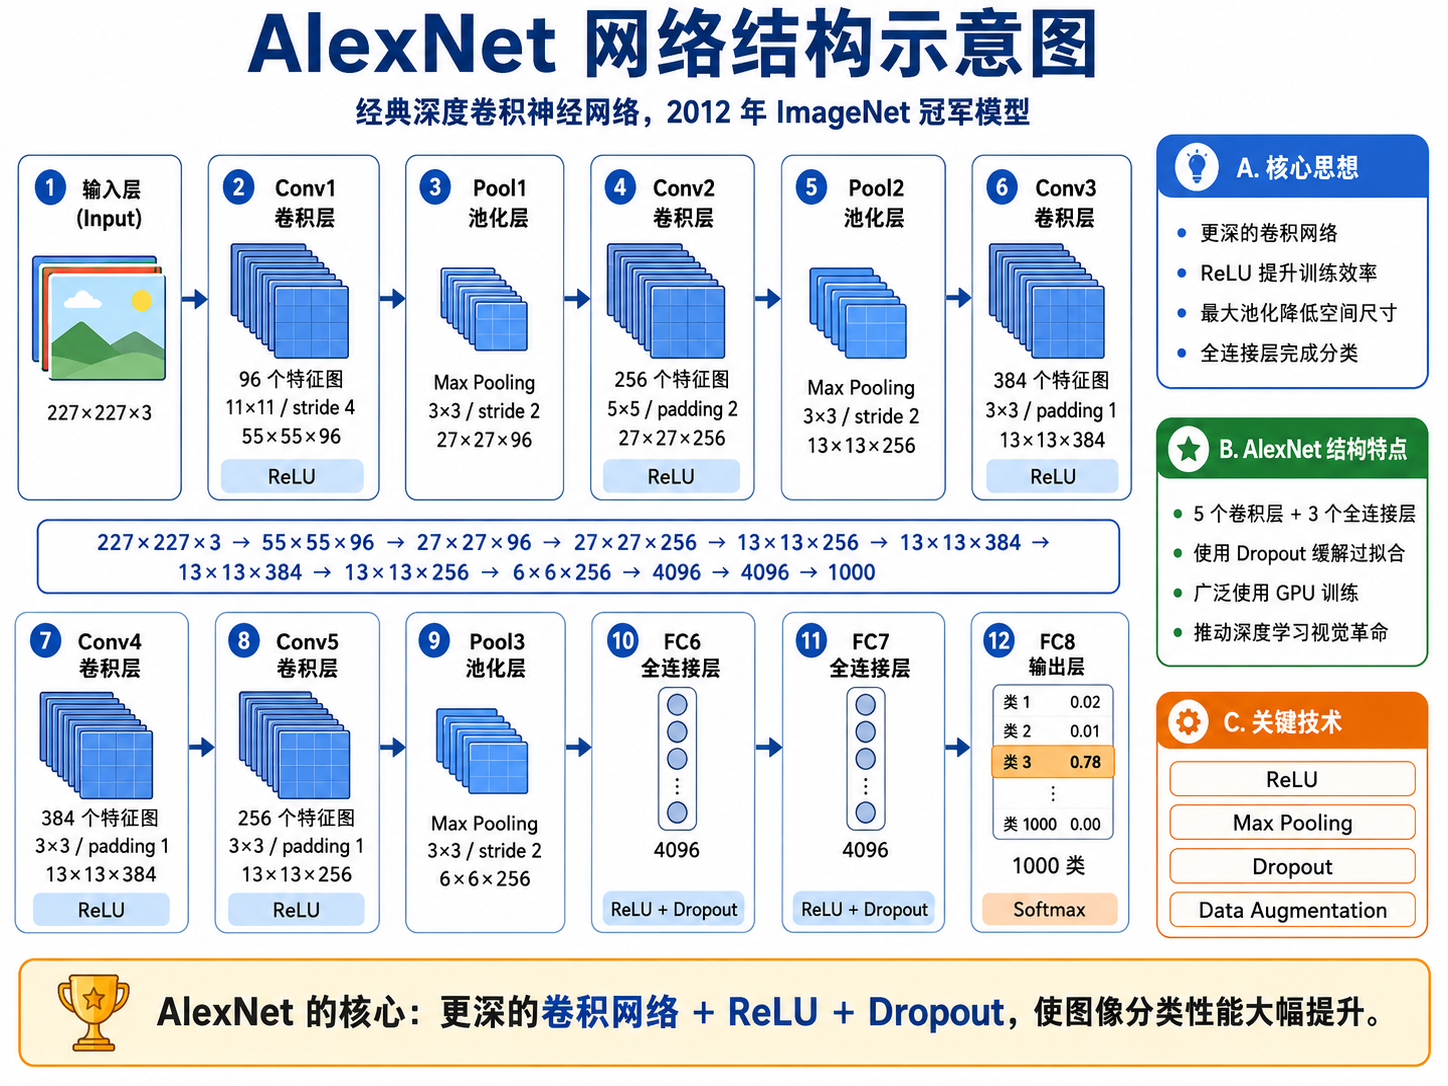
AlexNet 的结构相较于 LeNet 更加深层和复杂,包含了 5 层卷积和 3 层全连接层。AlexNet 的成功标志着深度学习在计算机视觉领域的崛起,极大地推动了后续研究的发展。
AlexNet 的代码示例:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
|
import torch
import torch.nn as nn

class AlexNet(nn.Module):
    # 定义网络结构,假设输入是 3x227x227 的彩色图像
    def __init__(self, num_classes=1000):
        super().__init__()
        # 卷积层部分,用于提取特征
        self.features = nn.Sequential(
            nn.Conv2d(3, 96, kernel_size=11, stride=4), # 输入通道数为 3(RGB 图像),输出通道数为 96,卷积核大小为 11x11,步幅为 4,得到 55x55x96 的特征图
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2), # 池化层,卷积核大小为 3x3,步幅为 2,得到 27x27x96 的特征图
            nn.Conv2d(96, 256, kernel_size=5, padding=2), # 输入通道数为 96,输出通道数为 256,卷积核大小为 5x5,填充为 2,得到 27x27x256 的特征图
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2), # 池化层,卷积核大小为 3x3,步幅为 2,得到 13x13x256 的特征图
            nn.Conv2d(256, 384, kernel_size=3, padding=1), # 输入通道数为 256,输出通道数为 384,卷积核大小为 3x3,填充为 1,得到 13x13x384 的特征图
            nn.ReLU(inplace=True),
            nn.Conv2d(384, 384, kernel_size=3, padding=1), # 输入通道数为 384,输出通道数为 384,卷积核大小为 3x3,填充为 1,得到 13x13x384 的特征图
            nn.ReLU(inplace=True),
            nn.Conv2d(384, 256, kernel_size=3, padding=1), # 输入通道数为 384,输出通道数为 256,卷积核大小为 3x3,填充为 1,得到 13x13x256 的特征图
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2) # 池化层,卷积核大小为 3x3,步幅为 2,得到 6x6x256 的特征图
        )
        # 全连接层部分,用于分类
        self.classifier = nn.Sequential(
            nn.Dropout(),   # 随机丢弃部分神经元,防止过拟合
            nn.Linear(256 * 6 * 6, 4096), # 输入维度根据前面卷积层的输出特征图大小计算得出,这里假设输入图像大小为227x227
            nn.ReLU(inplace=True),
            nn.Dropout(),
            nn.Linear(4096, 4096),
            nn.ReLU(inplace=True),
            nn.Linear(4096, num_classes) # 输出维度等于类别数
        )

    def forward(self, x):
        x = self.features(x)
        x = x.view(x.size(0), 256 * 6 * 6)
        x = self.classifier(x)
        return x
|
VGG(Visual Geometry Group,视觉几何组)
强调使用大量 3x3 卷积堆叠。
优点:
缺点:
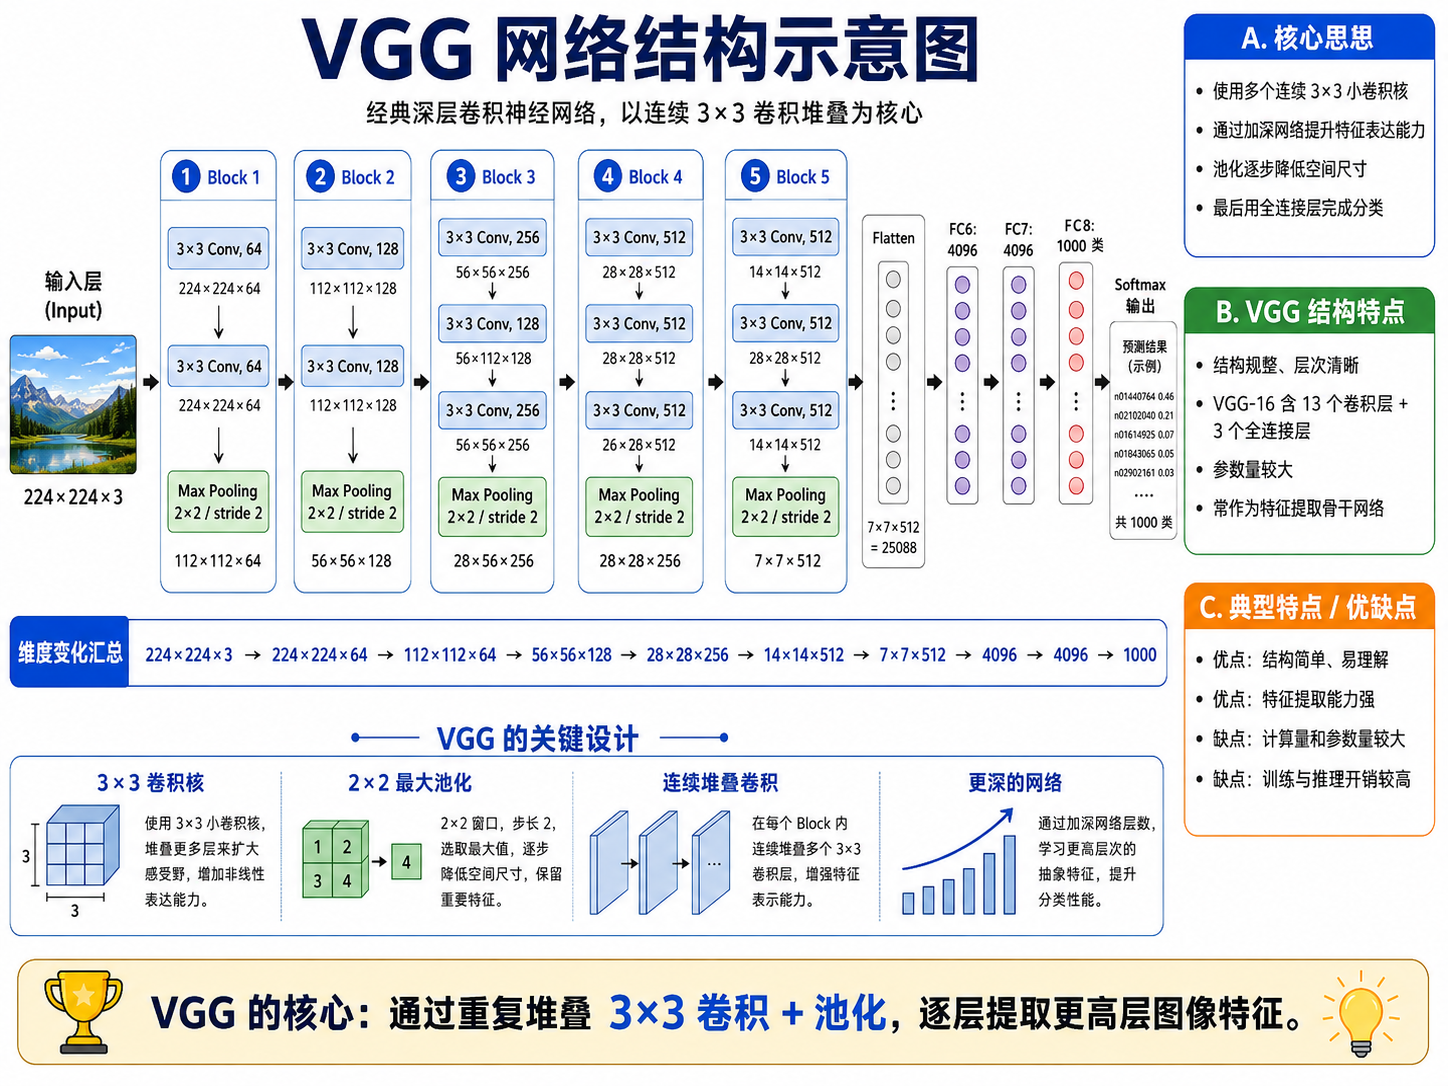
VGG 的结构非常简单,主要由多个 3x3 卷积层和池化层交替组成,最后是几个全连接层。VGG 的成功在于证明了深层网络的有效性,并且通过使用小卷积核来减少参数量。
VGG 的代码示例:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
|
import torch
import torch.nn as nn


class VGG16(nn.Module):
    def __init__(self, num_classes=1000):
        super(VGG16, self).__init__()

        # 卷积特征提取部分
        self.features = nn.Sequential(
            # Block 1: 224×224×3 -> 112×112×64
            nn.Conv2d(3, 64, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(64, 64, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),

            # Block 2: 112×112×64 -> 56×56×128
            nn.Conv2d(64, 128, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(128, 128, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),

            # Block 3: 56×56×128 -> 28×28×256
            nn.Conv2d(128, 256, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(256, 256, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(256, 256, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),

            # Block 4: 28×28×256 -> 14×14×512
            nn.Conv2d(256, 512, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(512, 512, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(512, 512, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),

            # Block 5: 14×14×512 -> 7×7×512
            nn.Conv2d(512, 512, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(512, 512, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(512, 512, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),
        )

        # 自适应池化,保证进入全连接层前是 7×7×512
        self.avgpool = nn.AdaptiveAvgPool2d((7, 7))

        # 分类器部分
        self.classifier = nn.Sequential(
            nn.Linear(512 * 7 * 7, 4096),
            nn.ReLU(inplace=True),
            nn.Dropout(p=0.5),

            nn.Linear(4096, 4096),
            nn.ReLU(inplace=True),
            nn.Dropout(p=0.5),

            nn.Linear(4096, num_classes)
        )

    def forward(self, x):
        # 卷积层提取图像特征
        x = self.features(x)

        # 调整特征图尺寸为 7×7
        x = self.avgpool(x)

        # 展平成一维向量,送入全连接层
        x = torch.flatten(x, start_dim=1)

        # 分类输出
        x = self.classifier(x)
        return x
|
GoogLeNet / Inception
通过多尺度卷积并行提取特征,提高效率。
10. CNN 中的常见设计技巧
小卷积核堆叠替代大卷积核
两个 3x3 卷积堆叠的感受野接近一个 5x5,但参数更少,还多了非线性。
逐步增加通道数
随着特征图变小,通道数通常会增加,例如:
1
|
64 -> 128 -> 256 -> 512
|
使用 BN
卷积后常接:
1
|
Conv -> BatchNorm -> ReLU
|
11. CNN 的前向过程示意
假设输入一张猫的图片:
- 第一层卷积检测边缘。
- 第二层卷积组合边缘形成纹理和简单图形。
- 更深层把耳朵、眼睛、脸部局部组合起来。
- 最终分类层判断“这是猫”。
12. CNN 的优缺点
优点
- 对图像结构建模有效
- 参数共享降低复杂度
- 在视觉任务中长期有效
缺点
- 长距离依赖建模不如注意力机制直接
- 对全局关系的表达相对间接
- 深层网络训练可能困难
13. 用 PyTorch 从零写一个简单 CNN
下面给出一个适合初学者理解的 CNN 分类模型。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
|
import torch
import torch.nn as nn


class SimpleCNN(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(1, 32, kernel_size=3, padding=1),
            nn.BatchNorm2d(32),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2),

            nn.Conv2d(32, 64, kernel_size=3, padding=1),
            nn.BatchNorm2d(64),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2),

            nn.Conv2d(64, 128, kernel_size=3, padding=1),
            nn.BatchNorm2d(128),
            nn.ReLU(),
            nn.AdaptiveAvgPool2d((1, 1))
        )

        self.classifier = nn.Linear(128, num_classes)

    def forward(self, x):
        x = self.features(x)
        x = torch.flatten(x, 1)
        x = self.classifier(x)
        return x


if __name__ == "__main__":
    model = SimpleCNN(num_classes=10)
    x = torch.randn(8, 1, 28, 28)
    y = model(x)
    print(y.shape)  # [8, 10]
|
14. 训练 CNN 的示例代码
下面给出一个基于 MNIST 的完整训练例子。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
|
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms


class SimpleCNN(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(1, 32, kernel_size=3, padding=1),
            nn.BatchNorm2d(32),
            nn.ReLU(),
            nn.MaxPool2d(2),

            nn.Conv2d(32, 64, kernel_size=3, padding=1),
            nn.BatchNorm2d(64),
            nn.ReLU(),
            nn.MaxPool2d(2),

            nn.Conv2d(64, 128, kernel_size=3, padding=1),
            nn.BatchNorm2d(128),
            nn.ReLU(),
            nn.AdaptiveAvgPool2d((1, 1))
        )
        self.fc = nn.Linear(128, num_classes)

    def forward(self, x):
        x = self.features(x)
        x = torch.flatten(x, 1)
        return self.fc(x)


device = "cuda" if torch.cuda.is_available() else "cpu"

transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.1307,), (0.3081,))
])

train_dataset = datasets.MNIST(root="./data", train=True, download=True, transform=transform)
test_dataset = datasets.MNIST(root="./data", train=False, download=True, transform=transform)

train_loader = DataLoader(train_dataset, batch_size=128, shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=256, shuffle=False)

model = SimpleCNN().to(device)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=1e-3)

for epoch in range(5):
    model.train()
    total_loss = 0.0
    correct = 0
    total = 0

    for images, labels in train_loader:
        images, labels = images.to(device), labels.to(device)

        logits = model(images)
        loss = criterion(logits, labels)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        total_loss += loss.item() * images.size(0)
        pred = logits.argmax(dim=1)
        correct += (pred == labels).sum().item()
        total += labels.size(0)

    train_loss = total_loss / total
    train_acc = correct / total

    model.eval()
    correct = 0
    total = 0
    with torch.no_grad():
        for images, labels in test_loader:
            images, labels = images.to(device), labels.to(device)
            logits = model(images)
            pred = logits.argmax(dim=1)
            correct += (pred == labels).sum().item()
            total += labels.size(0)

    test_acc = correct / total
    print(f"epoch={epoch+1}, train_loss={train_loss:.4f}, train_acc={train_acc:.4f}, test_acc={test_acc:.4f}")
|
15. CNN 中常见问题
问题 1:卷积核越大越好吗
不是。卷积核越大,参数越多,计算成本越高。现代网络往往偏向使用小卷积核反复堆叠。
问题 2:池化一定需要吗
不一定。很多现代网络会用 stride convolution 替代部分池化。
问题 3:为什么浅层卷积学边缘
因为边缘本身就是局部模式,而卷积正好擅长检测局部模式。
16. CNN 的学习重点
如果你想真正掌握 CNN,建议一定要搞懂以下几点:
- 卷积输出尺寸如何计算。
- 卷积层参数量如何计算。
- 为什么局部感受野和参数共享适合图像。
- 池化层和 stride 的区别。
- 为什么深层 CNN 能形成层次化特征。
17. CNN 中的参数量怎么计算
这一点很重要,因为很多初学者能把模型跑起来,但不知道哪里最耗参数、哪里最耗计算。
卷积层参数量
卷积层参数量的计算公式为:
$$
\text{参数量} = C_{out} \times C_{in} \times K \times K + C_{out}
$$
假设卷积层配置如下:
- 输入通道数:
C_in = 3
- 输出通道数:
C_out = 64
- 卷积核大小:
3 x 3
那么参数量为:
$$
64 \times 3 \times 3 \times 3 + 64 = 1792
$$
解释:第一个乘积表示每个输出通道与输入通道的卷积操作参数,第二个加法表示每个输出通道的偏置项。
如果不带 bias,则是:
$$
64 \times 3 \times 3 \times 3 = 1728
$$
全连接层参数量
全连接层参数量的计算公式为:
$$
\text{参数量} = \text{输入维度} \times \text{输出维度} + \text{输出维度}
$$
如果全连接层输入维度 1024,输出维度 100,则参数量:
$$
1024 \times 100 + 100 = 102500
$$
你会发现,全连接层的参数量通常非常大,这也是很多现代 CNN 倾向于减少大型全连接层、改用全局平均池化的原因。
18. CNN 特征图尺寸变化的完整例子
下面我们手动推一次典型图像分类网络的尺寸变化。
输入图像:
经过以下层:
Conv(3 -> 64, kernel=7, stride=2, padding=3)MaxPool(kernel=3, stride=2, padding=1)Conv(64 -> 128, kernel=3, stride=1, padding=1)MaxPool(kernel=2, stride=2)
第一步:7x7 卷积
输出高宽:
$$
\left\lfloor \frac{224 - 7 + 2 \times 3}{2} \right\rfloor + 1 = 112
$$
输出:
第二步:3x3 最大池化
输出高宽:
$$
\left\lfloor \frac{112 - 3 + 2 \times 1}{2} \right\rfloor + 1 = 56
$$
输出:
第三步:3x3 卷积,padding=1,stride=1
输出高宽:
$$
\left\lfloor \frac{56 - 3 + 2 \times 1}{1} \right\rfloor + 1 = 56
$$
空间尺寸不变:
第四步:2x2 池化,stride=2
输出高宽:
$$
\left\lfloor \frac{56 - 2}{2} \right\rfloor + 1 = 28
$$
输出:
这类推导你一定要能手算,因为后面无论是自己搭网络还是读论文,都会频繁遇到。
19. 感受野 Receptive Field
感受野是指某一层某个神经元在原始输入上“能看到”的区域大小。
直觉上:
- 浅层感受野小,只看局部
- 深层感受野大,能看更大范围
为什么这很重要?
因为物体识别往往需要更大范围的上下文信息。
卷积网络通过不断堆叠卷积和池化,让感受野逐步增大。
例如连续两个 3x3 卷积,第二层神经元在原图上的感受野其实已经大于 3x3。
这也是“小卷积核堆叠”有效的重要原因之一。
20. 1x1 卷积有什么用
很多初学者看到 1x1 conv 会困惑:这不是只看一个点吗,为什么有用?
1x1 卷积虽然不扩大空间感受野,但它可以:
- 在通道维度做线性组合
- 改变通道数
- 降低参数和计算
- 提升网络非线性表达能力
例如输入是 H x W x 256,你可以用 1x1 卷积变成 H x W x 64,起到压缩通道的作用。
21. CNN 中常见增强与正则化
训练视觉模型时,数据增强非常关键。
常见增强:
- Random Crop(随机裁剪):随机裁剪图像的一部分,增加模型对位置变化的鲁棒性。
- Horizontal Flip(水平翻转):随机水平翻转图像,增强模型对左右对称的理解。
- Color Jitter(颜色扰动):随机调整图像的亮度、对比度、饱和度等,增强模型对颜色变化的适应能力。
- Random Rotation(随机旋转):随机旋转图像,增加模型对角度变化的鲁棒性。
- Cutout(随机遮挡):随机遮挡图像的一部分,增强模型对局部缺失的鲁棒性。
- Mixup(混合样本):将两个样本线性组合,生成新的训练样本。
- CutMix(混合样本并遮挡):结合 Mixup 和 Cutout 的思想,生成混合样本并进行遮挡。
这些增强的目标是提高泛化能力,减少模型对训练样本细节的过拟合。
22. CNN 训练中常见故障排查
现象 1:训练集准确率上不去
可能原因:
- 学习率过大或过小
- 模型容量不足
- 数据预处理错误
- 标签错位
现象 2:训练集很高,验证集很低
通常是过拟合。
可以尝试:
- 加强数据增强
- 使用 Dropout / Weight Decay
- 降低模型复杂度
- 增加训练数据
现象 3:loss 变成 NaN
常见原因:
- 学习率过大
- 数值不稳定
- 输入中有异常值
- softmax / log 实现不当
23. 一个更贴近实战的 CNN 模板
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
|
import torch
import torch.nn as nn


class ConvBNReLU(nn.Module):
    def __init__(self, in_channels, out_channels, kernel_size=3, stride=1, padding=1):
        super().__init__()
        self.block = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, kernel_size, stride, padding, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True)
        )

    def forward(self, x):
        return self.block(x)


class BetterCNN(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        self.stage1 = nn.Sequential(
            ConvBNReLU(3, 64),
            ConvBNReLU(64, 64),
            nn.MaxPool2d(2)
        )
        self.stage2 = nn.Sequential(
            ConvBNReLU(64, 128),
            ConvBNReLU(128, 128),
            nn.MaxPool2d(2)
        )
        self.stage3 = nn.Sequential(
            ConvBNReLU(128, 256),
            ConvBNReLU(256, 256),
            nn.AdaptiveAvgPool2d((1, 1))
        )
        self.classifier = nn.Linear(256, num_classes)

    def forward(self, x):
        x = self.stage1(x)
        x = self.stage2(x)
        x = self.stage3(x)
        x = torch.flatten(x, 1)
        return self.classifier(x)
|
这类模板比最初学时的“卷积 + 池化 + 全连接”更接近常见工程写法。
ResNet:残差网络
ResNet 是深度学习历史上最重要的架构之一。它不仅是一个“更深的 CNN”,更重要的是它提供了一种解决深层网络训练困难的关键思想:残差学习(Residual Learning)。
1. 为什么需要 ResNet
理论上,网络越深,表达能力越强。
但实际中,简单地把网络层数加深,常常会出现两个问题:
- 梯度消失 / 梯度爆炸
- 退化问题(Degradation Problem)
退化问题是什么
退化问题不是过拟合,而是:
- 更深的网络训练误差反而更高,不只是验证集,而是训练集的误差也更高了。
- 说明优化变得困难了
**也就是说,退化问题主要是“深层网络不好优化”,不是泛化能力差。**直觉上,如果多加几层没用,模型至少应该学成恒等映射,不比浅层差。但普通深层网络很难自动学到这种“啥都不做”的行为。
2. 残差学习的核心思想
假设我们本来想学习一个映射:
$$
H(x)
$$
ResNet 不直接学习 $H(x)$,而是学习残差:
$$
F(x) = H(x) - x
$$
于是原映射变为:
$$
H(x) = F(x) + x
$$
这就是跳跃连接(skip connection)或捷径连接(shortcut connection)的来源。
3. 为什么残差更容易学
如果最优映射接近恒等映射,那么:
$$
H(x) \approx x
$$
此时只需要让:
$$
F(x) \approx 0
$$
就可以了。
学习“接近 0 的残差”通常比直接拟合复杂映射更容易。
4. 残差块的基本结构
一个基础残差块通常是:
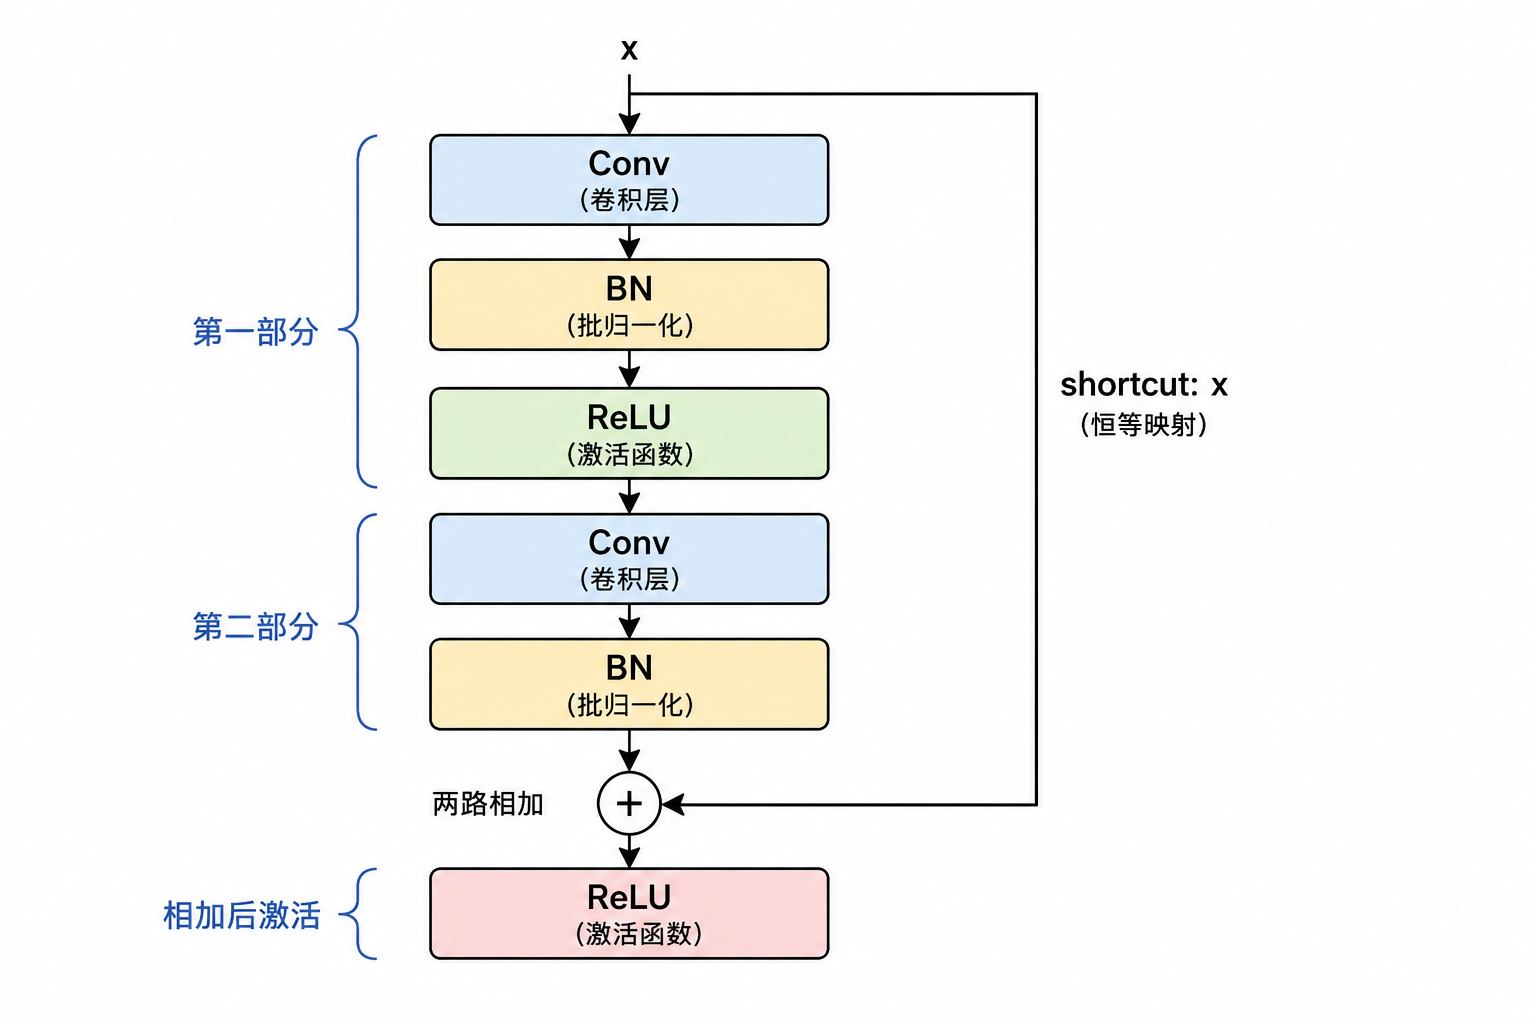
公式写作:
$$
y = F(x, W) + x
$$
再经过激活函数:
$$
out = \text{ReLU}(y)
$$
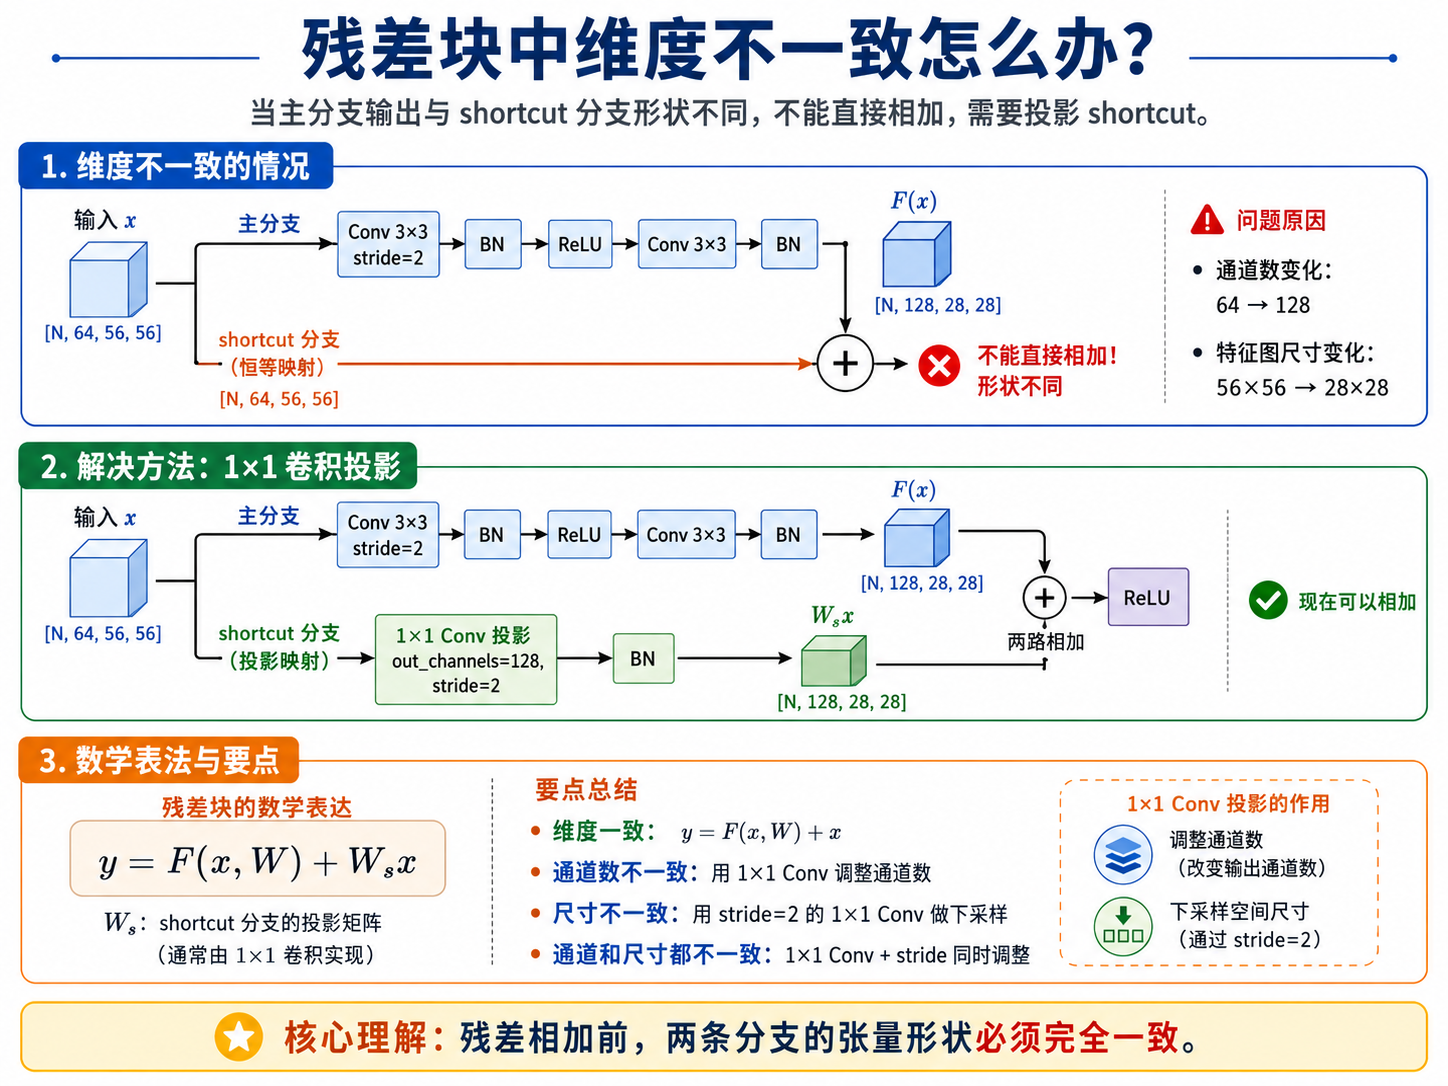
5. 如果维度不一致怎么办
如果输入和输出维度不同,比如:
就不能直接相加。
这时通常使用 1x1 卷积对 shortcut 分支进行投影:
$$
y = F(x, W) + W_s x
$$
其中 $W_s$ 是 shortcut 分支的投影矩阵。
6. ResNet 的意义不只是“更深”
ResNet 的价值有三层:
- 让超深网络可训练。
- 残差连接成为后续许多网络的标准组件。
- 它把“信息直接流动”的思想引入主流架构。
今天无论是视觉模型、语音模型还是 Transformer,残差连接都极其常见。
7. Basic Block 与 Bottleneck
Basic Block
常用于 ResNet-18 / ResNet-34。
结构大致是:
作用:
优点:
Bottleneck Block
常用于更深的网络,如 ResNet-50 / 101 / 152。
结构为:
1
|
1x1 Conv -> 3x3 Conv -> 1x1 Conv
|
作用:
- 第一个
1x1 降维
- 中间
3x3 做空间卷积
- 最后
1x1 升维
优点:
8. ResNet 的经典层数
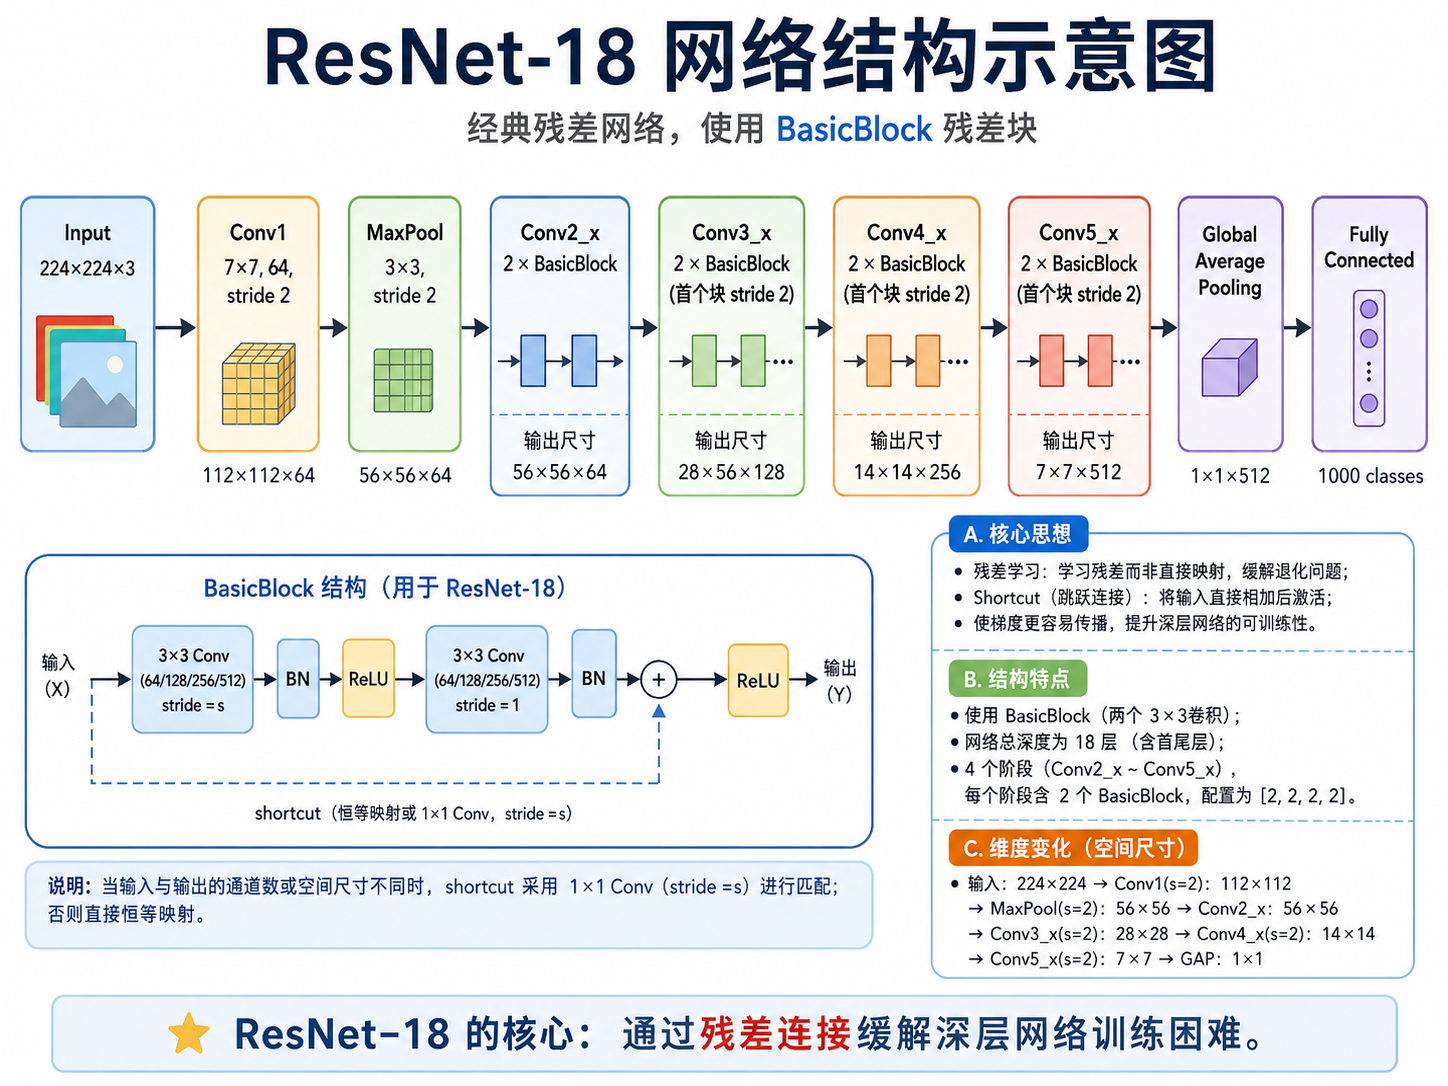
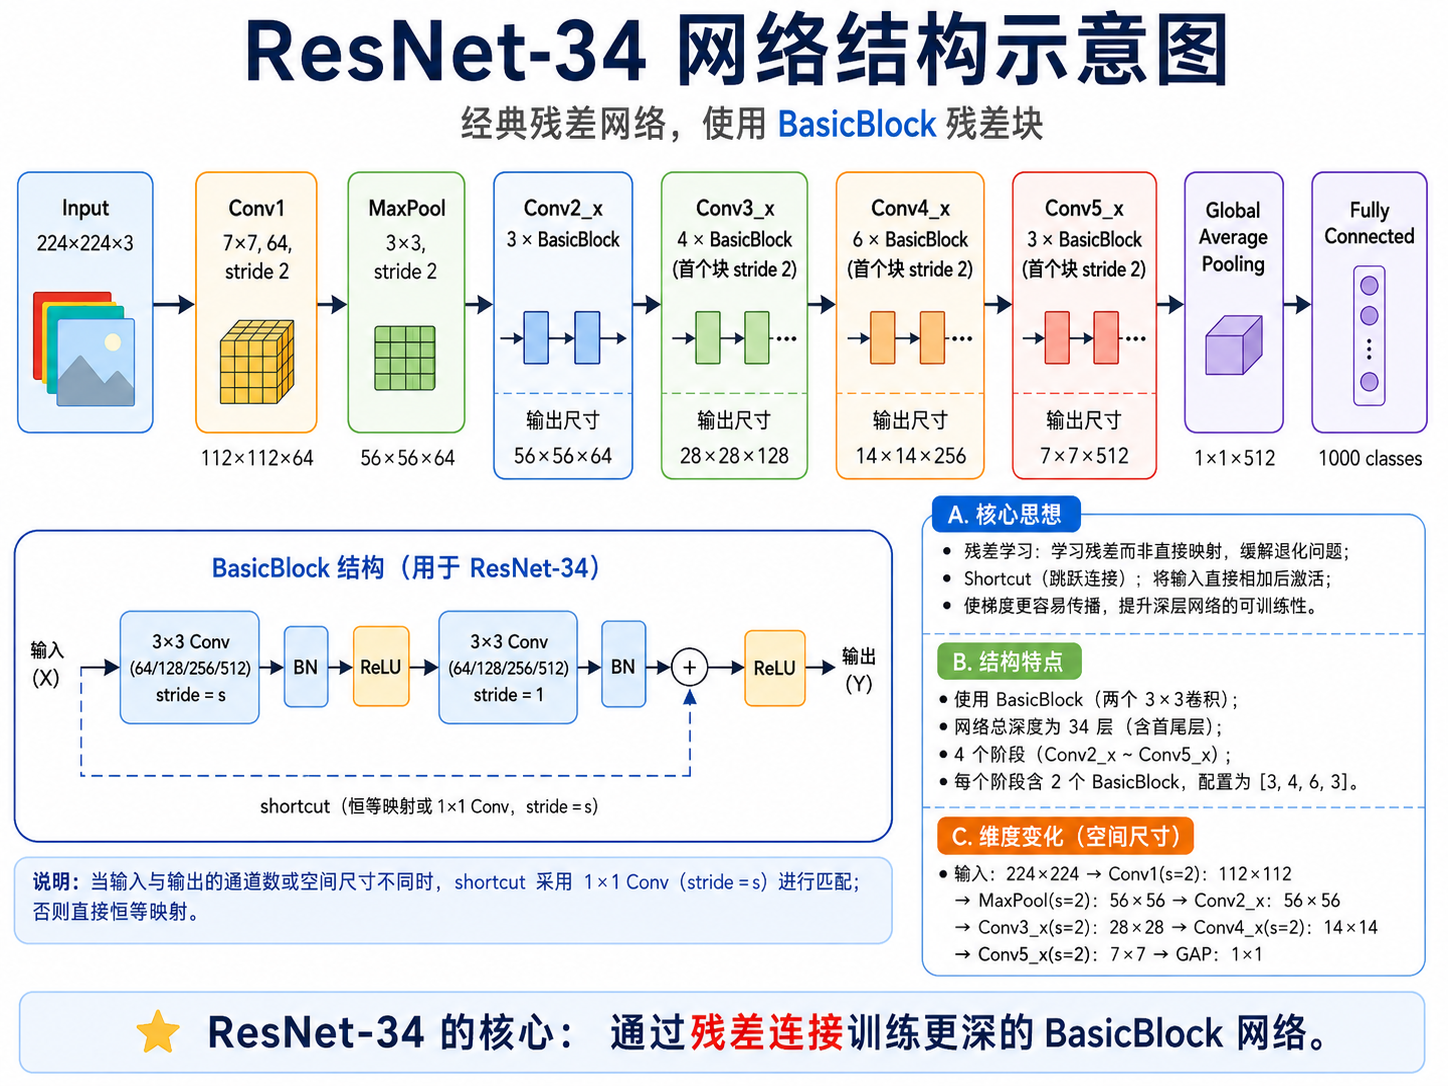
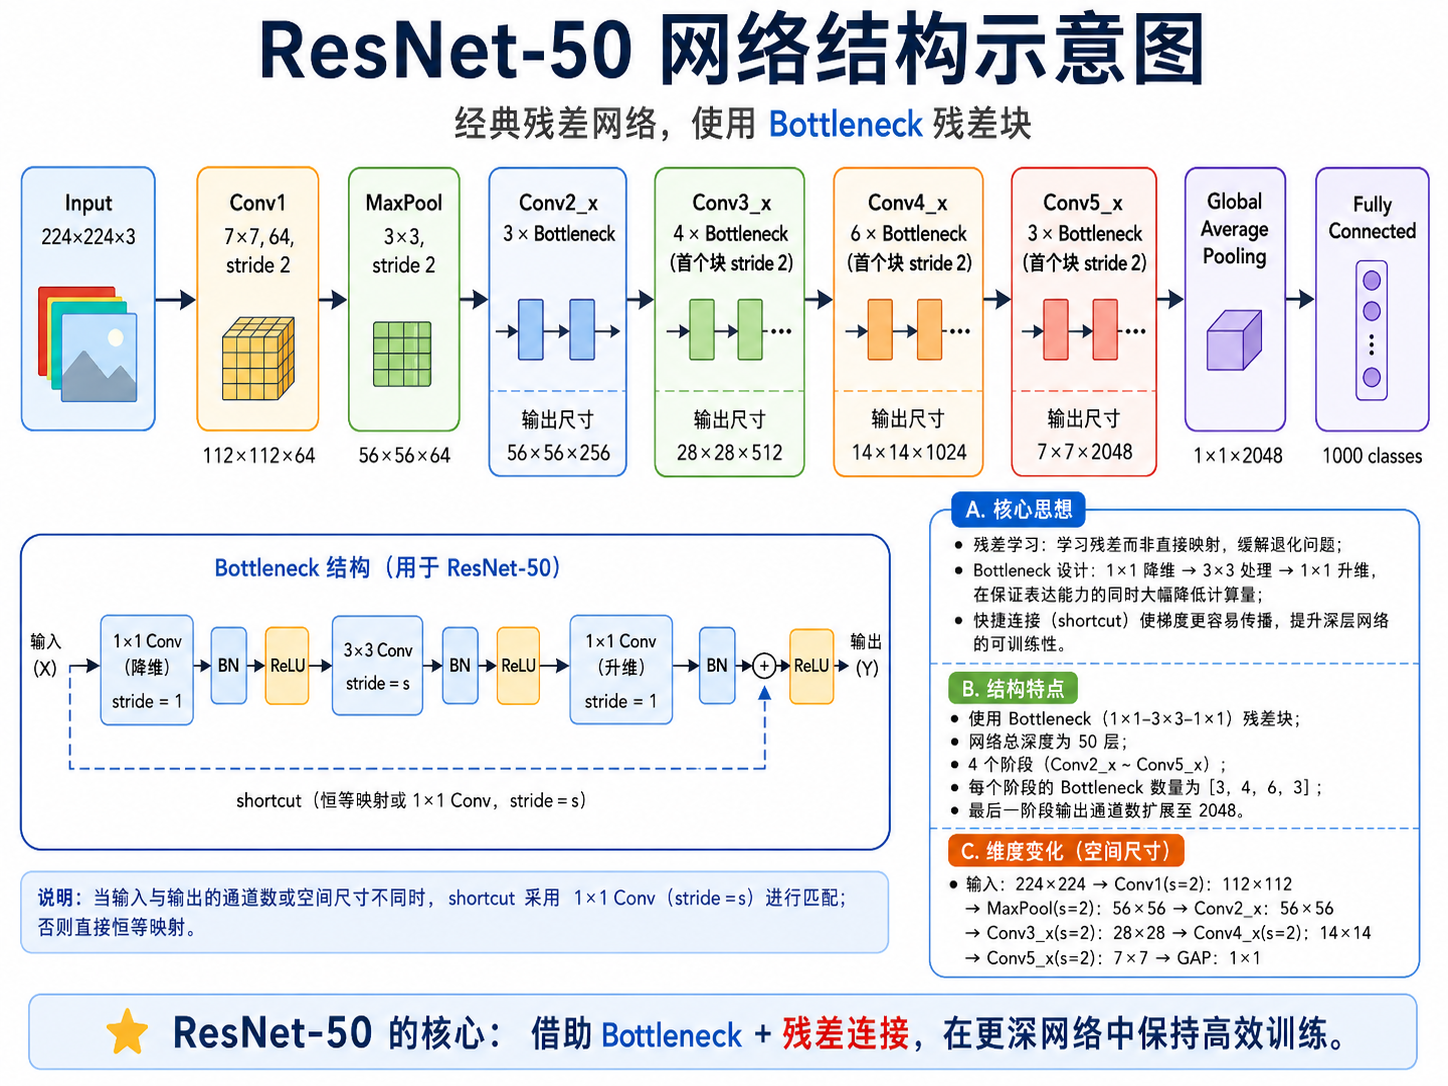
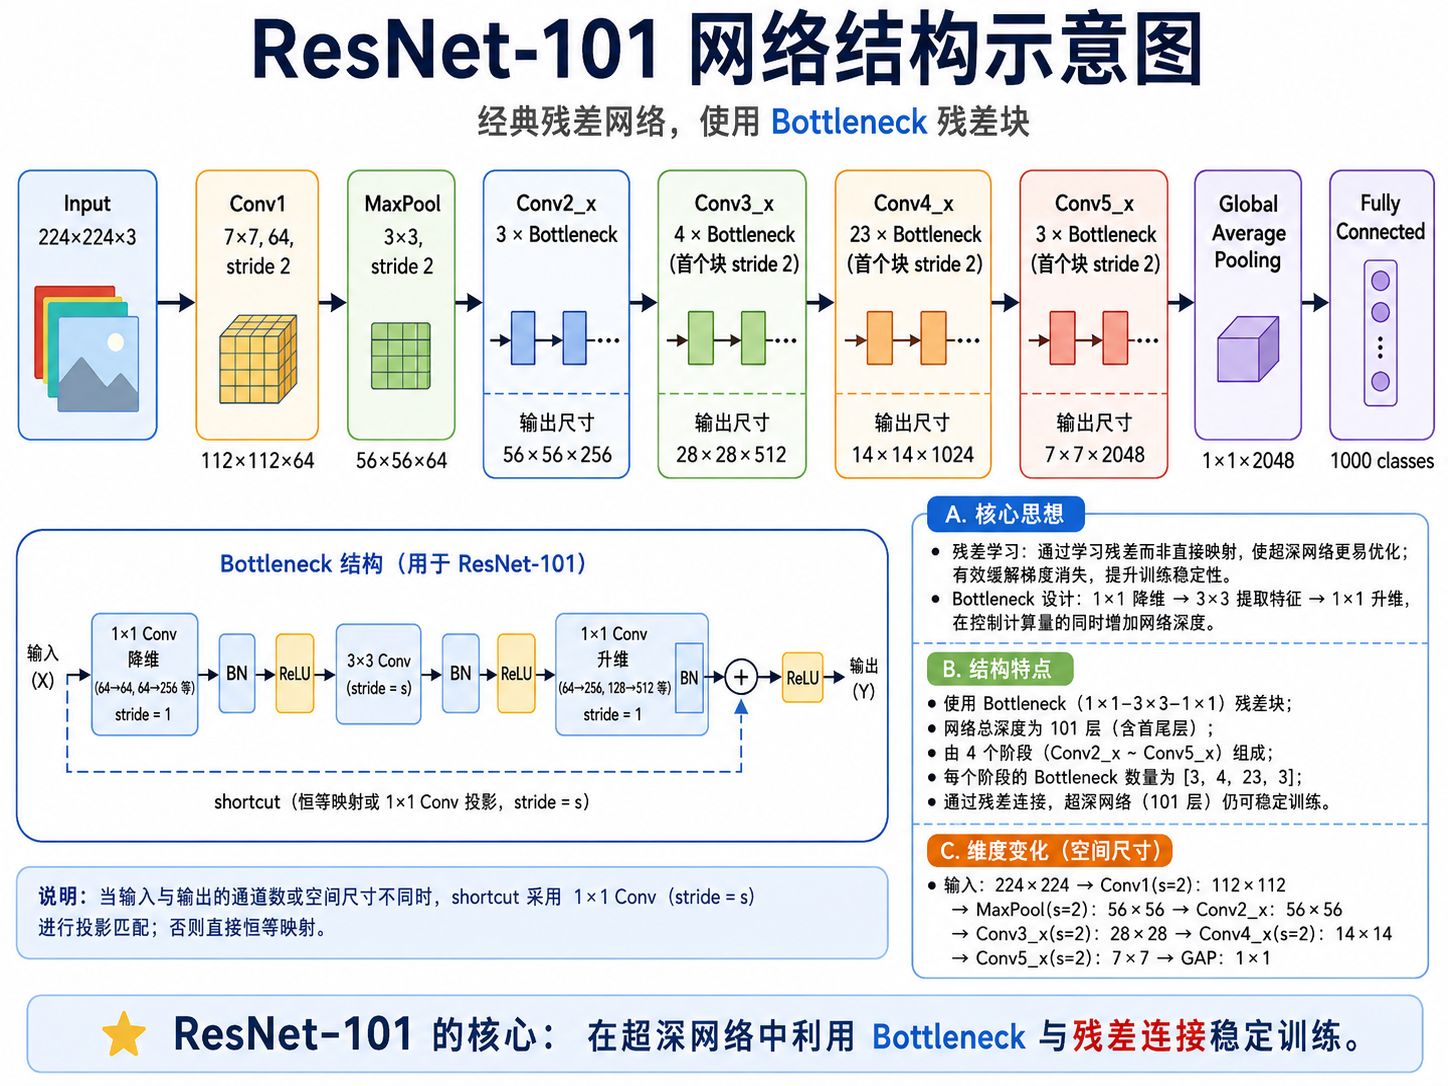
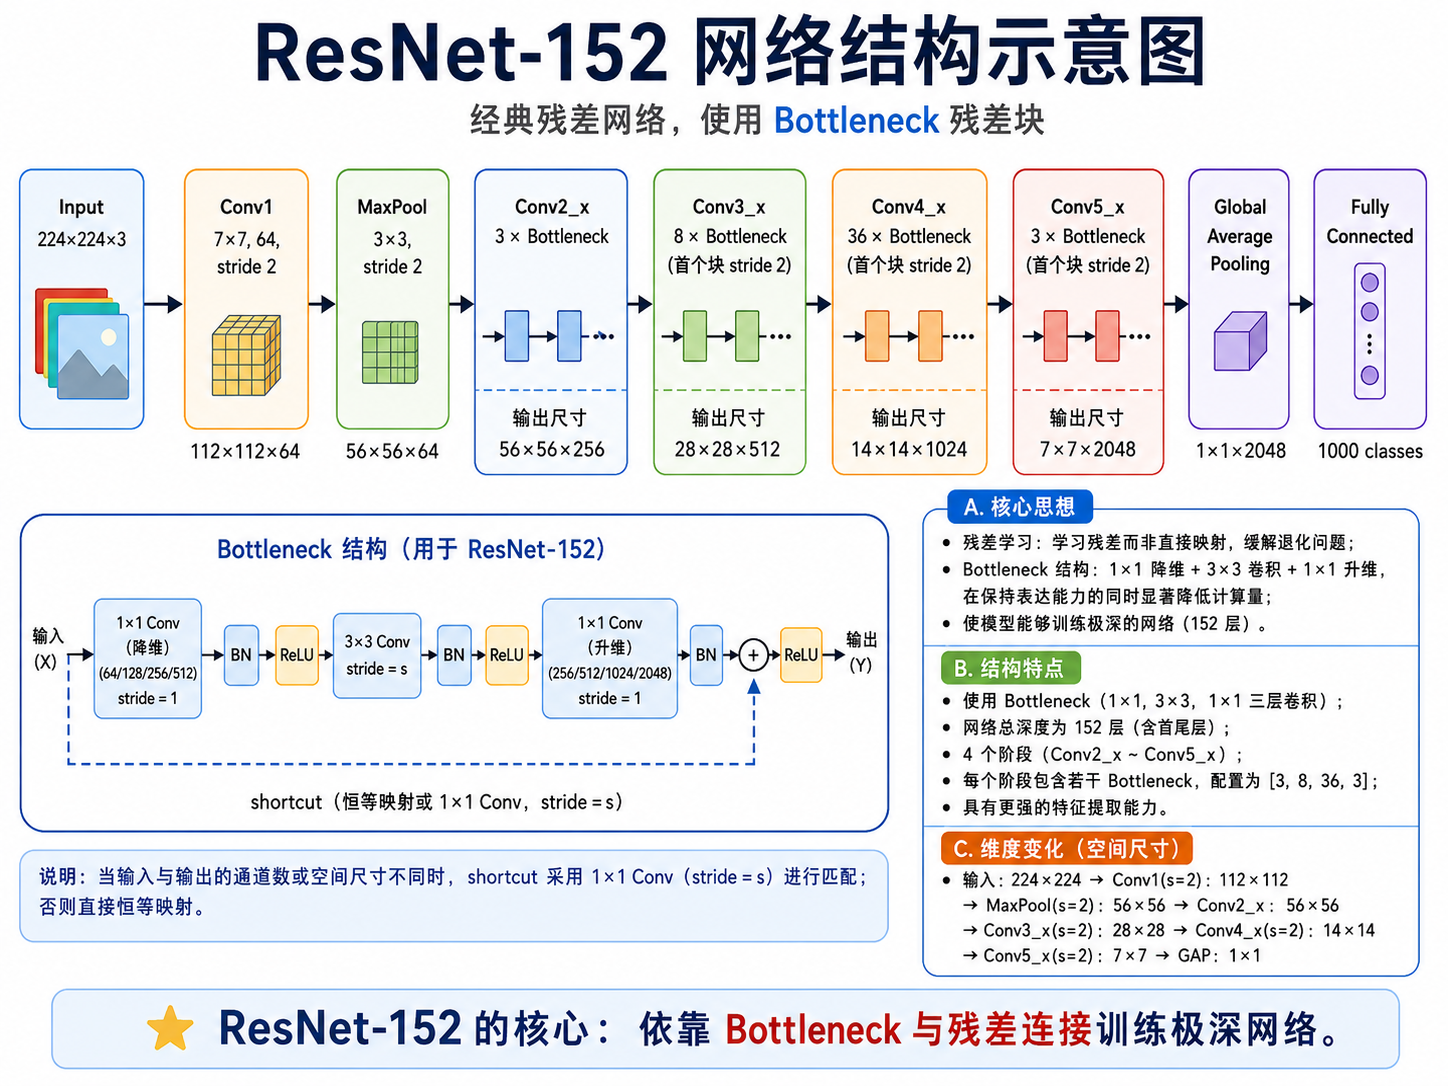
一般来说:
18/34 使用 Basic Block50/101/152 使用 Bottleneck
二者的区别在于是否使用了 1x1 卷积来调整维度。
9. 残差连接如何帮助梯度传播
如果:
$$
y = F(x) + x
$$
那么反向传播时,对输入的梯度中会包含一项来自恒等映射:
$$
\frac{\partial y}{\partial x} = \frac{\partial F(x)}{\partial x} + 1
$$
这个额外的 +1 很关键,因为它给梯度提供了一条更直接的传播路径,缓解深层网络中梯度衰减问题。
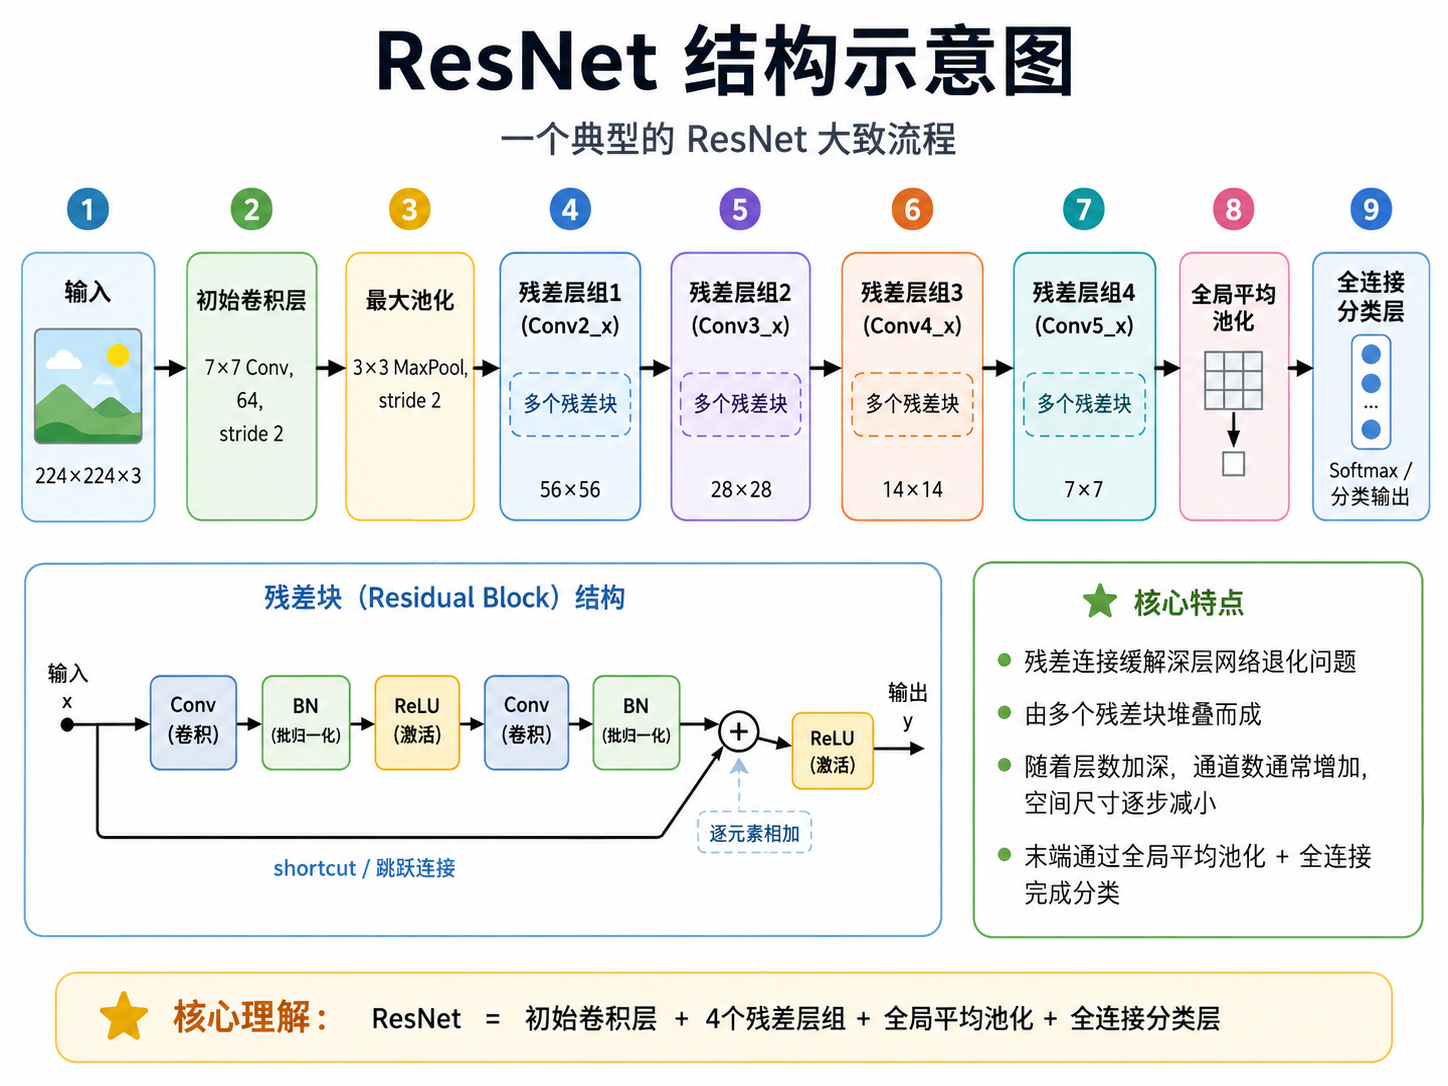
10. ResNet 的结构示意
一个 ResNet 大致会是:
11. 为什么是全局平均池化
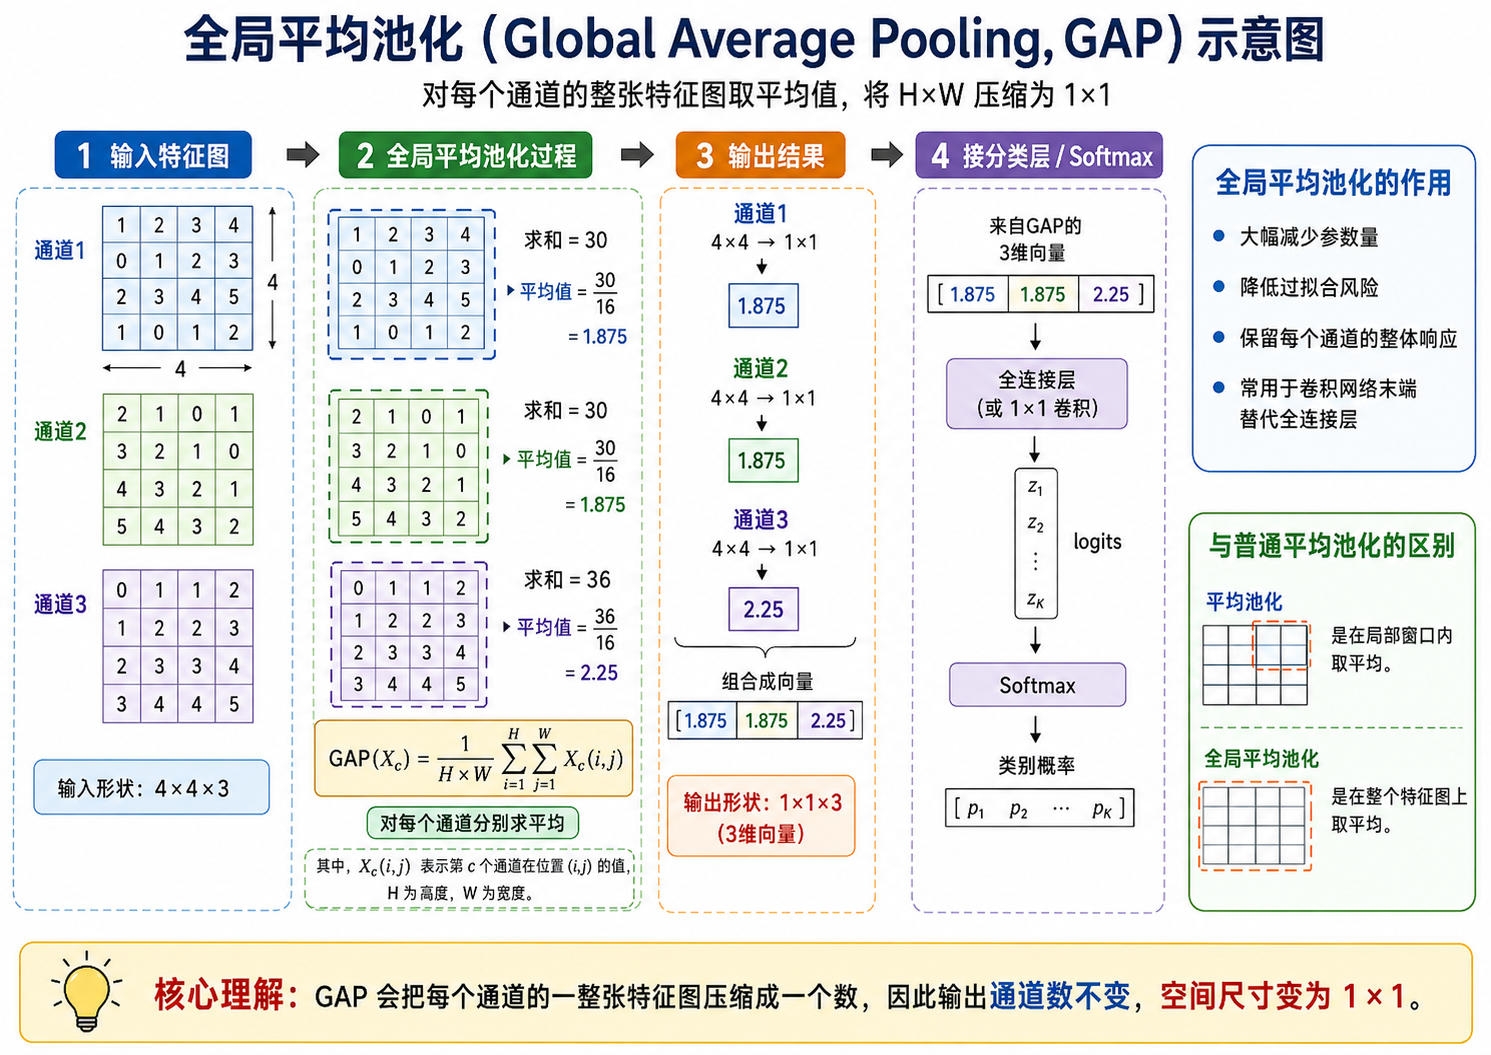
相较于传统大规模全连接层,全局平均池化(Global Average Pooling)有几个好处:
- 参数更少
- 不容易过拟合
- 更自然地把每个通道解释为一种语义响应
12. ResNet 的代码实现:BasicBlock
下面给出一个适合学习的残差块实现。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
|
import torch
import torch.nn as nn


class BasicBlock(nn.Module):
    # 残差块的扩展因子,对于 BasicBlock 来说是 1,因为输出通道数不变
    expansion = 1

    # 初始化残差块
    def __init__(self, in_channels, out_channels, stride=1):
        super().__init__()
        self.conv1 = nn.Conv2d(in_channels, out_channels, kernel_size=3, stride=stride, padding=1, bias=False)
        self.bn1 = nn.BatchNorm2d(out_channels)
        self.relu = nn.ReLU(inplace=True)
        self.conv2 = nn.Conv2d(out_channels, out_channels, kernel_size=3, stride=1, padding=1, bias=False)
        self.bn2 = nn.BatchNorm2d(out_channels)

        # 如果输入输出维度不匹配,使用 1x1 卷积进行投影
        if stride != 1 or in_channels != out_channels:
            self.shortcut = nn.Sequential(
                nn.Conv2d(in_channels, out_channels, kernel_size=1, stride=stride, bias=False),     # 投影 shortcut
                nn.BatchNorm2d(out_channels)    # 规范化 shortcut
            )
        else:
            self.shortcut = nn.Identity()       # 恒等 shortcut

    def forward(self, x):
        identity = self.shortcut(x)

        out = self.conv1(x)
        out = self.bn1(out)
        out = self.relu(out)

        out = self.conv2(out)
        out = self.bn2(out)

        out = out + identity
        out = self.relu(out)
        return out
|
13. 用 BasicBlock 搭一个简化版 ResNet
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
|
import torch
import torch.nn as nn


class BasicBlock(nn.Module):
    # 残差块的扩展因子,对于 BasicBlock 来说是 1,因为输出通道数不变
    expansion = 1

    # 初始化残差块
    def __init__(self, in_channels, out_channels, stride=1):
        super().__init__()
        self.conv1 = nn.Conv2d(in_channels, out_channels, 3, stride=stride, padding=1, bias=False)
        self.bn1 = nn.BatchNorm2d(out_channels)
        self.relu = nn.ReLU(inplace=True)
        self.conv2 = nn.Conv2d(out_channels, out_channels, 3, stride=1, padding=1, bias=False)
        self.bn2 = nn.BatchNorm2d(out_channels)

        if stride != 1 or in_channels != out_channels:
            self.shortcut = nn.Sequential(
                nn.Conv2d(in_channels, out_channels, kernel_size=1, stride=stride, bias=False),
                nn.BatchNorm2d(out_channels)
            )
        else:
            self.shortcut = nn.Identity()

    def forward(self, x):
        identity = self.shortcut(x)
        out = self.relu(self.bn1(self.conv1(x)))
        out = self.bn2(self.conv2(out))
        out = self.relu(out + identity)
        return out


class SmallResNet(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        # 初始卷积层,输入通道数 3,输出通道数 64
        self.stem = nn.Sequential(
            nn.Conv2d(3, 64, kernel_size=3, stride=1, padding=1, bias=False),
            nn.BatchNorm2d(64),
            nn.ReLU(inplace=True)
        )

        # 每个 layer 包含 2 个 BasicBlock,通道数逐步增加,空间尺寸逐步减小
        self.layer1 = self._make_layer(64, 64, blocks=2, stride=1)
        # 注意 layer2 开始 stride=2,进行下采样
        self.layer2 = self._make_layer(64, 128, blocks=2, stride=2)
        # 后续 layer3 和 layer4 继续下采样并增加通道数
        self.layer3 = self._make_layer(128, 256, blocks=2, stride=2)
        self.layer4 = self._make_layer(256, 512, blocks=2, stride=2)

        self.pool = nn.AdaptiveAvgPool2d((1, 1))
        self.fc = nn.Linear(512, num_classes)

    def _make_layer(self, in_channels, out_channels, blocks, stride):
        layers = [BasicBlock(in_channels, out_channels, stride=stride)]
        for _ in range(1, blocks):
            layers.append(BasicBlock(out_channels, out_channels, stride=1))
        return nn.Sequential(*layers)

    def forward(self, x):
        x = self.stem(x)
        x = self.layer1(x)
        x = self.layer2(x)
        x = self.layer3(x)
        x = self.layer4(x)
        x = self.pool(x)
        x = torch.flatten(x, 1)
        x = self.fc(x)
        return x


if __name__ == "__main__":
    model = SmallResNet(num_classes=10)
    x = torch.randn(4, 3, 32, 32)
    y = model(x)
    print(y.shape)  # [4, 10]
|
14. ResNet 为什么这么成功
ResNet 成功的原因并不只是“层数多”,而是它解决了一个非常根本的问题:深层网络怎么稳定训练。
它的设计带来的结果包括:
- 深层网络性能提升成为可能
- 后续 DenseNet、U-Net、Transformer 等都受到启发
- 残差思想成为现代网络默认组件之一
15. ResNet 和普通 CNN 的区别
普通 CNN:
ResNet:
表面上只是多了一条跳连,实际上对优化动力学影响非常大。
16. ResNet 的变体
Pre-Activation ResNet(预激活 ResNet)
把 BN 和 ReLU 放到卷积前面。
这样有利于梯度传播,训练更深网络时效果更好。
ResNeXt(ResNet with Grouped Convolutions,分组卷积 ResNet)
引入分组卷积和 cardinality 概念。
Wide ResNet(宽 ResNet)
不是一味加深,而是适当加宽。
17. 什么时候选 ResNet
适合:
- 图像分类
- 图像检测/分割 backbone
- 需要稳健 CNN 基线时
如果你想打好视觉基础,ResNet 必须会。
18. 学 ResNet 时真正要懂的点
| 问题 |
简要解释 |
| 1. 退化问题和过拟合不是一回事 |
过拟合是训练集效果好、测试集效果差;退化问题是网络变深后,连训练集效果都变差。也就是说,退化问题主要是“深层网络不好优化”,不是泛化能力差。 |
| 2. 为什么残差连接让优化更容易 |
普通网络要直接学习 (H(x)),ResNet 让网络学习残差 (F(x)=H(x)-x),最后输出 (F(x)+x)。如果某些层不需要改变输入,只要让 (F(x)=0),输出就等于 (x),所以更容易学到恒等映射。 |
| 3. 什么时候需要 projection shortcut |
当主分支输出和捷径分支输入的尺寸不一致时,需要 projection shortcut。比如通道数从 64 变成 128,或者空间尺寸从 (32 * 32) 变成 (16 * 16),此时不能直接相加,需要用 (1 * 1) 卷积调整维度。 |
| 4. BasicBlock 和 Bottleneck 的区别 |
BasicBlock 通常由两个 (3 * 3) 卷积组成,结构简单,常用于 ResNet-18、ResNet-34;Bottleneck 通常是 (1 * 1 + 3 * 3 + 1 * 1),先降维、再卷积、再升维,常用于 ResNet-50、ResNet-101、ResNet-152。 |
| 5. 为什么 ResNet 对后续架构影响巨大 |
ResNet 证明了“通过跳跃连接可以训练很深的网络”。后来的很多网络,比如 DenseNet、U-Net、Transformer、扩散模型里的 U-Net,也都大量使用类似的跳跃连接思想。 |
19. 为什么 shortcut 分支通常尽量保持简单
ResNet 的关键思想之一,就是让 shortcut 尽量接近“无障碍的信息通道”。
如果 shortcut 分支过于复杂:
所以当输入输出维度一致时,最好的 shortcut 往往就是:
即什么都不做,直接传过去。
20. Bottleneck Block 代码示例
更深的 ResNet 常用 Bottleneck 结构,下面给出一个学习版实现。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
|
import torch
import torch.nn as nn


class Bottleneck(nn.Module):
    expansion = 4

    def __init__(self, in_channels, mid_channels, stride=1):
        super().__init__()
        out_channels = mid_channels * self.expansion

        self.conv1 = nn.Conv2d(in_channels, mid_channels, kernel_size=1, bias=False)
        self.bn1 = nn.BatchNorm2d(mid_channels)

        self.conv2 = nn.Conv2d(mid_channels, mid_channels, kernel_size=3, stride=stride, padding=1, bias=False)
        self.bn2 = nn.BatchNorm2d(mid_channels)

        self.conv3 = nn.Conv2d(mid_channels, out_channels, kernel_size=1, bias=False)
        self.bn3 = nn.BatchNorm2d(out_channels)

        self.relu = nn.ReLU(inplace=True)

        if stride != 1 or in_channels != out_channels:
            self.shortcut = nn.Sequential(
                nn.Conv2d(in_channels, out_channels, kernel_size=1, stride=stride, bias=False),
                nn.BatchNorm2d(out_channels)
            )
        else:
            self.shortcut = nn.Identity()

    def forward(self, x):
        identity = self.shortcut(x)

        out = self.relu(self.bn1(self.conv1(x)))
        out = self.relu(self.bn2(self.conv2(out)))
        out = self.bn3(self.conv3(out))

        out = self.relu(out + identity)
        return out
|
21. Post-Activation 与 Pre-Activation
经典 ResNet 通常是:
而 Pre-Activation ResNet 会改成:
Pre-Activation 的优势在于:
这说明 ResNet 不只是“加 shortcut”,它的每个细节都和优化密切相关。
22. ResNet 可以怎样理解成“微分方程视角”
这是一个更进阶但非常有价值的理解方式。
如果每个残差块写成:
$$
x_{l+1} = x_l + F(x_l)
$$
它很像离散时间系统中的一步更新。
从这个视角看,深层网络是在不断对表示做“小步修正”,而不是每一层都完全重新生成表示。
这个理解会帮助你未来学习:
- Neural ODE
- Continuous-depth models
- 更一般的残差结构
23. ResNet 的训练实战建议
如果你要从零训练 ResNet,建议注意:
- 图像任务中数据增强通常非常重要。
- 使用合适的学习率调度器会明显影响最终效果。
- 残差块内部通常不建议随意改动层顺序。
- 小数据集上更深网络不一定更好。
24. ResNet 常见误区
误区 1:ResNet 解决了所有梯度问题
不是。它显著缓解了深层训练困难,但并不是万能的。
误区 2:有残差就一定更强
不一定。效果还和数据、任务、宽度、正则化、训练策略有关。
误区 3:ResNet 只是一个图像分类模型
不是。ResNet 更重要的价值是它提供了“残差连接”这一普适思想。
如果说 CNN 是视觉时代最重要的结构之一,那么 Transformer 则是现代 AI 大模型时代的核心架构。
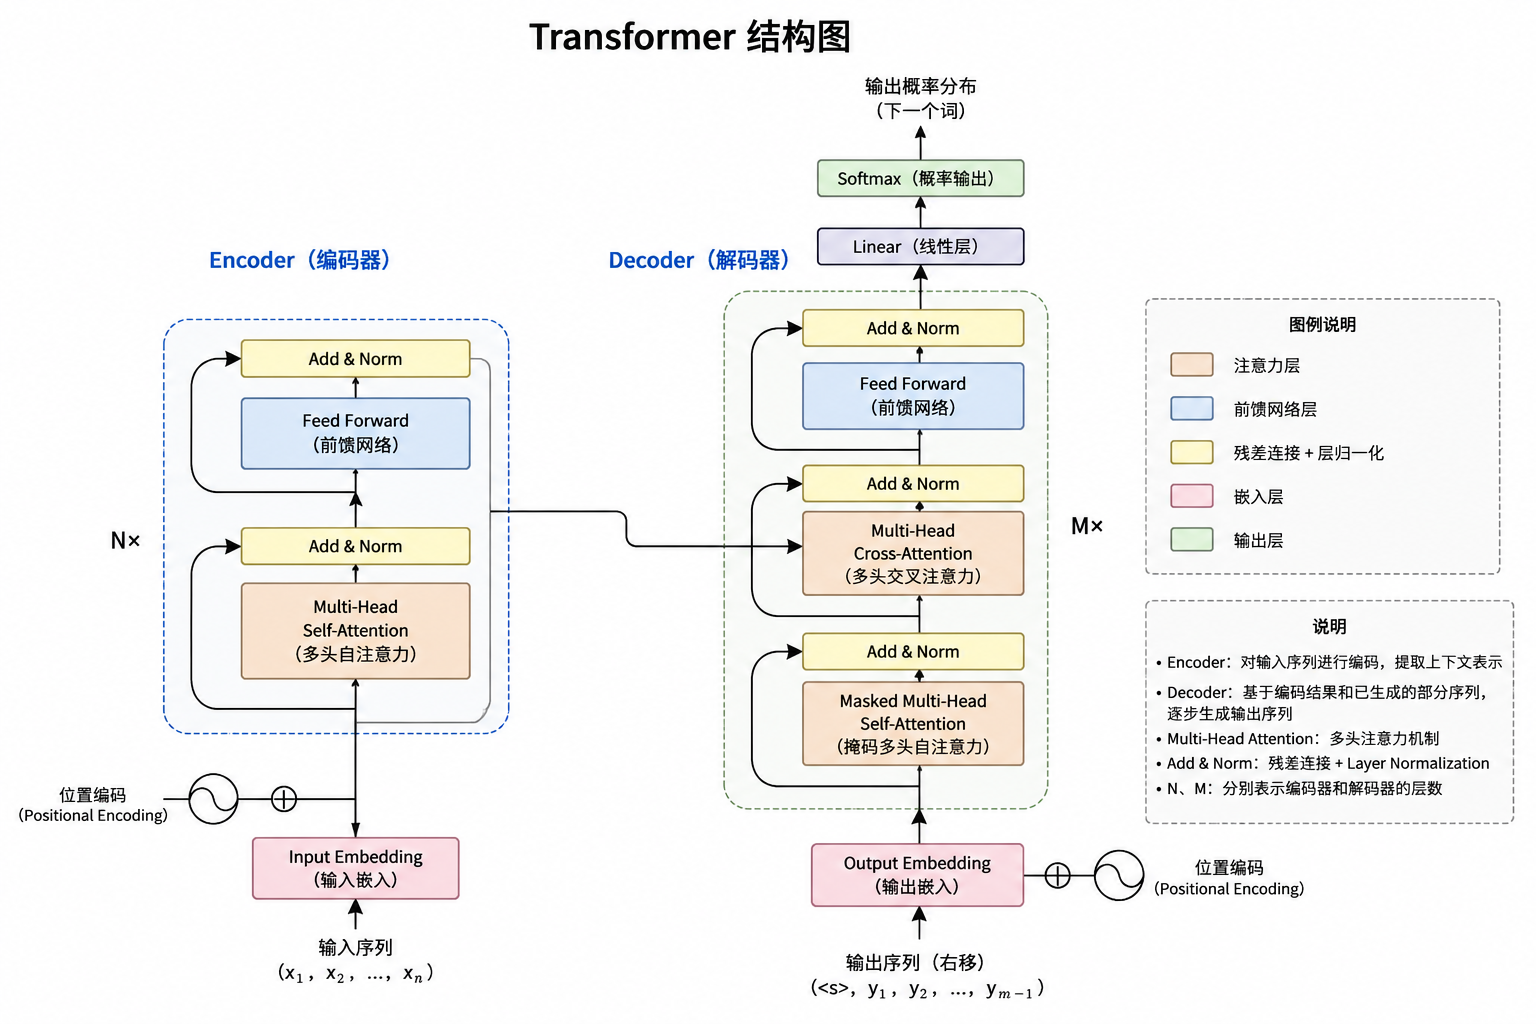
它最初用于自然语言处理,但后来扩展到了:
- 大语言模型
- 视觉 Transformer
- 多模态模型
- 语音模型
- 蛋白质建模
理解 Transformer,是理解当代 AI 的关键。
在 Transformer 之前,序列建模主流是:
- RNN(循环神经网络)
- LSTM(长短期记忆网络)
- GRU(门控循环单元)
这些模型的问题包括:
- 难以并行计算
- 长距离依赖建模困难
- 序列很长时训练效率低
Transformer 的论文标题非常有名:
Attention Is All You Need
它的核心观点是:序列建模可以完全基于注意力机制,不依赖循环结构。
2. 为什么长距离依赖难
在 RNN 中,一个词要影响很远处的另一个词,信息必须经过很多时间步传播,路径很长,容易衰减。
而在自注意力中,任意两个位置可以直接建立联系,路径长度更短。
3. 注意力机制的直觉
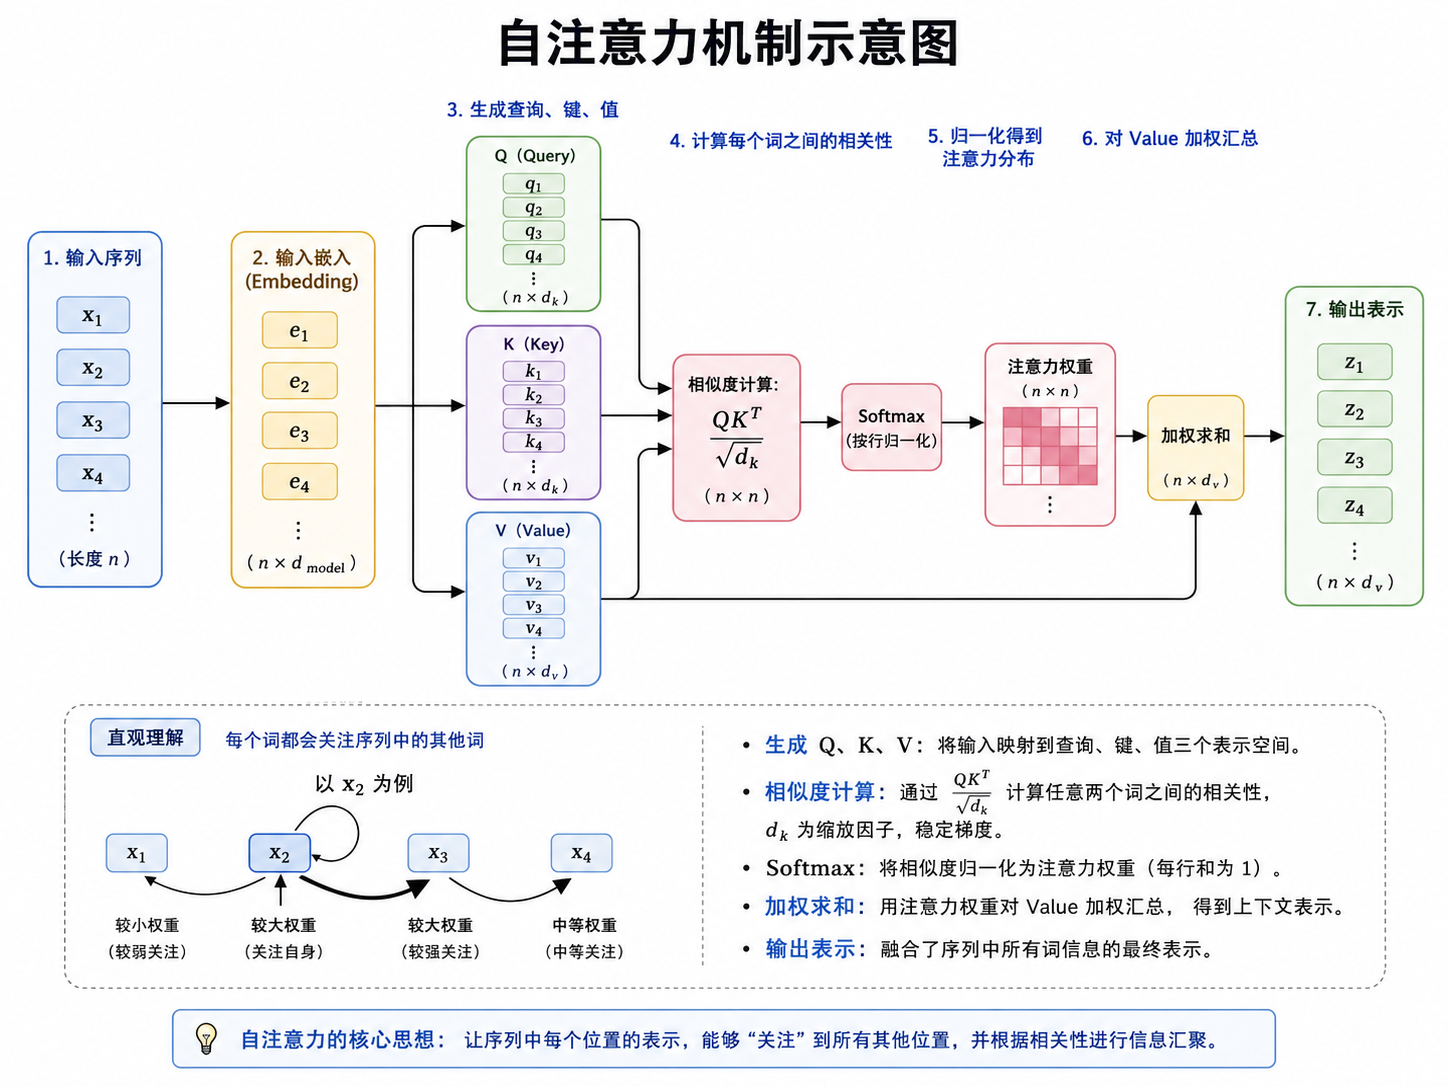
注意力可以理解为:
当模型处理某个位置时,它会“有选择地关注”输入中的其他位置。
例如句子:
1
|
The animal didn't cross the street because it was too tired.
|
这里 it 指代谁?
模型需要关注句子中前面的词,理解 it 更可能指 animal 而不是 street。
4. Query、Key、Value 是什么
Transformer 中最关键的一步,就是把输入的每个 Token 映射为三组向量:
- Query(查询)
- Key(键)
- Value(值)
可以先用直觉理解:
- Query:我现在想找什么信息
- Key:我这里有什么信息标签
- Value:真正要取出的内容
当某个 Token 的 Query 和其他位置的 Key 更匹配时,就会更多地吸收对应 Token 的 Value。
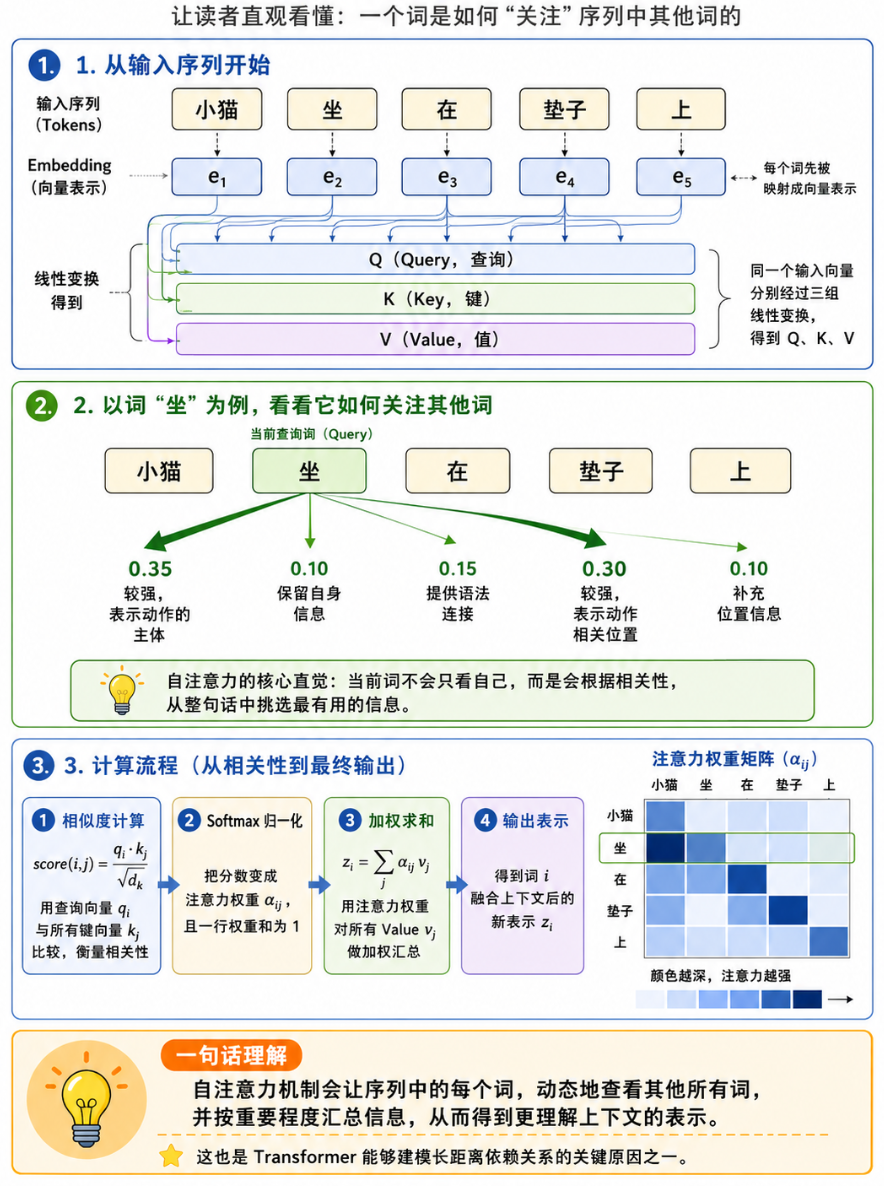
5. Scaled Dot-Product Attention
注意力公式:
$$
\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V
$$
拆开理解:
- $QK^T$:计算相似度分数,Q是查询向量,K是键向量,点积越大表示越相关
- 除以 $\sqrt{d_k}$:防止维度过大导致数值不稳定,$\sqrt{d_k}$ 是 Key 的维度
softmax:归一化为权重- 乘以
V:按权重加权求和
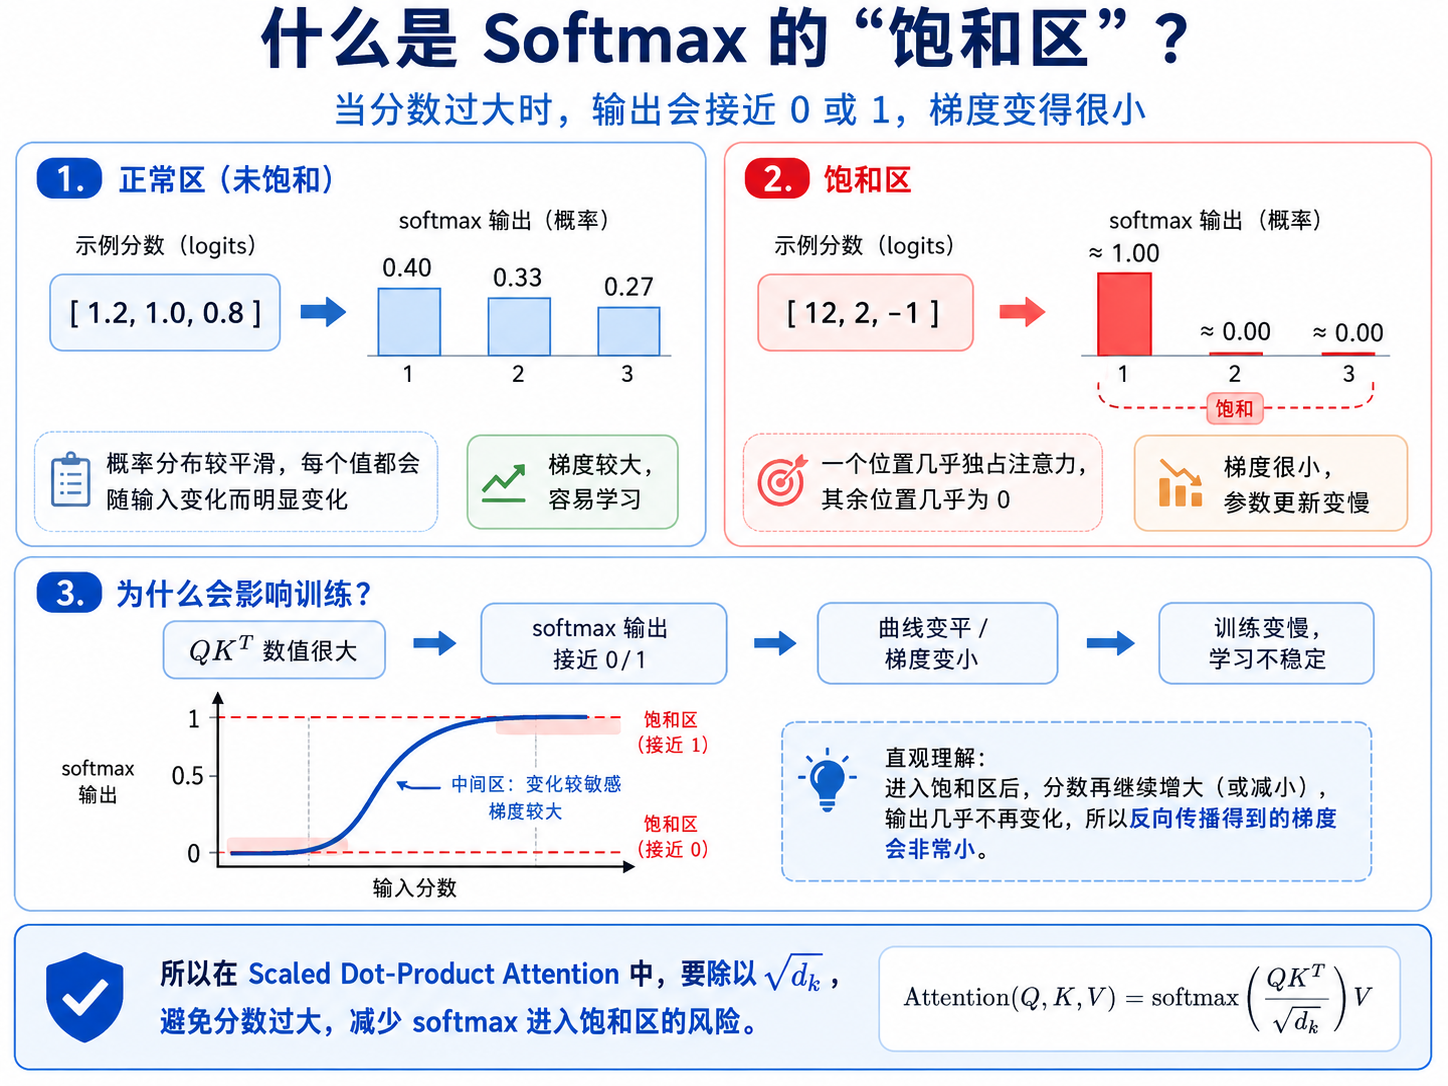
6. 为什么要除以 $\sqrt{d_k}$
如果向量维度很大,点积数值会变大,softmax 可能进入饱和区,梯度变小。
除以 $\sqrt{d_k}$ 可以让数值范围更稳定。
7. 自注意力 Self-Attention
当 Q、K、V 都来自同一个序列时,就叫自注意力。
这意味着:
- 一个词在编码自己时,可以参考整个句子中的所有词
- 一个图像 patch 在编码自己时,可以参考所有其他 patch
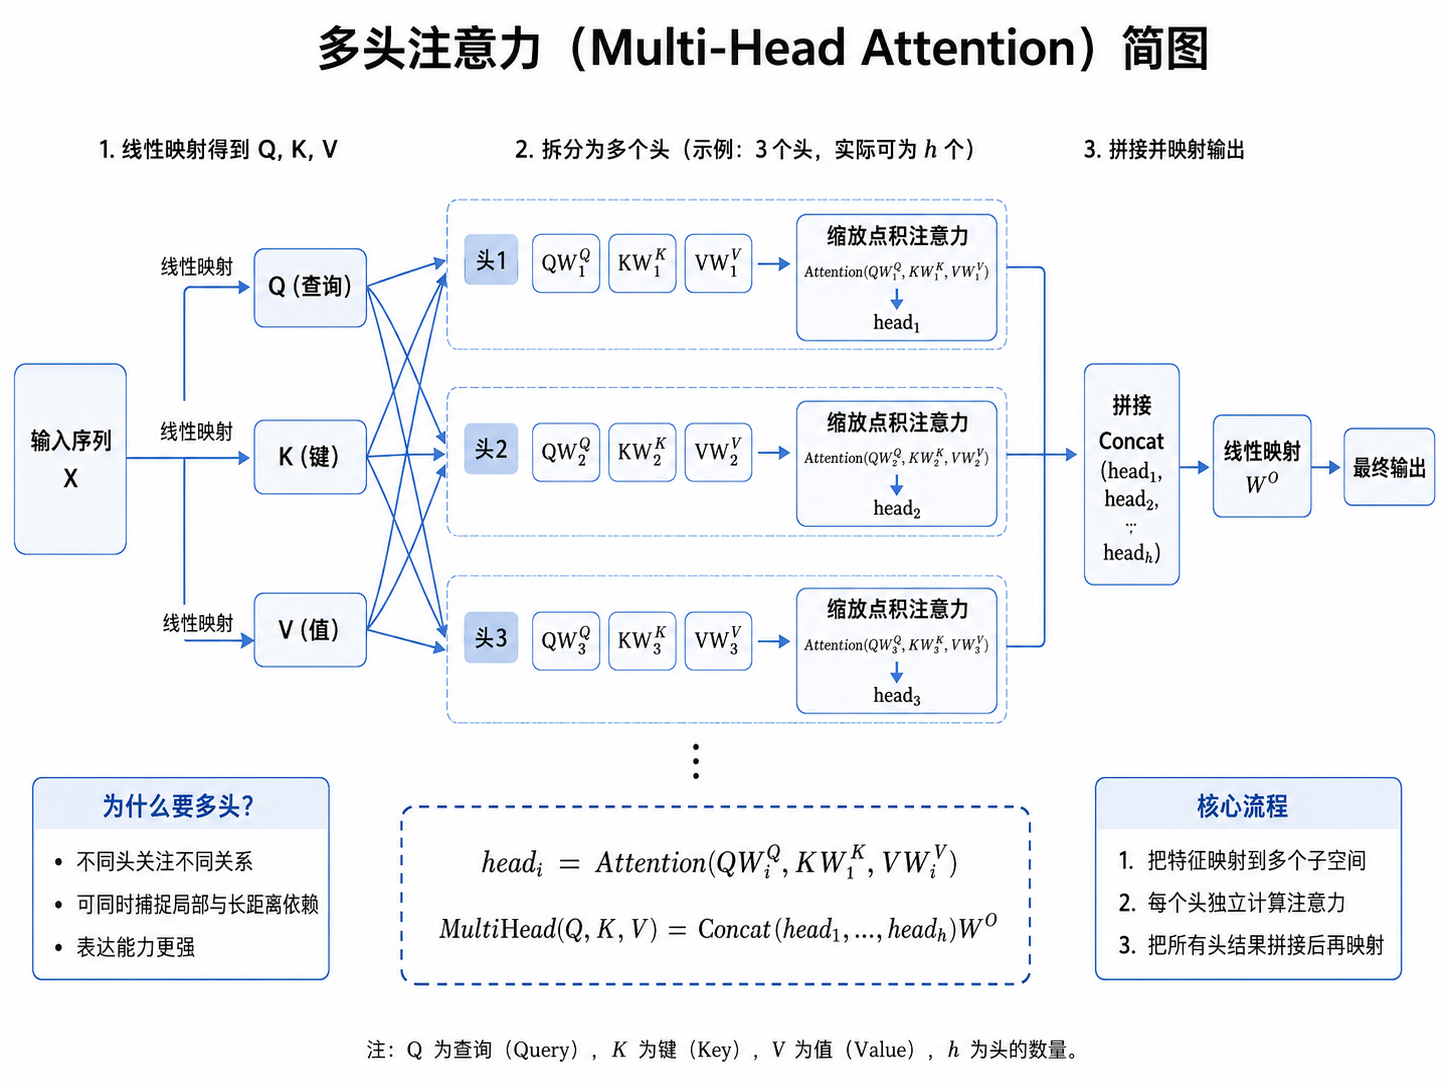
8. 多头注意力 Multi-Head Attention
单个注意力头只能从一种角度看关系。
多头注意力做法是:
- 把特征分成多个子空间
- 每个头独立做注意力
- 把所有头结果拼接起来
公式:
$$
\text{head}_i = \text{Attention}(QW_i^Q, KW_i^K, VW_i^V)
$$
$$
\text{MultiHead}(Q,K,V) = \text{Concat}(\text{head}_1, …, \text{head}_h)W^O
$$
优点:
9. 位置编码 Positional Encoding
Transformer 本身没有循环,也没有卷积,因此默认不感知顺序。
所以必须注入位置信息。
经典 Transformer 使用正弦余弦位置编码:
$$
PE(pos, 2i) = \sin\left(\frac{pos}{10000^{2i/d_{model}}}\right)
$$
$$
PE(pos, 2i+1) = \cos\left(\frac{pos}{10000^{2i/d_{model}}}\right)
$$
直觉上,这是一种不同频率的周期函数编码,使模型能感知相对和绝对位置信息。
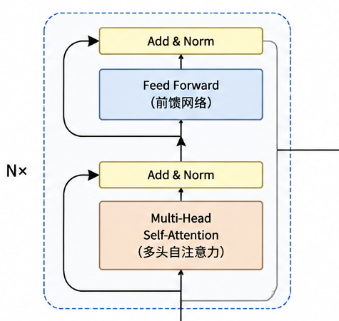
一个编码器层通常包含两个子层:
- Multi-Head Self-Attention
- Position-wise Feed Forward Network
且每个子层都配有:
结构示意:
11. 前馈网络 FFN
FFN 对每个位置独立地进行非线性变换:
$$
\text{FFN}(x) = W_2 \sigma(W_1 x + b_1) + b_2
$$
它不负责跨位置交互,但负责增强表示能力。
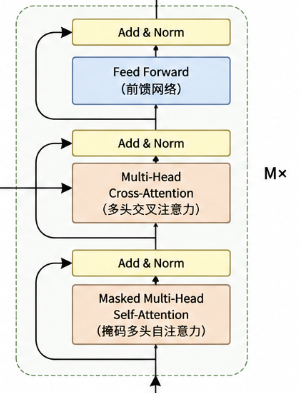
解码器比编码器多一个模块:
- Masked Self-Attention
- Cross-Attention
- Feed Forward
为什么要 Mask
生成第 t 个 token 时,不能偷看第 t+1 个 token,因此需要因果掩码(causal mask)。
13. Encoder-Only、Decoder-Only、Encoder-Decoder
Encoder-Only
代表:
适合:
Decoder-Only
代表:
适合:
Encoder-Decoder
代表:
适合:
- 并行性强
- 长距离依赖建模直接
- 架构通用性强
- 扩展到大规模训练效果非常好
最经典的问题是注意力复杂度。
序列长度为 $n$ 时,自注意力的时间和空间复杂度通常是:
$$
O(n^2)
$$
当序列很长时,计算和显存开销很大。
这也是后来 Longformer、Performer、FlashAttention 等工作的背景之一。
16. LayerNorm 与 BatchNorm 的区别
Transformer 中通常用 LayerNorm,而不是 BatchNorm。
原因包括:
- 序列长度可变
- NLP 中 batch 统计不稳定
- LayerNorm 对单个样本内部做归一化,更适合序列建模
注意一点:Transformer 不是只有注意力。
它的成功来自多个关键组件共同作用:
- 注意力机制
- 残差连接
- LayerNorm
- FFN
- 位置编码
- 大规模数据训练
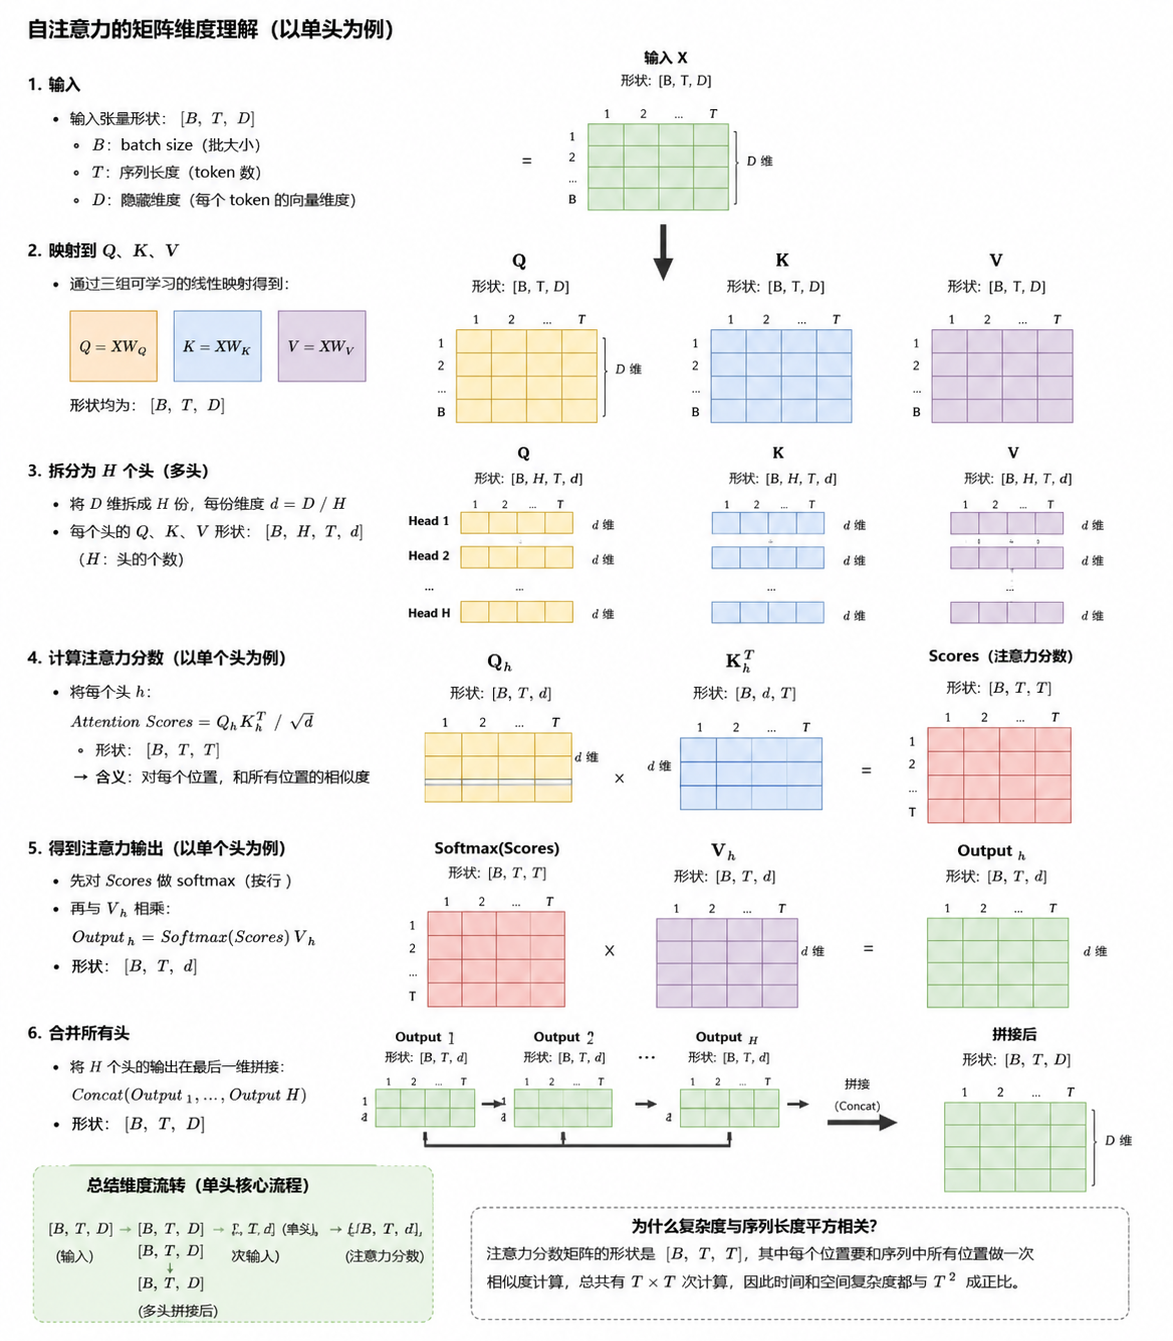
18. 自注意力的矩阵维度理解
假设:
- batch size =
B
- 序列长度 =
T
- 隐藏维度 =
D
输入张量形状:
映射到 Q、K、V 后仍是:
如果分成 H 个头,每个头维度是 d = D / H,则:
注意力分数矩阵:
这就是为什么复杂度和序列长度平方相关。
19. 用 PyTorch 手写一个 Self-Attention
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
|
import math
import torch
import torch.nn as nn


class SelfAttention(nn.Module):
    def __init__(self, d_model):
        super().__init__()
        self.q_proj = nn.Linear(d_model, d_model)
        self.k_proj = nn.Linear(d_model, d_model)
        self.v_proj = nn.Linear(d_model, d_model)
        self.out_proj = nn.Linear(d_model, d_model)

    def forward(self, x, mask=None):
        q = self.q_proj(x)
        k = self.k_proj(x)
        v = self.v_proj(x)

        scores = torch.matmul(q, k.transpose(-2, -1)) / math.sqrt(x.size(-1))

        if mask is not None:
            scores = scores.masked_fill(mask == 0, float("-inf"))

        attn = torch.softmax(scores, dim=-1)
        out = torch.matmul(attn, v)
        return self.out_proj(out)


x = torch.randn(2, 5, 32)
attn = SelfAttention(32)
y = attn(x)
print(y.shape)  # [2, 5, 32]
|
代码解释:这个实现展示了如何手动编写一个自注意力机制。它包含查询、键和值的线性投影,计算注意力分数,应用 softmax 函数,并最终生成输出。
20. 手写 Multi-Head Attention
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
|
import math
import torch
import torch.nn as nn


class MultiHeadSelfAttention(nn.Module):
    def __init__(self, d_model, num_heads):
        super().__init__()
        assert d_model % num_heads == 0
        self.d_model = d_model
        self.num_heads = num_heads
        self.head_dim = d_model // num_heads

        self.q_proj = nn.Linear(d_model, d_model)
        self.k_proj = nn.Linear(d_model, d_model)
        self.v_proj = nn.Linear(d_model, d_model)
        self.out_proj = nn.Linear(d_model, d_model)

    def forward(self, x, mask=None):
        B, T, D = x.shape

        q = self.q_proj(x).view(B, T, self.num_heads, self.head_dim).transpose(1, 2)
        k = self.k_proj(x).view(B, T, self.num_heads, self.head_dim).transpose(1, 2)
        v = self.v_proj(x).view(B, T, self.num_heads, self.head_dim).transpose(1, 2)

        scores = torch.matmul(q, k.transpose(-2, -1)) / math.sqrt(self.head_dim)

        if mask is not None:
            scores = scores.masked_fill(mask == 0, float("-inf"))

        attn = torch.softmax(scores, dim=-1)
        out = torch.matmul(attn, v)

        out = out.transpose(1, 2).contiguous().view(B, T, D)
        out = self.out_proj(out)
        return out


x = torch.randn(2, 10, 64)
module = MultiHeadSelfAttention(d_model=64, num_heads=8)
y = module(x)
print(y.shape)  # [2, 10, 64]
|
代码解释:这个实现展示了如何手动编写一个多头自注意力机制。它首先将输入投影到多个头的查询、键和值空间,然后计算每个头的注意力分数,最后将所有头的输出拼接并通过线性层生成最终输出。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
|
import torch
import torch.nn as nn


class TransformerEncoderBlock(nn.Module):
    def __init__(self, d_model, num_heads, mlp_ratio=4, dropout=0.1):
        super().__init__()
        self.norm1 = nn.LayerNorm(d_model)
        self.attn = nn.MultiheadAttention(d_model, num_heads, dropout=dropout, batch_first=True)
        self.norm2 = nn.LayerNorm(d_model)
        self.mlp = nn.Sequential(
            nn.Linear(d_model, d_model * mlp_ratio),
            nn.GELU(),
            nn.Dropout(dropout),
            nn.Linear(d_model * mlp_ratio, d_model),
            nn.Dropout(dropout)
        )

    def forward(self, x, attn_mask=None):
        attn_input = self.norm1(x)
        attn_out, _ = self.attn(attn_input, attn_input, attn_input, attn_mask=attn_mask)
        x = x + attn_out

        mlp_input = self.norm2(x)
        x = x + self.mlp(mlp_input)
        return x


x = torch.randn(4, 16, 128)
block = TransformerEncoderBlock(d_model=128, num_heads=8)
y = block(x)
print(y.shape)  # [4, 16, 128]
|
代码解释:这个实现展示了如何手动编写一个 Transformer 编码器块。它包含一个多头自注意力层和一个前馈网络(MLP),每个子层都配有 LayerNorm 和残差连接。
下面示例只展示结构,不包含完整 tokenizer 流程。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
|
import torch
import torch.nn as nn


class PositionalEncoding(nn.Module):
    def __init__(self, max_len, d_model):
        super().__init__()
        pe = torch.zeros(max_len, d_model)
        position = torch.arange(0, max_len).unsqueeze(1).float()
        div_term = torch.exp(torch.arange(0, d_model, 2).float() * (-torch.log(torch.tensor(10000.0)) / d_model))
        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)
        self.register_buffer("pe", pe.unsqueeze(0))

    def forward(self, x):
        return x + self.pe[:, :x.size(1)]


class TextTransformerClassifier(nn.Module):
    def __init__(self, vocab_size, d_model, num_heads, num_layers, num_classes, max_len=128):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, d_model)
        self.pos_encoding = PositionalEncoding(max_len=max_len, d_model=d_model)

        encoder_layer = nn.TransformerEncoderLayer(
            d_model=d_model,
            nhead=num_heads,
            dim_feedforward=d_model * 4,
            dropout=0.1,
            activation="gelu",
            batch_first=True
        )
        self.encoder = nn.TransformerEncoder(encoder_layer, num_layers=num_layers)
        self.classifier = nn.Linear(d_model, num_classes)

    def forward(self, input_ids):
        x = self.embedding(input_ids)
        x = self.pos_encoding(x)
        x = self.encoder(x)
        cls_rep = x[:, 0]
        logits = self.classifier(cls_rep)
        return logits


model = TextTransformerClassifier(
    vocab_size=30000,
    d_model=128,
    num_heads=8,
    num_layers=2,
    num_classes=4,
    max_len=128
)

input_ids = torch.randint(0, 30000, (8, 128))
logits = model(input_ids)
print(logits.shape)  # [8, 4]
|
代码解释:这个实现展示了如何使用 Transformer 架构构建一个文本分类模型。它包括一个嵌入层、位置编码、多个 Transformer 编码器层,以及一个线性分类器。输入是 token id 序列,输出是类别 logits。
Transformer 后来被引入视觉领域,形成 Vision Transformer(ViT)。
做法是:
- 把图像切成 patch
- 每个 patch 拉平后映射为 token embedding
- 加位置编码
- 输入 Transformer Encoder
这说明 Transformer 其实可以看作一种更通用的 “ token 关系建模器 ”。
核心原因包括:
- 易并行
- 可扩展
- 模块化强
- 在大数据大算力下表现优异
- 自回归训练目标简单有效
混淆 1:注意力是不是“权重越大越好”
不是。注意力权重只是表示当前上下文下的重要性分配,不是绝对因果解释。
不是。FFN、残差、Norm、位置编码都很关键。
混淆 3:多头就是多个模型吗
不是。它们共享同一层框架,只是在不同子空间建模。
- Q、K、V 的意义。
- 注意力公式每一步的含义。
- 为什么复杂度是 $O(n^2)$。
- 位置编码为什么必要。
- Encoder-only、Decoder-only、Encoder-decoder 的区别。
- 为什么残差和 LayerNorm 对训练很重要。
27. 用一个极小例子理解注意力计算
这一节非常重要,因为很多人会背公式,但不知道公式到底在做什么。
假设一句话只有 3 个 token,经过线性映射后,某个头上的:
1
2
3
|
Q = [q1, q2, q3]
K = [k1, k2, k3]
V = [v1, v2, v3]
|
当我们计算第一个位置的输出时,本质是:
- 计算
q1 和所有 k 的相似度
- 得到 3 个分数
- 经过 softmax 变成 3 个权重
- 用这 3 个权重对
v1, v2, v3 加权求和
也就是说,第一个位置最终得到的是“整句信息的加权汇总”,而不是只保留自己。
这就是自注意力比普通逐位置线性层强很多的根本原因。
28. 为什么多头注意力比单头更强
你可以把不同头理解为不同“观察视角”。
例如对一句话:
- 某个头可能关注语法依赖
- 某个头可能关注指代关系
- 某个头可能关注局部搭配
虽然这是直觉解释,不是严格一一对应,但它说明了多头机制的价值:
它允许模型在不同子空间并行地学习不同关系模式。
29. 因果掩码 Causal Mask
在语言生成中,位置 t 只能看 <= t 的 token,不能看未来。
因果掩码通常是一个上三角屏蔽矩阵。
例如序列长度为 4:
1
2
3
4
|
1 0 0 0
1 1 0 0
1 1 1 0
1 1 1 1
|
这里 1 表示可见,0 表示不可见。
30. 生成因果掩码的代码
1
2
3
4
5
6
7
8
9
|
import torch


def build_causal_mask(seq_len):
    mask = torch.tril(torch.ones(seq_len, seq_len))
    return mask


print(build_causal_mask(4))
|
如果你用 nn.MultiheadAttention 或手写 attention,都要理解这个 mask 的含义。
像 GPT 这样的模型通常使用 Decoder-Only 结构。
原因包括:
- 自回归目标简单明确
- 训练和推理逻辑统一
- 更适合 next-token prediction
训练目标通常是:
给定前面的 token,预测下一个 token。
形式上可写成:
$$
P(x_1, x_2, …, x_T) = \prod_{t=1}^{T} P(x_t | x_{<t})
$$
这也是大语言模型最核心的概率分解方式。
原始 token 是离散 id,不能直接送进网络。
Embedding 层做的是:
- 把 token id 映射成稠密向量
- 让语义相近的 token 在向量空间中更接近
输入到 Transformer 的第一步通常是:
1
|
token ids -> token embeddings -> 加位置编码
|
33. FFN 为什么不能去掉
有些初学者会觉得 Transformer 最重要的是 attention,于是忽略 FFN。
但 FFN 非常关键,因为:
- 注意力主要负责跨位置的信息交换
- FFN 负责对每个位置进行更强的非线性变换
没有 FFN,模型表达能力会明显下降。
Transformer 归纳偏置相对弱,不像 CNN 那样天然利用局部性和平移结构。
这意味着:
- 如果数据少,Transformer 不一定占优
- 如果数据和算力足够大,Transformer 的上限往往很高
这是它和 CNN 很重要的风格差异之一。
35. 手写一个带因果 mask 的自注意力
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
|
import math
import torch
import torch.nn as nn


class CausalSelfAttention(nn.Module):
    def __init__(self, d_model):
        super().__init__()
        self.q_proj = nn.Linear(d_model, d_model)
        self.k_proj = nn.Linear(d_model, d_model)
        self.v_proj = nn.Linear(d_model, d_model)
        self.out_proj = nn.Linear(d_model, d_model)

    def forward(self, x):
        B, T, D = x.shape
        q = self.q_proj(x)
        k = self.k_proj(x)
        v = self.v_proj(x)

        scores = q @ k.transpose(-2, -1) / math.sqrt(D)
        mask = torch.tril(torch.ones(T, T, device=x.device))
        scores = scores.masked_fill(mask == 0, float("-inf"))
        attn = torch.softmax(scores, dim=-1)
        out = attn @ v
        return self.out_proj(out)
|
这个实现已经非常接近 Decoder-Only 模型里的核心逻辑了。
问题 1:显存占用过大
原因通常包括:
- 序列长度太长
- batch size 太大
- 模型维度或层数太大
问题 2:训练很慢
需要检查:
- 数据加载是否成为瓶颈
- 是否使用混合精度
- 序列长度是否过长
问题 3:模型学不会
可能原因:
- 学习率设置不合理
- mask 用错
- 位置编码缺失
- 标签对齐错位
这一节很适合帮助你建立整体地图。
GPT
- 属于 Decoder-Only Transformer
- 重点是自回归生成
BERT
- 属于 Encoder-Only Transformer
- 重点是双向上下文表示学习
ViT
- 把图像 patch 当作 token
- 属于 Transformer 在视觉领域的应用
所以你可以把 Transformer 看成“母架构”,不同任务是在它的不同变体上发展出来的。
- 只会背 QKV,不会解释为什么这样设计。
- 只会调用框架 API,不会看张量维度。
- 知道有位置编码,但不知道没有它会发生什么。
- 把注意力图当成绝对解释,而不是上下文相关权重。
39. 一个最小 Decoder-Only 模型骨架
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
|
import torch
import torch.nn as nn


class TinyGPT(nn.Module):
    def __init__(self, vocab_size, d_model, num_heads, num_layers, max_len):
        super().__init__()
        self.token_emb = nn.Embedding(vocab_size, d_model)
        self.pos_emb = nn.Embedding(max_len, d_model)
        self.blocks = nn.ModuleList([
            nn.TransformerEncoderLayer(
                d_model=d_model,
                nhead=num_heads,
                dim_feedforward=d_model * 4,
                batch_first=True,
                activation="gelu"
            )
            for _ in range(num_layers)
        ])
        self.norm = nn.LayerNorm(d_model)
        self.lm_head = nn.Linear(d_model, vocab_size)

    def forward(self, input_ids):
        B, T = input_ids.shape
        pos = torch.arange(T, device=input_ids.device).unsqueeze(0)
        x = self.token_emb(input_ids) + self.pos_emb(pos)

        causal_mask = torch.triu(torch.ones(T, T, device=input_ids.device), diagonal=1).bool()
        for block in self.blocks:
            x = block(x, src_mask=causal_mask)

        x = self.norm(x)
        logits = self.lm_head(x)
        return logits
|
严格来说,nn.TransformerEncoderLayer 不是为 GPT 专门设计的最优实现,但这个骨架足以帮助你理解大语言模型的基础计算图。
1. 关系概览
CNN 是一大类卷积网络。ResNet 是一种带残差连接的深层 CNN。Transformer 是基于注意力机制的架构。
所以:
1
2
|
ResNet 属于 CNN 家族
Transformer 不属于 CNN,它是另一条主线
|
2. 特征建模方式对比
CNN
ResNet
3. 归纳偏置对比
CNN / ResNet
强归纳偏置:
因此在中小数据规模下往往更容易训练。
归纳偏置更弱,更依赖数据量和预训练。
4. 复杂度对比
CNN
5. 使用建议
如果你是学习者,建议顺序是:
- 先学基础 CNN
- 再学 ResNet
- 最后深入 Transformer
这是因为:
- CNN 让你理解视觉神经网络的基本语言
- ResNet 让你理解深层网络优化
- Transformer 让你进入现代大模型核心
完整训练模板
这一节给你一个相对通用的 PyTorch 训练模板,你可以把前面的 CNN、ResNet、Transformer 模型替换进去。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
|
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset


def train_one_epoch(model, loader, criterion, optimizer, device):
    model.train()
    total_loss = 0.0
    total_correct = 0
    total_samples = 0

    for inputs, labels in loader:
        inputs = inputs.to(device)
        labels = labels.to(device)

        logits = model(inputs)
        loss = criterion(logits, labels)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        total_loss += loss.item() * inputs.size(0)
        preds = logits.argmax(dim=1)
        total_correct += (preds == labels).sum().item()
        total_samples += labels.size(0)

    return total_loss / total_samples, total_correct / total_samples


@torch.no_grad()
def evaluate(model, loader, criterion, device):
    model.eval()
    total_loss = 0.0
    total_correct = 0
    total_samples = 0

    for inputs, labels in loader:
        inputs = inputs.to(device)
        labels = labels.to(device)

        logits = model(inputs)
        loss = criterion(logits, labels)

        total_loss += loss.item() * inputs.size(0)
        preds = logits.argmax(dim=1)
        total_correct += (preds == labels).sum().item()
        total_samples += labels.size(0)

    return total_loss / total_samples, total_correct / total_samples


def main():
    device = "cuda" if torch.cuda.is_available() else "cpu"

    X_train = torch.randn(1000, 1, 28, 28)
    y_train = torch.randint(0, 10, (1000,))
    X_val = torch.randn(200, 1, 28, 28)
    y_val = torch.randint(0, 10, (200,))

    train_loader = DataLoader(TensorDataset(X_train, y_train), batch_size=64, shuffle=True)
    val_loader = DataLoader(TensorDataset(X_val, y_val), batch_size=64)

    model = nn.Sequential(
        nn.Conv2d(1, 16, kernel_size=3, padding=1),
        nn.ReLU(),
        nn.MaxPool2d(2),
        nn.Conv2d(16, 32, kernel_size=3, padding=1),
        nn.ReLU(),
        nn.AdaptiveAvgPool2d((1, 1)),
        nn.Flatten(),
        nn.Linear(32, 10)
    ).to(device)

    criterion = nn.CrossEntropyLoss()
    optimizer = optim.Adam(model.parameters(), lr=1e-3)

    for epoch in range(10):
        train_loss, train_acc = train_one_epoch(model, train_loader, criterion, optimizer, device)
        val_loss, val_acc = evaluate(model, val_loader, criterion, device)
        print(
            f"epoch={epoch+1} "
            f"train_loss={train_loss:.4f} train_acc={train_acc:.4f} "
            f"val_loss={val_loss:.4f} val_acc={val_acc:.4f}"
        )


if __name__ == "__main__":
    main()
|
训练时你应该重点观察什么
- 训练损失是否下降。
- 验证集性能是否同步提升。
- 是否出现明显过拟合。
- 学习率是否合适。
- 数据预处理是否正确。
常见调参方向
如果模型效果不好,可以按这个顺序排查:
- 数据是否正确
- 标签是否正确
- loss 是否正确
- 学习率是否太大或太小
- 模型容量是否合适
- 是否需要正则化与数据增强
推荐学习路线
你如果想真正学会,而不是“看过”,建议按下面路线推进。
阶段 1:基础准备
先补这些:
- Python 基础
- Numpy
- 线性代数
- 概率统计
- 微积分基础
至少要理解:
- 向量、矩阵乘法
- 导数、偏导数、链式法则
- 期望、方差
- 概率分布基本概念
阶段 2:机器学习基础
建议顺序:
- 线性回归
- 逻辑回归
- 决策树
- 随机森林
- SVM
- 聚类和降维
学习目标:
- 知道每个算法解决什么问题
- 知道优缺点
- 能用
scikit-learn 跑通
- 能解释结果
阶段 3:神经网络基础
重点学:
- 感知机
- MLP
- 前向传播
- 反向传播
- 梯度下降
- 激活函数
- 损失函数
- 优化器
阶段 4:CNN
这里要真正练习:
- 手算输出尺寸
- 写简单 CNN
- 跑 MNIST / CIFAR-10
- 观察特征图变化
阶段 5:ResNet
这里重点不是“会调用 torchvision”,而是:
- 明白为什么深层网络难训练
- 明白残差连接本质
- 自己实现 BasicBlock
这里建议分三层学:
第一层:概念
- 注意力是什么
- QKV 是什么
- 为什么能建模长距离关系
第二层:公式
第三层:实现
- 手写 self-attention
- 手写 encoder block
- 用现成模块跑文本分类
阶段 7:项目驱动
做几个小项目:
- MNIST 手写数字分类
- CIFAR-10 图像分类
- IMDB 情感分类
- 简单机器翻译或文本生成
项目能让你发现自己哪些地方“以为懂了,其实没懂”。
附录:你可以立刻开始做的练习
练习 1:手算卷积输出尺寸
输入:64 x 64
卷积参数:
- kernel =
3
- stride =
2
- padding =
1
请你自己算输出尺寸。
练习 2:实现一个两层 CNN
要求:
- 输入
1 x 28 x 28
- 输出 10 类
- 至少包含两层卷积
练习 3:自己实现一个残差块
要求:
- 当输入输出维度不一致时,加入
1x1 shortcut
练习 4:手写 attention
不要调用 nn.MultiheadAttention,自己完成:
练习 5:写出下面问题的答案
- 为什么 CNN 的参数比全连接网络少?
- 为什么 ResNet 可以训练更深?
- 为什么 Transformer 需要位置编码?
- 为什么自注意力复杂度和序列长度平方相关?
如果这些问题你都能讲清楚,并且能手写简化代码,那么你的基础已经相当扎实。